Keypoint Detection
整理关键点检测的坐标回归与热力图两种表示、热力图的生成与亚像素解码、可见性掩码与训练、PCK 和 OKS 指标、坐标映射与翻转增强中的左右互换,以及由二维关键点用 PnP 求解位姿
深度学习系列:第 19 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
- PyTorch Fine-Tuning
- Object Detection
- Image Segmentation
- Keypoint Detection
- Generative Models
关键点检测输出的是目标上若干个有固定含义的点的坐标:人体的关节、人脸的五官、装甲板的角点、零件上的定位孔。它比Object Detection的矩形框多了目标内部的结构,比Image Segmentation的掩码少得多,却正好是几何计算需要的输入:已知这些点在物体上的三维位置和相机内参,就能求出物体相对相机的位姿。本文用一个合成的数据集走完从标注、热力图、训练、评价到求解位姿的流程
任务与表示
坐标回归与热力图
| 表示 | 网络的输出 | 损失 | 特点 |
|---|---|---|---|
| 坐标回归 | 全连接层直接输出 (K, 2) 的坐标 | L1、Smooth L1 | 结构简单,输出不受分辨率限制,能预测图像之外的点;空间信息在展平时丢失,精度通常较低 |
| 热力图 | (K, H/s, W/s) 的图,每个关键点一个通道 | 与高斯目标之间的 MSE | 全卷积,保留空间结构,精度高,峰值可以当作置信度;坐标被输出步长 s 量化,需要解码 |
| 积分回归 | 热力图经 soft-argmax 得到坐标 | 直接对坐标计算 L1 | 解码可导,没有量化误差;对热力图的形状没有直接约束 |
K 是关键点的个数,每个关键点有固定的编号和含义,这一点与检测框不同:输出的第 2 个点永远是“左翼”,不能与第 3 个点互换
图像中有多个目标
| 方式 | 做法 | 特点 |
|---|---|---|
| 自顶向下(top-down) | 先用检测器找到每个目标的框,裁剪并缩放到固定大小,再逐个预测关键点 | 每个目标的尺度被归一化,精度高;耗时与目标数成正比,依赖检测器 |
| 自底向上(bottom-up) | 一次前向得到整张图像上所有的关键点,再把它们分组到各个目标 | 耗时与目标数基本无关;分组容易出错,小目标精度低 |
YOLO 的姿态版这类单阶段模型则在检测头预测框的同时回归这个目标的 K 个关键点。本文的例子每张图像中只有一个目标,相当于自顶向下方法中裁剪之后的那一步
示例数据集
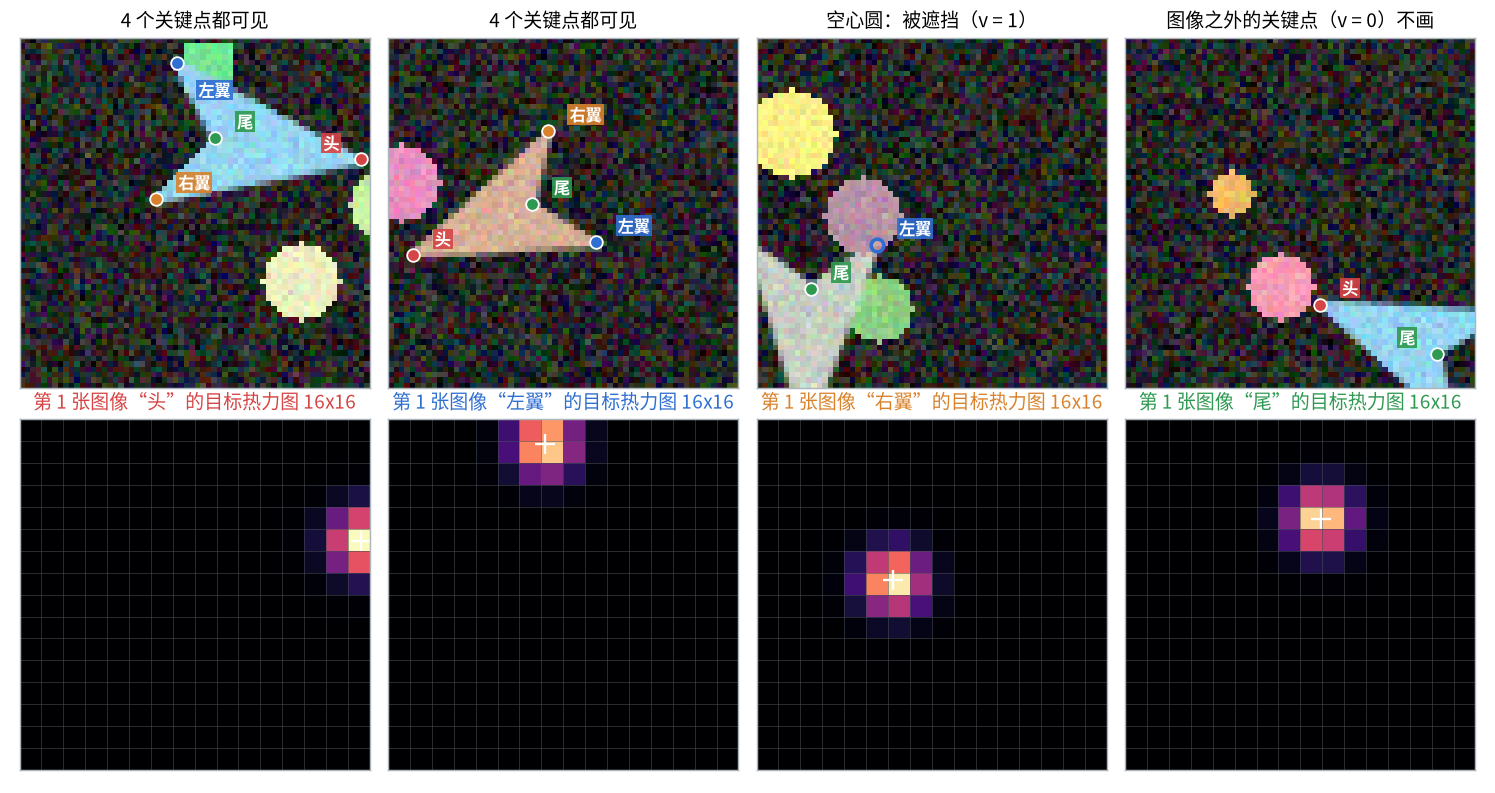
64x64 的噪声背景上有一个方向、位置、大小都随机的飞镖形物体,4 个顶点就是关键点:头、左翼、右翼、尾。物体是左右对称的,颜色随机,左翼和右翼只能靠“朝着头部看时在哪一侧”来区分。图像中还有颜色随机的圆和矩形作为干扰,其中一个圆可能遮住关键点;物体的中心靠近边缘时,一部分关键点会落在图像之外。保存为darts.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
import cv2
import numpy as np
import torch
from torch.utils.data import Dataset

NAMES = ['头', '左翼', '右翼', '尾']
FLIP_PAIRS = [(1, 2)]  # 水平翻转后需要互换的关键点
# 物体坐标系下的模板,单位是物体的长度:x 轴指向头部。图像的 y 轴向下,朝着头部看时左侧的 y 为负
TEMPLATE = np.array([[0.6, 0.0], [-0.4, -0.35], [-0.4, 0.35], [-0.15, 0.0]])
AREA = 0.2625  # 模板多边形的面积,乘以长度的平方得到像素面积


def make_sample(rng, size=64):
    """返回 image: (size, size, 3) uint8,kpts: (4, 2) 的 (x, y) 坐标,vis: (4,),length: 物体的长度(像素)"""
    image = rng.integers(0, 80, (size, size, 3)).astype(np.uint8)
    for _ in range(2):  # 干扰物:颜色随机的圆和矩形,画在物体的下面
        cx, cy, r = (int(v) for v in rng.integers([0, 0, 4], [size, size, 9]))
        color = rng.integers(100, 256, 3).tolist()
        if rng.random() < 0.5:
            cv2.circle(image, (cx, cy), r, color, -1)
        else:
            cv2.rectangle(image, (cx - r, cy - r), (cx + r, cy + r), color, -1)

    length = rng.uniform(22, 40)
    angle = rng.uniform(0, 2 * np.pi)
    center = rng.uniform(8, size - 8, 2)
    rotation = np.array([[np.cos(angle), -np.sin(angle)], [np.sin(angle), np.cos(angle)]])
    kpts = TEMPLATE @ rotation.T * length + center  # (4, 2),整数坐标位于像素中心
    polygon = np.round(kpts[[0, 1, 3, 2]] * 16).astype(np.int32)  # shift=4:坐标乘以 16 后取整,保留亚像素精度
    cv2.fillPoly(image, [polygon], rng.integers(100, 256, 3).tolist(), lineType=cv2.LINE_AA, shift=4)

    occluder = np.zeros((size, size), np.uint8)
    if rng.random() < 0.5:  # 一半的图像中在某个关键点附近再画一个圆,可能把它遮住
        cx, cy = (int(v) for v in kpts[rng.integers(4)] + rng.normal(0, 5, 2))
        cv2.circle(occluder, (cx, cy), int(rng.integers(4, 8)), 1, -1)
        image[occluder == 1] = rng.integers(100, 256, 3)
    image = np.clip(image + rng.normal(0, 12, image.shape), 0, 255).astype(np.uint8)

    # 可见性沿用 COCO 的约定:0 没有标注(这里是落在图像之外),1 有标注但被遮挡,2 可见
    vis = np.zeros(4, np.int64)
    for k, (x, y) in enumerate(kpts):
        if -0.5 <= x < size - 0.5 and -0.5 <= y < size - 0.5:
            vis[k] = 1 if occluder[int(round(y)), int(round(x))] else 2
    return image, kpts.astype(np.float32), vis, np.float32(length)


class DartDataset(Dataset):
    def __init__(self, count, seed):
        rng = np.random.default_rng(seed)
        samples = [make_sample(rng) for _ in range(count)]
        self.images = torch.from_numpy(np.stack([s[0] for s in samples])).permute(0, 3, 1, 2)  # (count, 3, 64, 64) uint8
        self.kpts = torch.from_numpy(np.stack([s[1] for s in samples]))     # (count, 4, 2) float32
        self.vis = torch.from_numpy(np.stack([s[2] for s in samples]))      # (count, 4) int64
        self.length = torch.from_numpy(np.stack([s[3] for s in samples]))   # (count,) float32

    def __len__(self):
        return len(self.images)

    def __getitem__(self, index):
        return self.images[index].float() / 255, self.kpts[index], self.vis[index], self.length[index]


if __name__ == '__main__':
    dataset = DartDataset(4000, seed=0)
    image, kpts, vis, length = dataset[0]
    print(image.shape, kpts.shape, vis.tolist(), round(length.item(), 1))
    counts = torch.bincount(dataset.vis.flatten(), minlength=3)
    for name, ratio in zip(['图像之外', '被遮挡', '可见'], counts / counts.sum()):
        print(f'{name} {ratio:.1%}')
1
2
3
4
torch.Size([3, 64, 64]) torch.Size([4, 2]) [2, 2, 2, 2] 36.0
图像之外 12.8%
被遮挡 5.2%
可见 82.1%
- 坐标的约定:整数坐标位于像素的中心,图像左上角那个像素的中心是 (0, 0),这也是 OpenCV 绘图函数的约定。
cv2.fillPoly的shift=4让多边形的顶点可以取小数,标注因此是亚像素精度的 - 关键点的标注是 (x, y, v) 三个数,v 的取值沿用 COCO 的约定:0 表示没有标注,坐标没有意义;1 表示有标注但被遮挡,位置可以由物体的其余部分推断;2 表示可见
- 12.8% 的关键点在图像之外(v 为 0),这些点不能参与损失的计算
热力图
生成目标
每个关键点对应一张热力图,以关键点的位置为中心画一个峰值为 1 的二维高斯函数。热力图的分辨率是输入的 1/s,s 称为输出步长。二维高斯函数可以拆成 x 和 y 两个方向的一维高斯函数相乘,不需要循环。几种解码方法也放在同一个文件heatmaps.py中
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
import torch
import torch.nn.functional as F


def render_heatmaps(kpts, size=64, stride=4, sigma=1.0):
    """kpts: (N, K, 2) 输入图像上的 (x, y)。返回 (N, K, size/stride, size/stride) 的热力图,峰值为 1"""
    u = (kpts + 0.5) / stride - 0.5  # 输入图像坐标 -> 热力图坐标,两者的整数坐标都位于像素中心
    grid = torch.arange(size // stride, dtype=kpts.dtype, device=kpts.device)
    gx = torch.exp(-(grid - u[..., 0, None]) ** 2 / (2 * sigma ** 2))  # (N, K, W)
    gy = torch.exp(-(grid - u[..., 1, None]) ** 2 / (2 * sigma ** 2))  # (N, K, H)
    return gy[..., :, None] * gx[..., None, :]


def to_image(u, stride=4):
    """热力图坐标 -> 输入图像坐标"""
    return (u + 0.5) * stride - 0.5


def decode_argmax(heatmaps):
    """heatmaps: (N, K, H, W)。返回最大值所在的格子 (N, K, 2),顺序为 (x, y),以及最大值 (N, K)"""
    width = heatmaps.shape[-1]
    score, index = heatmaps.flatten(2).max(dim=2)
    return torch.stack([index % width, index // width], dim=2).float(), score


def neighbours(heatmaps, offset):
    """取出最大值周围的值:offset 为 (dx, dy),越界时取边界上的值"""
    n, k, h, w = heatmaps.shape
    peak, _ = decode_argmax(heatmaps)
    x = (peak[..., 0].long() + offset[0]).clamp(0, w - 1)
    y = (peak[..., 1].long() + offset[1]).clamp(0, h - 1)
    return heatmaps.flatten(2).gather(2, (y * w + x)[..., None])[..., 0]  # (N, K)


def decode_quarter(heatmaps):
    """向较大的相邻格子移动 1/4 个格子"""
    peak, score = decode_argmax(heatmaps)
    dx = neighbours(heatmaps, (1, 0)) - neighbours(heatmaps, (-1, 0))
    dy = neighbours(heatmaps, (0, 1)) - neighbours(heatmaps, (0, -1))
    return peak + 0.25 * torch.stack([dx.sign(), dy.sign()], dim=2), score


def decode_parabola(heatmaps, eps=1e-6):
    """对最大值和左右(上下)两个邻居的对数做抛物线拟合,取抛物线的顶点。高斯函数的对数正好是抛物线"""
    peak, score = decode_argmax(heatmaps)
    center = neighbours(heatmaps, (0, 0)).clamp_min(eps).log()
    offsets = []
    for axis in [(1, 0), (0, 1)]:
        right = neighbours(heatmaps, axis).clamp_min(eps).log()
        left = neighbours(heatmaps, (-axis[0], -axis[1])).clamp_min(eps).log()
        curvature = (left + right - 2 * center).clamp_max(-eps)
        offsets.append((0.5 * (left - right) / curvature).clamp(-0.5, 0.5))
    return peak + torch.stack(offsets, dim=2), score


def decode_soft_argmax(heatmaps, beta=10.0):
    """对整张热力图做 softmax,再求坐标的期望。可导,可以直接用坐标计算损失"""
    n, k, h, w = heatmaps.shape
    prob = F.softmax(beta * heatmaps.flatten(2), dim=2).view(n, k, h, w)
    x = (prob.sum(dim=2) * torch.arange(w, device=prob.device)).sum(dim=2)
    y = (prob.sum(dim=3) * torch.arange(h, device=prob.device)).sum(dim=2)
    return torch.stack([x, y], dim=2), heatmaps.flatten(2).max(dim=2).values
输入图像上的坐标 x 与热力图上的坐标 u 之间的换算不是简单地除以步长。两者的整数坐标都在像素中心,热力图的第 0 个格子覆盖输入图像的第 0 到第 s-1 个像素,它的中心在 (s-1)/2 处:
\[u = \frac{x + 0.5}{s} - 0.5, \qquad x = (u + 0.5) \, s - 0.5\]| 参数 | 常用的取值 | 影响 |
|---|---|---|
| 输出步长 | 4(如 256x192 的输入、64x48 的热力图) | 越小量化误差越小,热力图的像素数和解码器的计算量按平方增长 |
sigma | 1 到 3 个热力图格子,随热力图的分辨率增大 | 太小则目标几乎全是 0,正样本太少难以训练;太大则峰变得平坦,定位不准,相邻的关键点互相重叠 |
解码
| 方法 | 做法 | 是否可导 |
|---|---|---|
| argmax | 取最大值所在的格子 | 否 |
| 1/4 偏移 | 在 argmax 的基础上,向左右(上下)两个邻居中较大的一侧移动 1/4 格 | 否 |
| 抛物线拟合 | 对最大值及其两个邻居的对数拟合抛物线,取顶点 | 否 |
| soft-argmax | 对整张热力图做 softmax 得到概率,再求坐标的期望 | 是 |
在随机位置生成 2000 张热力图,分别用 4 种方法解码,统计与真实位置之间的平均距离(换算到输入图像的像素)。每组两个数分别是没有噪声的热力图和加上标准差为 0.05 的高斯噪声之后的结果
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import torch

from heatmaps import decode_argmax, decode_parabola, decode_quarter, decode_soft_argmax, render_heatmaps, to_image

torch.manual_seed(0)
kpts = torch.rand(2000, 1, 2) * 48 + 8  # (N, K, 2),关键点均匀分布在 64x64 图像的中间区域
print(render_heatmaps(kpts).shape)      # torch.Size([2000, 1, 16, 16])

configs = [(4, 1.0), (4, 2.0), (2, 2.0)]  # (stride, sigma),sigma 以热力图的格子为单位
print(' ' * 13 + '    '.join(f'stride {stride} sigma {sigma:.0f}' for stride, sigma in configs))
for name, decode in [('argmax     ', decode_argmax), ('1/4 偏移   ', decode_quarter), ('抛物线拟合 ', decode_parabola),
                     ('soft-argmax', decode_soft_argmax)]:
    cells = []
    for stride, sigma in configs:
        torch.manual_seed(1)
        clean = render_heatmaps(kpts, stride=stride, sigma=sigma)
        noisy = clean + 0.05 * torch.randn_like(clean)  # 模拟网络输出的不完美
        errors = [(to_image(decode(h)[0], stride) - kpts).norm(dim=2).mean() for h in (clean, noisy)]
        cells.append(f'{errors[0]:.3f} / {errors[1]:.3f}')
    print(f'{name}  ' + '      '.join(cells))

# 忘记半个像素的偏移:直接乘以 stride
peak, _ = decode_argmax(render_heatmaps(kpts))
print([round(v, 2) for v in (peak * 4 - kpts).mean(dim=(0, 1)).tolist()])
print([round(v, 2) for v in (to_image(peak) - kpts).mean(dim=(0, 1)).tolist()])
1
2
3
4
5
6
7
8
torch.Size([2000, 1, 16, 16])
             stride 4 sigma 1    stride 4 sigma 2    stride 2 sigma 2
argmax       1.526 / 1.573      1.526 / 1.998      0.762 / 1.010
1/4 偏移     0.762 / 0.838      0.762 / 1.311      0.378 / 0.662
抛物线拟合   0.000 / 0.334      0.000 / 1.006      0.000 / 0.512
soft-argmax  0.600 / 0.716      0.083 / 0.484      0.294 / 0.383
[-1.47, -1.48]
[0.03, 0.02]
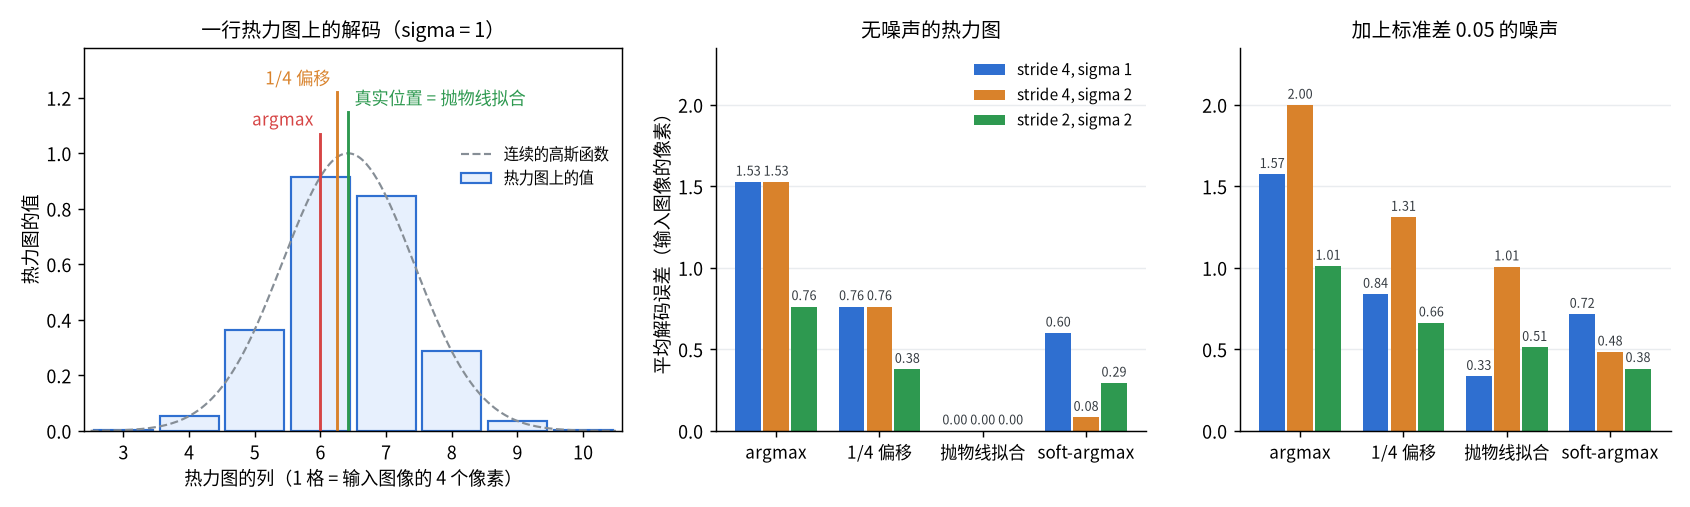
- argmax 只能落在格子的中心。输出步长为 4 时,即使热力图完全正确,平均也有 1.526 个像素的误差;步长减到 2,误差减半。1/4 偏移同样把量化误差减半,实现最简单,是 Hourglass、SimpleBaseline 等模型的默认做法
- 高斯函数的对数正好是抛物线,所以抛物线拟合在没有噪声时是精确的。有噪声时它只用到 3 个值,
sigma越大峰越平坦,这 3 个值之间的差越小,越容易被噪声淹没:sigma从 1 增大到 2,误差从 0.334 升到 1.006 - soft-argmax 用到了整张热力图。
sigma为 1 时峰太窄,大量接近 0 的背景格子经过 softmax 后仍有不小的权重,把期望拉向图像中心,误差为 0.600;sigma为 2 时这个偏差很小,而且对噪声最不敏感 - 最后两行是 argmax 结果的平均偏移。把热力图坐标直接乘以步长,结果会整体向左上偏 1.5 个像素(即 (s-1)/2);按上面的公式换算则没有系统偏差
模型与训练
热力图模型是一个小型的编码器加解码器:编码器下采样 3 次,解码器上采样 1 次并与编码器中 1/4 分辨率的特征拼接(结构与Image Segmentation中的 U-Net 相同,只是少了两级解码),输出 4 个通道、16x16 的热力图。作为对比的坐标回归模型使用同样的编码器,把 1/8 分辨率的特征展平后用全连接层输出 8 个数。两者的参数量分别为 437940 和 561432,保存为models.py
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
import torch
import torch.nn as nn


def conv_block(in_channels, out_channels):
    return nn.Sequential(
        nn.Conv2d(in_channels, out_channels, 3, padding=1, bias=False), nn.BatchNorm2d(out_channels), nn.ReLU(inplace=True),
        nn.Conv2d(out_channels, out_channels, 3, padding=1, bias=False), nn.BatchNorm2d(out_channels), nn.ReLU(inplace=True),
    )


class Encoder(nn.Module):
    def __init__(self, base=16):  # 两个模型共用的编码器:3 次下采样,输出 1/4 和 1/8 分辨率的特征
        super().__init__()
        self.stage1 = conv_block(3, base)
        self.stage2 = conv_block(base, base * 2)
        self.stage3 = conv_block(base * 2, base * 4)
        self.stage4 = conv_block(base * 4, base * 8)
        self.pool = nn.MaxPool2d(2)

    def forward(self, x):
        x = self.stage2(self.pool(self.stage1(x)))  # (N, 32, 32, 32)
        c3 = self.stage3(self.pool(x))              # (N, 64, 16, 16)
        c4 = self.stage4(self.pool(c3))             # (N, 128, 8, 8)
        return c3, c4


class HeatmapNet(nn.Module):
    def __init__(self, num_keypoints=4, base=16):  # 输出 (N, K, 16, 16) 的热力图,输出步长为 4
        super().__init__()
        self.encoder = Encoder(base)
        self.up = nn.ConvTranspose2d(base * 8, base * 4, kernel_size=2, stride=2)
        self.fuse = conv_block(base * 8, base * 4)
        self.head = nn.Conv2d(base * 4, num_keypoints, kernel_size=1)

    def forward(self, x):
        c3, c4 = self.encoder(x)
        x = self.fuse(torch.cat([self.up(c4), c3], dim=1))  # (N, 64, 16, 16)
        return self.head(x)


class RegressionNet(nn.Module):
    def __init__(self, num_keypoints=4, base=16):  # 输出 (N, K, 2) 的坐标,已除以图像边长
        super().__init__()
        self.encoder = Encoder(base)
        self.reduce = nn.Sequential(nn.Conv2d(base * 8, 32, kernel_size=1), nn.ReLU(inplace=True))
        self.head = nn.Sequential(nn.Flatten(), nn.Linear(32 * 8 * 8, 128), nn.ReLU(inplace=True),
                                  nn.Linear(128, num_keypoints * 2))
        self.num_keypoints = num_keypoints

    def forward(self, x):
        _, c4 = self.encoder(x)
        return self.head(self.reduce(c4)).view(-1, self.num_keypoints, 2)
两个模型的损失都要乘上可见性掩码:v 为 0 的关键点没有标注,它的热力图通道(或坐标)不参与计算。训练的写法见PyTorch Training
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
import torch
import torch.nn.functional as F
from torch.utils.data import DataLoader

from darts import DartDataset
from heatmaps import decode_parabola, render_heatmaps, to_image
from models import HeatmapNet, RegressionNet


def heatmap_loss(output, kpts, vis):
    target = render_heatmaps(kpts)                 # (N, K, 16, 16)
    weight = (vis > 0).float()[:, :, None, None]   # 没有标注的关键点不计算损失
    return ((output - target) ** 2 * weight).sum() / (weight.sum() * target[0, 0].numel())


def regression_loss(output, kpts, vis):
    weight = (vis > 0).float()[:, :, None]
    return (F.smooth_l1_loss(output, kpts / 64, reduction='none', beta=0.05) * weight).sum() / (weight.sum() * 2)


@torch.no_grad()
def predict(model, images):
    """返回输入图像坐标系下的关键点 (N, K, 2)"""
    model.eval()
    output = torch.cat([model(batch) for batch in images.split(500)])
    if output.dim() == 4:
        return to_image(decode_parabola(output)[0])
    return output * 64


if __name__ == '__main__':
    assert torch.cuda.is_available(), '这个例子需要GPU'
    device = torch.device('cuda')
    train_set, test_set = DartDataset(4000, seed=0), DartDataset(1000, seed=1)
    test_images = (test_set.images.float() / 255).to(device)
    labelled = test_set.vis > 0

    epochs = 20
    for name, model_class, loss_fn in [('heatmap', HeatmapNet, heatmap_loss), ('regression', RegressionNet, regression_loss)]:
        torch.manual_seed(0)
        model = model_class().to(device)
        loader = DataLoader(train_set, batch_size=64, shuffle=True)
        optimizer = torch.optim.AdamW(model.parameters(), lr=2e-3, weight_decay=1e-4)
        scheduler = torch.optim.lr_scheduler.OneCycleLR(optimizer, max_lr=2e-3, total_steps=epochs * len(loader))
        for epoch in range(epochs):
            model.train()
            for images, kpts, vis, _ in loader:
                images, kpts, vis = images.to(device), kpts.to(device), vis.to(device)
                loss = loss_fn(model(images), kpts, vis)
                optimizer.zero_grad()
                loss.backward()
                optimizer.step()
                scheduler.step()
            if (epoch + 1) % 5 == 0:
                error = (predict(model, test_images).cpu() - test_set.kpts).norm(dim=2)[labelled].mean()
                print(f'{name:10s}  epoch {epoch + 1:2d}  loss {loss.item():.5f}  平均误差 {error:.3f} 像素')
        torch.save(model.cpu().state_dict(), f'{name}.pt')
1
2
3
4
5
6
7
8
heatmap     epoch  5  loss 0.00311  平均误差 3.240 像素
heatmap     epoch 10  loss 0.00055  平均误差 0.993 像素
heatmap     epoch 15  loss 0.00034  平均误差 0.857 像素
heatmap     epoch 20  loss 0.00029  平均误差 0.801 像素
regression  epoch  5  loss 0.02683  平均误差 5.364 像素
regression  epoch 10  loss 0.00398  平均误差 2.359 像素
regression  epoch 15  loss 0.00206  平均误差 1.679 像素
regression  epoch 20  loss 0.00104  平均误差 1.572 像素
以上结果在一台 CPU 为 Intel Core Ultra 9 285K、GPU 为 GeForce RTX 5090 D(32 GB 显存)、内存为 64 GB 的机器上得到,两个模型各训练 20 个 epoch,各需要不到 10 秒。在 GPU 上即使固定了随机种子,每次运行的结果也略有不同(原因见PyTorch Checkpoints and Reproducibility):重复运行时热力图模型的最终误差在 0.80 上下,回归模型在 1.57 上下,下文的数字都来自上面这一次运行保存的权重
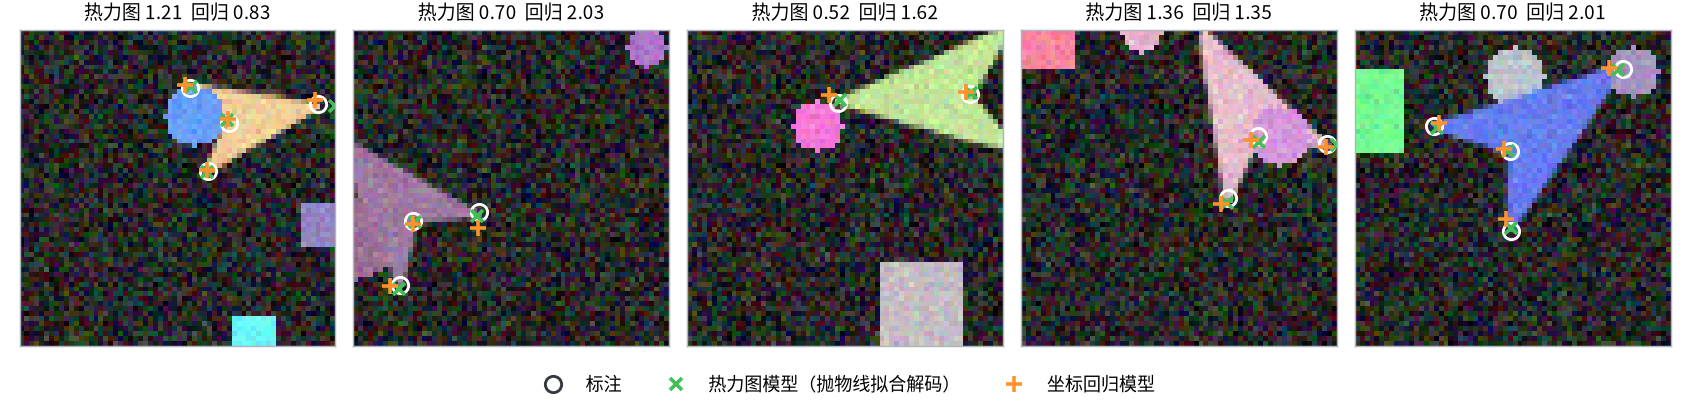
- 在测试集的 1000 张图像上,热力图模型的平均误差为 0.801 个像素,坐标回归模型为 1.572 个像素,约为前者的 2 倍
- 没有标注的点在标注文件中通常记为 (0, 0, 0),不用掩码会让模型在左上角学出一个假的峰
- 回归模型可以对图像之外的点给出坐标,热力图模型不能:热力图的范围就是图像的范围
评价指标
平均像素误差与目标的大小有关:同样是 2 个像素,对长 40 像素的目标和长 400 像素的目标意义完全不同。关键点检测的指标都会用目标的尺度做归一化
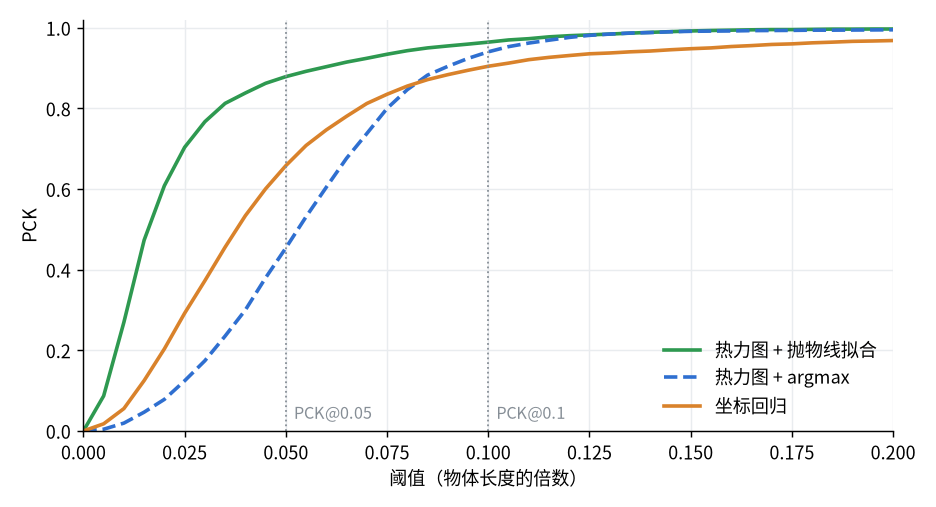
PCK(Percentage of Correct Keypoints)是误差不超过阈值的关键点所占的比例,阈值取目标尺度的若干倍,尺度常用检测框的长边。OKS(Object Keypoint Similarity)给每个目标一个 0 到 1 的相似度,作用相当于检测中的 IoU:
\[\mathrm{OKS} = \frac{\sum_i \exp\left( -\dfrac{d_i^2}{2 s^2 k_i^2} \right) \delta(v_i > 0)}{\sum_i \delta(v_i > 0)}\]- $d_i$是第 i 个关键点的预测与标注之间的距离
- $s^2$是目标的面积(像素),COCO 中取分割掩码的面积。目标越大,同样的误差扣分越少:标注标准差取 0.1 时,2 个像素的误差在面积为 150 的目标上得 0.717,在面积为 400 的目标上得 0.882
- $k_i$是每个关键点的常数,等于 2 倍的标注标准差。COCO 由多名标注者对同一个点的标注偏差统计得到,眼睛最小(0.025 的 2 倍),髋部最大(0.107 的 2 倍):位置本身越模糊的点,容许的误差越大
- 只有 v 大于 0 的关键点参与计算
COCO 关键点任务的 AP 就是把Object Detection中 mAP 的匹配准则由 IoU 换成 OKS:OKS 不低于阈值的预测算作 TP,再在 0.5 到 0.95 的 10 个阈值上取平均。AP 的计算过程不变,见Evaluation Metrics
下面实现这两个指标,在测试集上评估两个模型。PCK 的尺度取物体的长度,OKS 的面积取多边形的面积,常数是为这个例子指定的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
import torch

from darts import AREA, DartDataset
from heatmaps import decode_argmax, to_image
from models import HeatmapNet, RegressionNet
from train import predict

SIGMAS = torch.tensor([0.05, 0.07, 0.07, 0.07])  # 每个关键点的常数:头部是尖角,位置最明确,取得最小


def pck(pred, target, vis, length, alpha):
    """误差不超过 alpha 倍物体长度的关键点所占的比例,只统计有标注的关键点"""
    distance = (pred - target).norm(dim=2)  # (N, K)
    return (distance <= alpha * length[:, None])[vis > 0].float().mean().item()


def oks(pred, target, vis, area, sigmas=SIGMAS):
    """每个目标一个 0 到 1 之间的相似度 (N,)"""
    d2 = ((pred - target) ** 2).sum(dim=2)                             # (N, K)
    similarity = torch.exp(-d2 / (2 * area[:, None] * (2 * sigmas) ** 2))
    labelled = (vis > 0).float()
    return (similarity * labelled).sum(dim=1) / labelled.sum(dim=1)


if __name__ == '__main__':
    test_set = DartDataset(1000, seed=1)
    images, target, vis, length = test_set.images.float() / 255, test_set.kpts, test_set.vis, test_set.length
    area = AREA * length ** 2

    heatmap_net, regression_net = HeatmapNet(), RegressionNet()
    heatmap_net.load_state_dict(torch.load('heatmap.pt'))
    regression_net.load_state_dict(torch.load('regression.pt'))
    with torch.no_grad():
        coarse = to_image(decode_argmax(heatmap_net.eval()(images))[0])
    results = [('热力图 + argmax    ', coarse), ('热力图 + 抛物线拟合', predict(heatmap_net, images)),
               ('坐标回归           ', predict(regression_net, images))]

    for name, pred in results:
        error = (pred - target).norm(dim=2)
        similarity = oks(pred, target, vis, area)
        print(f'{name}  误差 可见 {error[vis == 2].mean():.2f} 被遮挡 {error[vis == 1].mean():.2f}'
              f'  PCK@0.05 {pck(pred, target, vis, length, 0.05):.3f}  PCK@0.1 {pck(pred, target, vis, length, 0.1):.3f}'
              f'  OKS 平均 {similarity.mean():.3f}  OKS≥0.5 {(similarity >= 0.5).float().mean():.3f}'
              f'  OKS≥0.75 {(similarity >= 0.75).float().mean():.3f}')
1
2
3
热力图 + argmax      误差 可见 1.68 被遮挡 2.07  PCK@0.05 0.454  PCK@0.1 0.941  OKS 平均 0.696  OKS≥0.5 0.897  OKS≥0.75 0.399
热力图 + 抛物线拟合  误差 可见 0.76 被遮挡 1.34  PCK@0.05 0.879  PCK@0.1 0.965  OKS 平均 0.895  OKS≥0.5 0.991  OKS≥0.75 0.887
坐标回归             误差 可见 1.55 被遮挡 1.90  PCK@0.05 0.658  PCK@0.1 0.905  OKS 平均 0.745  OKS≥0.5 0.873  OKS≥0.75 0.646
- 同一个热力图模型,只是解码方式不同,PCK@0.05 从 0.454 变为 0.879。不做亚像素解码时,热力图模型在严格的阈值下还不如坐标回归
- 宽松的阈值看不出差别:PCK@0.1 下三者都在 0.9 以上,PCK@0.05 和 OKS≥0.75 才把它们拉开。报告结果时要写明阈值和归一化用的尺度
- 被遮挡的关键点误差更大(1.34 对 0.76),但仍在 2 个像素以内,模型确实能从物体的其余部分推断出它们的位置
坐标映射与翻转
映射回原图
网络输出的坐标属于它的输入图像。自顶向下的方法中输入是从原图上裁剪并缩放得到的,关键点要按相反的顺序映射回去:先乘以缩放比例,再加上裁剪框的左上角;用了等比例缩放加填充时还要先减去填充量,与Object Detection中坐标映射一节对检测框的处理相同。裁剪框左上角的横坐标为 x0、裁剪区域的边长是网络输入的 r 倍时(y 方向相同):
\[x_{orig} = (x_{in} + 0.5) \, r - 0.5 + x_0\]用 200 张 640x480 的图像验证:每张图像中有一个长 150 像素的目标,裁剪出 320x320 的区域并缩小到 64x64(r 为 5)后送入上面的热力图模型,再把预测映射回原图
| 映射方式 | 平均误差(原图像素) | 平均偏移 (x, y) |
|---|---|---|
| 按上式 | 5.62 | (0.42, -0.21) |
| 直接乘以 r 再加左上角 | 6.09 | (-1.58, -2.21) |
- 直接乘以比例的结果整体向左上偏了 2 个像素,即 (r - 1) / 2,与解码时忘记半个像素是同一个错误。缩放比例越大,这个偏差越大
- 输入图像上 1 个像素左右的误差,映射回原图后放大了 5 倍。裁剪框应当尽量贴紧目标,让目标占满网络的输入
水平翻转
水平翻转是最常用的数据增强,对关键点却有一个特有的问题:翻转之后,图像中的左翼在物体的右侧,它的标注应当变成“右翼”。只翻转 x 坐标而不互换左右成对的关键点,标签就是错的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import torch

from darts import FLIP_PAIRS, DartDataset
from heatmaps import decode_parabola, to_image
from models import HeatmapNet

test_set = DartDataset(1000, seed=1)
images, kpts, vis = test_set.images.float() / 255, test_set.kpts, test_set.vis
width = images.shape[-1]
swap = list(range(kpts.shape[1]))
for a, b in FLIP_PAIRS:
    swap[a], swap[b] = b, a


def left_is_left(kpts):
    """朝着头部看,左翼是否在左侧:用 尾->头 与 尾->左翼 两个向量的叉积的符号判断"""
    head, left = kpts[:, 0] - kpts[:, 3], kpts[:, 1] - kpts[:, 3]
    return (head[:, 0] * left[:, 1] - head[:, 1] * left[:, 0] < 0).float().mean().item()


flipped_images = images.flip(-1)
wrong = kpts.clone()
wrong[..., 0] = width - 1 - wrong[..., 0]  # 错误:只翻转了 x 坐标
right = wrong[:, swap]  # 正确:再把左翼和右翼互换,可见性也要按同样的顺序换(vis[:, swap])
print(left_is_left(kpts), left_is_left(wrong), left_is_left(right))

model = HeatmapNet()
model.load_state_dict(torch.load('heatmap.pt'))
model.eval()
with torch.no_grad():
    heatmaps = model(images)
    flipped_heatmaps = model(flipped_images)


def mean_error(heatmaps):
    return (to_image(decode_parabola(heatmaps)[0]) - kpts).norm(dim=2)[vis > 0].mean().item()


# 翻转测试:把翻转图像的热力图翻转回来,与原图的热力图取平均
print(f'只用原图              {mean_error(heatmaps):.3f}')
print(f'翻转测试,没有交换通道 {mean_error((heatmaps + flipped_heatmaps.flip(-1)) / 2):.3f}')
print(f'翻转测试,交换通道     {mean_error((heatmaps + flipped_heatmaps.flip(-1)[:, swap]) / 2):.3f}')
1
2
3
4
1.0 0.0 1.0
只用原图              0.801
翻转测试,没有交换通道 5.042
翻转测试,交换通道     0.720
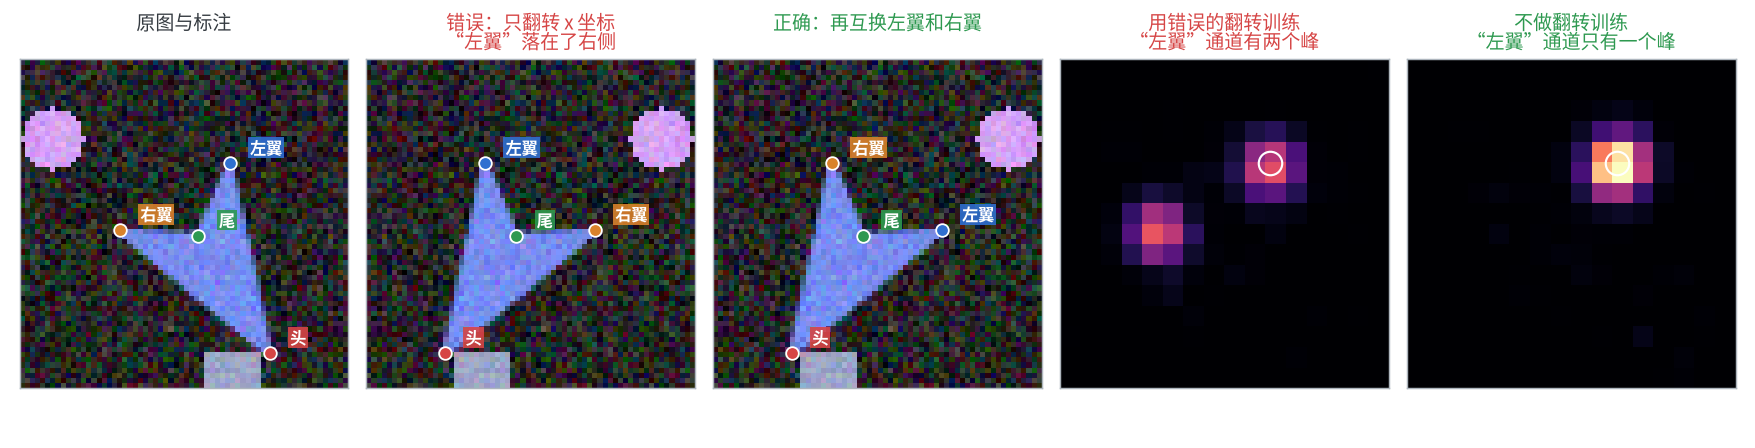
left_is_left检查标注是否自洽:原始标注全部为真(1.0),只翻转 x 坐标后全部为假(0.0),互换左翼和右翼后恢复为 1.0- 推理时常用的翻转测试(把原图和翻转图像的热力图取平均)也要互换通道。不互换时误差从 0.801 升到 5.042,正确互换后降到 0.720
- 训练时用错误的翻转做增强(一半的样本只翻转 x 坐标),同样训练 20 个 epoch,头和尾的误差仍为 0.93 和 0.57 个像素,左翼和右翼的误差分别为 9.82 和 10.29 个像素:模型无法区分两者,这两个通道上各有两个峰。正确互换时四个点的误差为 0.90、0.87、0.84、0.53
- 垂直翻转、旋转 180 度是否需要互换取决于关键点的定义,写增强时用上面这样的几何检查验证一遍。人体的 17 个关键点中有 8 对需要互换
从关键点到位姿
关键点在物体坐标系下的三维坐标是已知的(来自 CAD 模型或测量),相机内参 K 由标定得到,物体到相机的旋转 R 和平移 t 满足投影关系:
\[\lambda \begin{bmatrix} u \\ v \\ 1 \end{bmatrix} = K \left( R \, X + t \right)\]由若干组三维点 X 和对应的像素坐标 (u, v) 求 R 和 t 称为 PnP(Perspective-n-Point)问题,至少需要 4 个点,OpenCV 中用cv2.solvePnP求解。R 和 t 组成的齐次变换矩阵见Homogeneous Transformation Matrix,由视场角计算焦距见Field of View。下面把 4 个关键点当作一个长 0.2 m 的平面物体上的点,用随机的位姿投影到图像上,加上不同大小的像素噪声后再求解,统计 500 次的误差。SOLVEPNP_IPPE是针对共面点的解法,点不共面时用默认的SOLVEPNP_ITERATIVE
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
import cv2
import numpy as np

# 物体坐标系下 4 个关键点的三维坐标(米):长 0.2 m 的平面物体,z 都为 0
model_points = np.array([[0.12, 0.0, 0.0], [-0.08, -0.07, 0.0], [-0.08, 0.07, 0.0], [-0.03, 0.0, 0.0]])
# 相机内参:640x480,水平视场角 60 度,没有畸变
fx = 640 / 2 / np.tan(np.radians(60) / 2)
K = np.array([[fx, 0, 320], [0, fx, 240], [0, 0, 1]])
dist = np.zeros(5)

rng = np.random.default_rng(0)
for distance in [0.5, 1.5]:
    for noise in [0.0, 0.5, 2.0]:
        rotation_errors, translation_errors = [], []
        for _ in range(500):
            # 随机的真实位姿:旋转角不超过 60 度,物体在光轴附近
            rvec = rng.normal(size=3)
            rvec *= rng.uniform(0, np.pi / 3) / np.linalg.norm(rvec)
            tvec = np.array([rng.uniform(-0.1, 0.1), rng.uniform(-0.1, 0.1), distance])
            pixels, _ = cv2.projectPoints(model_points, rvec, tvec, K, dist)  # (4, 1, 2)
            pixels = pixels + rng.normal(0, noise, pixels.shape)             # 关键点的检测误差

            ok, rvec_est, tvec_est = cv2.solvePnP(model_points, pixels, K, dist, flags=cv2.SOLVEPNP_IPPE)
            R, R_est = cv2.Rodrigues(rvec)[0], cv2.Rodrigues(rvec_est)[0]
            cos = (np.trace(R_est @ R.T) - 1) / 2  # 两个旋转矩阵之间的夹角
            rotation_errors.append(np.degrees(np.arccos(np.clip(cos, -1, 1))))
            translation_errors.append(np.linalg.norm(tvec_est.ravel() - tvec) * 1000)
        print(f'距离 {distance} m  像素噪声 {noise}  旋转误差中位数 {np.median(rotation_errors):5.2f} 度'
              f'  平移误差中位数 {np.median(translation_errors):5.1f} mm')
1
2
3
4
5
6
距离 0.5 m  像素噪声 0.0  旋转误差中位数  0.00 度  平移误差中位数   0.0 mm
距离 0.5 m  像素噪声 0.5  旋转误差中位数  2.17 度  平移误差中位数   2.2 mm
距离 0.5 m  像素噪声 2.0  旋转误差中位数  7.89 度  平移误差中位数   8.7 mm
距离 1.5 m  像素噪声 0.0  旋转误差中位数  0.00 度  平移误差中位数   0.0 mm
距离 1.5 m  像素噪声 0.5  旋转误差中位数  7.18 度  平移误差中位数  21.7 mm
距离 1.5 m  像素噪声 2.0  旋转误差中位数 31.95 度  平移误差中位数  88.0 mm
- 没有噪声时位姿被精确地恢复,但位姿对关键点的误差很敏感。物体在 0.5 m 处成像约 220 个像素宽,0.5 个像素的噪声带来 2.17 度的旋转误差;在 1.5 m 处只有约 74 个像素宽,同样的噪声带来 7.18 度和 21.7 mm 的误差。关键点的亚像素精度直接决定了位姿的精度
- 4 个共面的点是最低限度的配置,误差主要来自物体平面的倾斜方向难以确定。增加关键点的个数、选择不共面的点、让目标在图像中更大,都能明显改善;关键点中可能有错误的检测时用
cv2.solvePnPRansac - 送入
solvePnP的像素坐标必须在标定内参所用的原始图像坐标系下,也就是上一节映射回原图之后的坐标;镜头有畸变时还要传入畸变系数
torchvision 的 Keypoint R-CNN
torchvision.models.detection.keypointrcnn_resnet50_fpn是一个自顶向下的模型:在 Faster R-CNN 的基础上增加一个关键点分支,对每个检测到的框输出 K 张热力图。预训练权重在 COCO 的人体关键点上训练,K 为 17。下面用随机初始化的模型和一张随机图像查看输出的格式,检测结果本身没有意义
1
2
3
4
5
6
7
8
9
10
11
12
13
import torch
from torchvision.models.detection import KeypointRCNN_ResNet50_FPN_Weights, keypointrcnn_resnet50_fpn

names = KeypointRCNN_ResNet50_FPN_Weights.DEFAULT.meta['keypoint_names']
print(len(names), names)

torch.manual_seed(0)
model = keypointrcnn_resnet50_fpn(weights=None, weights_backbone=None)  # 随机初始化,只看输出的格式
model.eval()
with torch.no_grad():
    output = model([torch.rand(3, 240, 320)])[0]  # 输入是图像的列表,每张图像返回一个字典
for key, value in output.items():
    print(f'{key:16s} {tuple(value.shape)} {value.dtype}')
1
2
3
4
5
6
17 ['nose', 'left_eye', 'right_eye', 'left_ear', 'right_ear', 'left_shoulder', 'right_shoulder', 'left_elbow', 'right_elbow', 'left_wrist', 'right_wrist', 'left_hip', 'right_hip', 'left_knee', 'right_knee', 'left_ankle', 'right_ankle']
boxes            (2, 4) torch.float32
labels           (2,) torch.int64
scores           (2,) torch.float32
keypoints        (2, 17, 3) torch.float32
keypoints_scores (2, 17) torch.float32
| 字段 | 形状 | 含义 |
|---|---|---|
boxes | (N, 4) | 检测框,格式为 (x1, y1, x2, y2),已映射回输入图像的坐标 |
labels、scores | (N,) | 类别编号和检测框的置信度,与检测模型相同 |
keypoints | (N, K, 3) | 每个关键点的 (x, y, v),坐标同样在输入图像的坐标系下 |
keypoints_scores | (N, K) | 每个关键点的热力图峰值,未归一化,可以用阈值过滤不可靠的点 |
- 训练时的标注也是 (N, K, 3) 的
keypoints,v 为 0 的点不参与损失的计算,与本文的可见性掩码是同一个做法 - 17 个名字中除了鼻子都是左右成对的,翻转增强时要按上一节的方式互换