Generative Models
整理自编码器与 VAE、GAN、扩散模型的思路与最小的 PyTorch 实现,以及条件生成、无分类器引导和生成结果的评价方式
深度学习系列:第 20 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
分类、检测这类模型学习的是从输入到标签的映射,生成模型学习的是数据本身的分布,训练完成后可以从中采样出新的样本。下面的例子都使用很小的数据:sklearn自带的$8 \times 8$手写数字和二维平面上的点,每个例子在 CPU 上一分钟内可以训练完,生成的结果也相应地粗糙,重点在于看清每种方法的做法
生成模型的几种思路
生成模型都要解决同一个问题:怎样把一个容易采样的分布(通常是标准正态分布)变成数据的分布。不同的方法区别在于用什么方式训练这个变换
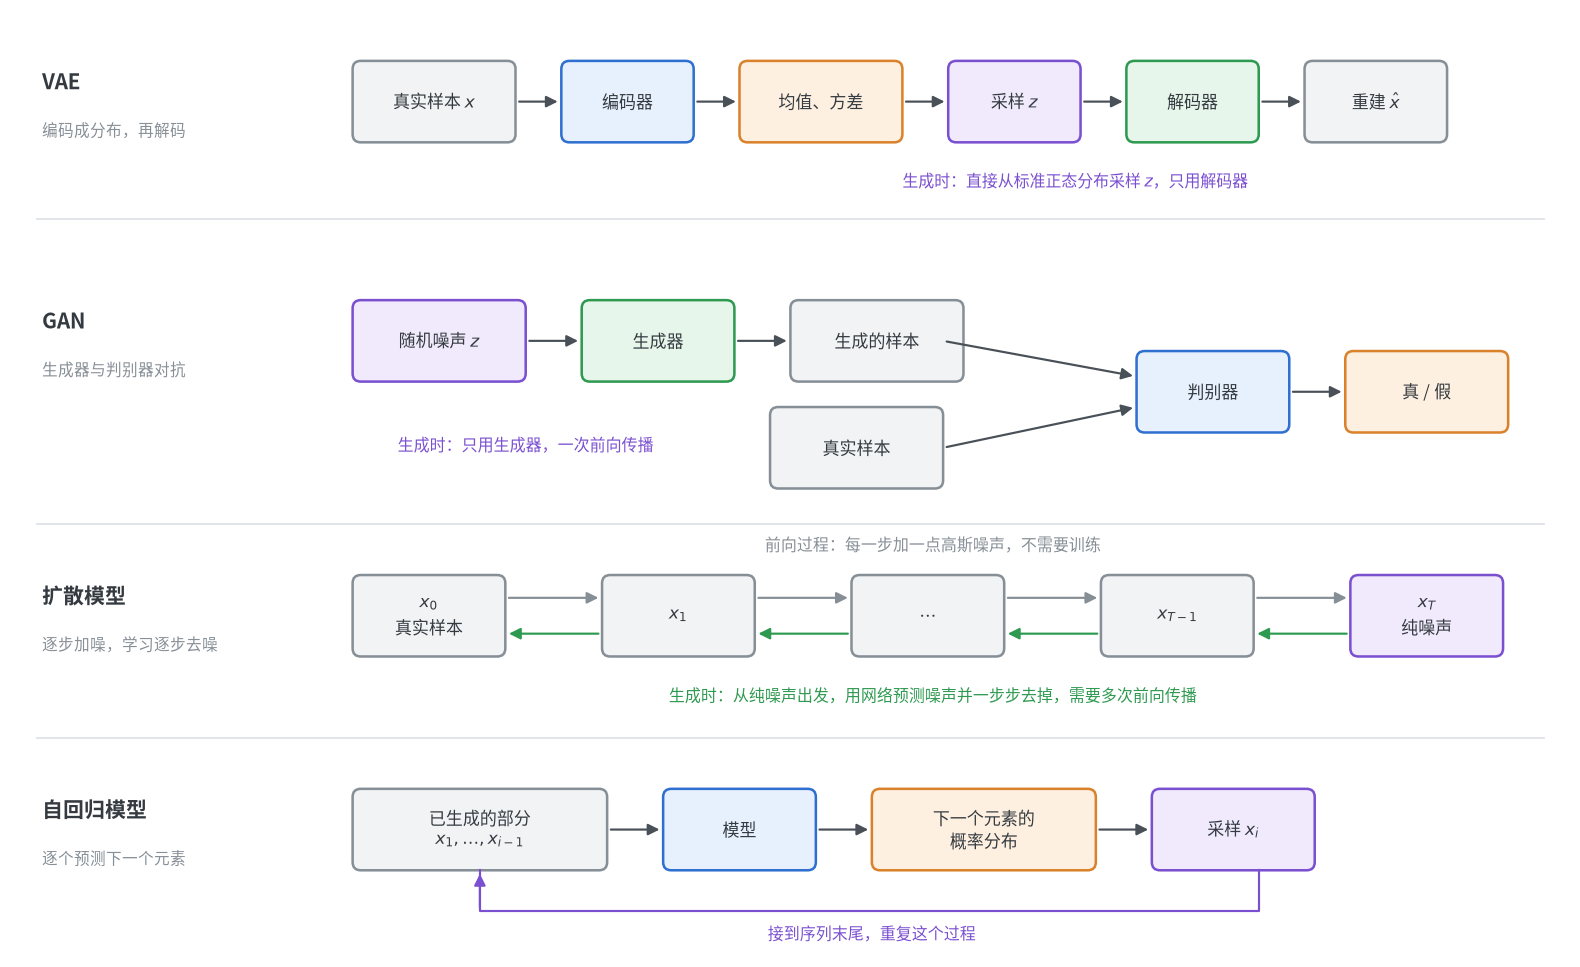
| 模型 | 思路 | 优点 | 缺点 | 代表模型 |
|---|---|---|---|---|
| VAE | 编码器把样本压缩成隐变量的分布,解码器再还原,同时约束隐变量接近标准正态分布 | 训练稳定,有编码器,隐变量可用于其他任务 | 生成的图像偏模糊 | VAE、VQ-VAE |
| GAN | 生成器把噪声变成样本,判别器分辨真假,两者交替训练 | 生成只需一次前向传播,图像清晰 | 训练不稳定,容易只生成一部分类型的样本 | DCGAN、StyleGAN |
| 扩散模型 | 给样本逐步加噪声直到变成纯噪声,训练网络预测噪声,生成时从纯噪声逐步去噪 | 训练稳定,质量和多样性都好 | 生成需要多次前向传播,速度慢 | DDPM、Stable Diffusion |
| 自回归模型 | 把样本看作序列,逐个预测下一个元素 | 训练目标简单,可以直接算出概率 | 逐个生成,序列长时速度慢 | GPT、PixelCNN |
| 标准化流 | 用可逆的变换把噪声变成样本,可以精确计算概率 | 概率可精确计算 | 网络结构受可逆的限制 | RealNVP、Glow |
自回归模型的训练与逐词生成见PyTorch Transformer,下面依次介绍前三种。各个例子的输出都是在 CPU 上运行得到的,在 GPU 上随机数不同,数值会有出入
自编码器与 VAE
自编码器
自编码器由编码器和解码器组成:编码器把输入压缩成一个维度低得多的向量,称为隐变量;解码器再由隐变量还原出输入。训练目标是让输出与输入尽量接近,不需要标签
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

# 1797张8x8的手写数字,展平为64维,像素值缩放到[0, 1]
images = torch.tensor(load_digits().data, dtype=torch.float32, device=device) / 16


class AutoEncoder(nn.Module):
    def __init__(self, latent_dim=8):
        super().__init__()
        self.encoder = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, latent_dim))
        self.decoder = nn.Sequential(nn.Linear(latent_dim, 128), nn.ReLU(), nn.Linear(128, 64), nn.Sigmoid())

    def forward(self, x):
        return self.decoder(self.encoder(x))


torch.manual_seed(0)
autoencoder = AutoEncoder().to(device)
optimizer = torch.optim.Adam(autoencoder.parameters(), lr=1e-3)

for epoch in range(200):
    for index in torch.randperm(len(images), device=device).split(128):
        x = images[index]
        loss = F.mse_loss(autoencoder(x), x)  # 输出与输入越接近越好

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

with torch.no_grad():
    codes = autoencoder.encoder(images)
    print(f"重建误差 {F.mse_loss(autoencoder.decoder(codes), images).item():.4f}")
    print("隐变量的均值", [round(v, 1) for v in codes.mean(dim=0).tolist()])
    print("隐变量的标准差", [round(v, 1) for v in codes.std(dim=0).tolist()])

    # 从标准正态分布中随机取隐变量,交给解码器
    ae_samples = autoencoder.decoder(torch.randn(16, 8, device=device))
1
2
3
重建误差 0.0109
隐变量的均值 [1.4, -1.8, -1.9, -2.6, -3.1, -2.6, -1.0, 3.1]
隐变量的标准差 [2.6, 2.6, 2.4, 2.8, 2.4, 2.2, 2.9, 2.2]
64 维的图像被压缩到 8 维后仍然可以较好地还原,但自编码器并不能用来生成:训练时没有对隐变量的分布做任何约束,它们的均值和标准差是训练中自然形成的,各个维度都不相同,隐变量之间的空隙里解码器也从未见过。从标准正态分布中随机取一个隐变量交给解码器,得到的只是一团没有形状的灰色,见下文的图
VAE
变分自编码器(VAE)做了两处改动,使隐变量的空间可以直接采样:
- 编码器输出的不再是一个确定的向量,而是一个正态分布的均值和方差,隐变量从这个分布中采样得到
- 损失中增加一项 KL 散度,约束这个分布接近标准正态分布
采样这一步本身不可导,梯度传不到编码器。重参数化技巧把采样改写为确定的计算加上外部的噪声,随机性只来自$\epsilon$,梯度可以经过$\mu$和$\sigma$传回编码器
\[z = \mu + \sigma \odot \epsilon, \qquad \epsilon \sim \mathcal{N}(0, I)\]损失由两项相加,也就是负的证据下界(ELBO)
\[\mathcal{L} = -\mathbb{E}_{q(z \mid x)}\left[\log p(x \mid z)\right] + D_{KL}\left(q(z \mid x) \,\Vert\, \mathcal{N}(0, I)\right)\]第一项是重建损失,像素值在 0 到 1 之间时常用二元交叉熵;第二项是编码器输出的分布与标准正态分布之间的 KL 散度,两个都是正态分布时可以直接算出
\[D_{KL} = -\frac{1}{2} \sum_{j} \left(1 + \log \sigma_j^2 - \mu_j^2 - \sigma_j^2\right)\]以下代码接在上面的自编码器之后
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
class VAE(nn.Module):
    def __init__(self, latent_dim=8):
        super().__init__()
        self.latent_dim = latent_dim
        self.encoder = nn.Sequential(nn.Linear(64, 128), nn.ReLU())
        self.to_mean = nn.Linear(128, latent_dim)
        self.to_logvar = nn.Linear(128, latent_dim)  # 输出方差的对数,取值范围不受限制
        self.decoder = nn.Sequential(nn.Linear(latent_dim, 128), nn.ReLU(), nn.Linear(128, 64), nn.Sigmoid())

    def encode(self, x):
        h = self.encoder(x)
        return self.to_mean(h), self.to_logvar(h)

    def forward(self, x):
        mean, logvar = self.encode(x)
        std = torch.exp(0.5 * logvar)
        z = mean + std * torch.randn_like(std)  # 重参数化:随机性来自外部的噪声,梯度可以传到mean和std
        return self.decoder(z), mean, logvar

    @torch.no_grad()
    def sample(self, n):
        z = torch.randn(n, self.latent_dim, device=self.to_mean.weight.device)
        return self.decoder(z)


def vae_loss(recon, x, mean, logvar):
    # 两项都是先对每个样本的所有维度求和,再对批次取平均
    recon_loss = F.binary_cross_entropy(recon, x, reduction="sum") / x.size(0)
    kl = -0.5 * torch.sum(1 + logvar - mean.pow(2) - logvar.exp()) / x.size(0)
    return recon_loss, kl


torch.manual_seed(0)
vae = VAE().to(device)
optimizer = torch.optim.Adam(vae.parameters(), lr=1e-3)

for epoch in range(1, 201):
    for index in torch.randperm(len(images), device=device).split(128):
        x = images[index]
        recon, mean, logvar = vae(x)
        recon_loss, kl = vae_loss(recon, x, mean, logvar)
        loss = recon_loss + kl

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

    if epoch % 50 == 0:
        print(f"epoch {epoch}, 重建 {recon_loss.item():.2f}, KL {kl.item():.2f}")

with torch.no_grad():
    mean, logvar = vae.encode(images)
    print(f"重建误差 {F.mse_loss(vae.decoder(mean), images).item():.4f}")
    print("各维均值的标准差", [round(v, 1) for v in mean.std(dim=0).tolist()])

vae_samples = vae.sample(16)
1
2
3
4
5
6
epoch 50, 重建 22.20, KL 2.42
epoch 100, 重建 21.85, KL 3.03
epoch 150, 重建 19.84, KL 3.33
epoch 200, 重建 20.39, KL 3.41
重建误差 0.0255
各维均值的标准差 [0.1, 0.1, 0.1, 0.9, 0.8, 0.9, 0.6, 0.9]
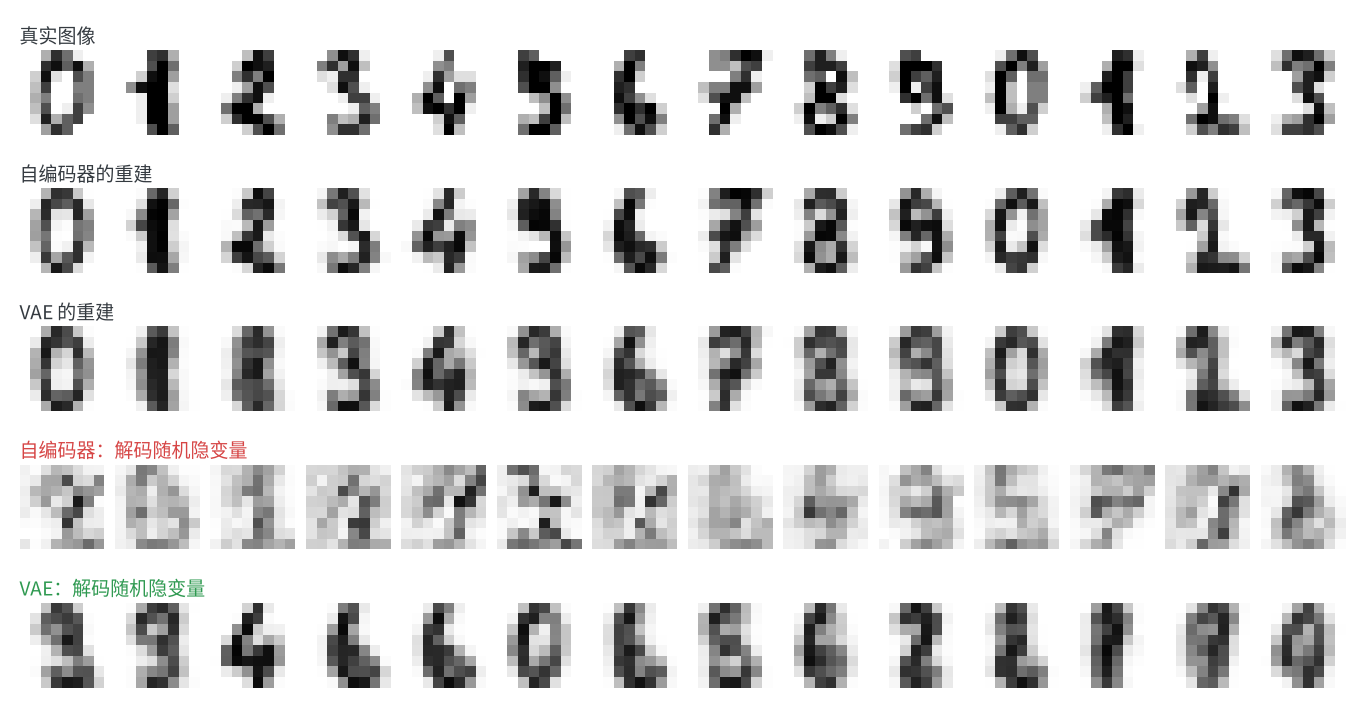
- 自编码器的重建最清晰,但解码随机隐变量得到的不是数字
- VAE 解码随机隐变量得到的都是数字的形状,其中一部分能认出是哪个数字,其余的笔画模糊、介于几个数字之间。模糊是 VAE 的通病:重建损失鼓励输出所有可能结果的平均
- VAE 的重建误差(0.0255)比自编码器(0.0109)大,这是 KL 项的代价:它把不同样本的隐变量挤到一起
- 8 个隐变量中有 3 个的均值几乎不随输入变化,这几维被 KL 项压成了标准正态分布,没有携带信息,模型实际只用了 5 维
- 编码器输出方差的对数而不是方差本身,这样输出可以是任意实数,不需要额外保证方差为正
重建损失和 KL 散度的求和方式必须一致。 上面两项都是对每个样本的所有维度求和。如果重建损失改用默认的reduction="mean",它会再除以 64 个像素,相当于 KL 项的权重被放大了 64 倍。实测这样训练时 KL 降到 0.00001 左右,编码器对所有输入都输出标准正态分布,解码器忽略隐变量,生成的 16 张图几乎完全相同,这种现象称为后验坍缩
GAN
生成对抗网络(GAN)不直接比较生成的样本和真实样本,而是再训练一个判别器来分辨两者。生成器$G$把随机噪声变成样本,判别器$D$输出样本为真的概率,两者的目标相反
\[\min_G \max_D \; \mathbb{E}_{x}\left[\log D(x)\right] + \mathbb{E}_{z}\left[\log\left(1 - D(G(z))\right)\right]\]训练时两个网络交替更新,每一步分为两个部分:
- 固定生成器,训练判别器:真实样本的标签为 1,生成的样本标签为 0
- 固定判别器,训练生成器:让判别器把生成的样本判为 1
下面的真实分布是二维平面上排成一圈的 8 个高斯分布,这样可以直接画出生成的点,也方便统计生成器覆盖了其中几个
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
import math

import torch
import torch.nn.functional as F
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

# 真实分布:8个高斯分布,中心均匀排在半径为2的圆上
centers = torch.tensor([[2 * math.cos(i * math.pi / 4), 2 * math.sin(i * math.pi / 4)] for i in range(8)],
                       device=device)


def sample_real(n, std=0.1):
    return centers[torch.randint(0, 8, (n,), device=device)] + std * torch.randn(n, 2, device=device)


def coverage(points, std=0.1):
    """返回落在某个中心3倍标准差以内的点的比例,以及被覆盖的中心个数"""
    distance, nearest = torch.cdist(points, centers).min(dim=1)
    good = distance < 3 * std
    counts = torch.bincount(nearest[good], minlength=8)
    return good.float().mean().item(), (counts >= 0.01 * len(points)).sum().item()


def train_gan(betas, lr=1e-3, steps=3000, batch_size=256, noise_dim=2):
    generator = nn.Sequential(nn.Linear(noise_dim, 128), nn.ReLU(),
                              nn.Linear(128, 128), nn.ReLU(), nn.Linear(128, 2)).to(device)
    discriminator = nn.Sequential(nn.Linear(2, 128), nn.LeakyReLU(0.2),
                                  nn.Linear(128, 128), nn.LeakyReLU(0.2), nn.Linear(128, 1)).to(device)
    g_optimizer = torch.optim.Adam(generator.parameters(), lr=lr, betas=betas)
    d_optimizer = torch.optim.Adam(discriminator.parameters(), lr=lr, betas=betas)
    real_label = torch.ones(batch_size, 1, device=device)
    fake_label = torch.zeros(batch_size, 1, device=device)
    snapshots = {}

    for step in range(1, steps + 1):
        real = sample_real(batch_size)
        fake = generator(torch.randn(batch_size, noise_dim, device=device))

        # 1. 训练判别器:真实样本判为1,生成的样本判为0。detach使梯度不传到生成器
        d_loss = (F.binary_cross_entropy_with_logits(discriminator(real), real_label)
                  + F.binary_cross_entropy_with_logits(discriminator(fake.detach()), fake_label))
        d_optimizer.zero_grad()
        d_loss.backward()
        d_optimizer.step()

        # 2. 训练生成器:让判别器把生成的样本判为1
        g_loss = F.binary_cross_entropy_with_logits(discriminator(fake), real_label)
        g_optimizer.zero_grad()
        g_loss.backward()
        g_optimizer.step()

        if step % 500 == 0:
            with torch.no_grad():
                points = generator(torch.randn(2000, noise_dim, device=device))
            quality, modes = coverage(points)
            snapshots[step] = points.cpu()
            print(f"step {step}, 判别器 {d_loss.item():.2f}, 生成器 {g_loss.item():.2f}, "
                  f"中心附近的比例 {quality:.2f}, 覆盖 {modes} 个中心")
    return snapshots


torch.manual_seed(0)
quality, modes = coverage(sample_real(2000))  # 真实样本自身的结果,作为参照
print(f"真实样本, 中心附近的比例 {quality:.2f}, 覆盖 {modes} 个中心")
snapshots = train_gan(betas=(0.5, 0.999))
1
2
3
4
5
6
7
真实样本, 中心附近的比例 0.99, 覆盖 8 个中心
step 500, 判别器 1.29, 生成器 0.78, 中心附近的比例 0.52, 覆盖 8 个中心
step 1000, 判别器 1.29, 生成器 0.85, 中心附近的比例 0.75, 覆盖 8 个中心
step 1500, 判别器 1.35, 生成器 0.75, 中心附近的比例 0.87, 覆盖 8 个中心
step 2000, 判别器 1.36, 生成器 0.75, 中心附近的比例 0.89, 覆盖 8 个中心
step 2500, 判别器 1.38, 生成器 0.73, 中心附近的比例 0.89, 覆盖 8 个中心
step 3000, 判别器 1.36, 生成器 0.73, 中心附近的比例 0.92, 覆盖 8 个中心
- 训练判别器时对生成的样本调用
detach(),否则判别器的损失反向传播时会把梯度一直传到生成器,并释放生成器的计算图,之后训练生成器时报错Trying to backward through the graph a second time - 生成器的损失没有照搬公式去最小化$\log(1 - D(G(z)))$,而是让判别器把生成的样本判为 1。训练初期判别器很容易分辨真假,按公式计算的梯度接近 0,换成这种写法梯度更大
- 判别器的最后一层不加
Sigmoid,直接输出 logits,配合binary_cross_entropy_with_logits数值更稳定 - 损失不能反映生成质量。 落在中心附近的点的比例从 0.52 升到 0.92 的过程中,判别器的损失一直在 1.3 左右、生成器的损失在 0.75 左右,接近判别器完全无法分辨时的$2\ln 2 \approx 1.39$和$\ln 2 \approx 0.69$。判断训练进展只能看生成的样本
- 训练到最后,各个中心之间仍然连着稀疏的点。生成器是连续的函数,输入的噪声连续变化时,输出从一个中心移到另一个中心必然经过中间的区域
训练不稳定与模式坍缩
GAN 的训练对超参数很敏感。上面的优化器使用了betas=(0.5, 0.999),这是 GAN 中常见的设置。把它换回 Adam 的默认值(0.9, 0.999),其他都不变,以下代码接在上面的训练之后
1
2
torch.manual_seed(1)
snapshots_default = train_gan(betas=(0.9, 0.999))  # Adam的默认值
1
2
3
4
5
6
step 500, 判别器 0.65, 生成器 1.91, 中心附近的比例 0.07, 覆盖 1 个中心
step 1000, 判别器 0.73, 生成器 1.42, 中心附近的比例 0.00, 覆盖 0 个中心
step 1500, 判别器 0.63, 生成器 1.50, 中心附近的比例 0.07, 覆盖 1 个中心
step 2000, 判别器 0.88, 生成器 1.62, 中心附近的比例 0.04, 覆盖 1 个中心
step 2500, 判别器 1.29, 生成器 0.76, 中心附近的比例 0.25, 覆盖 8 个中心
step 3000, 判别器 1.26, 生成器 0.77, 中心附近的比例 0.50, 覆盖 8 个中心
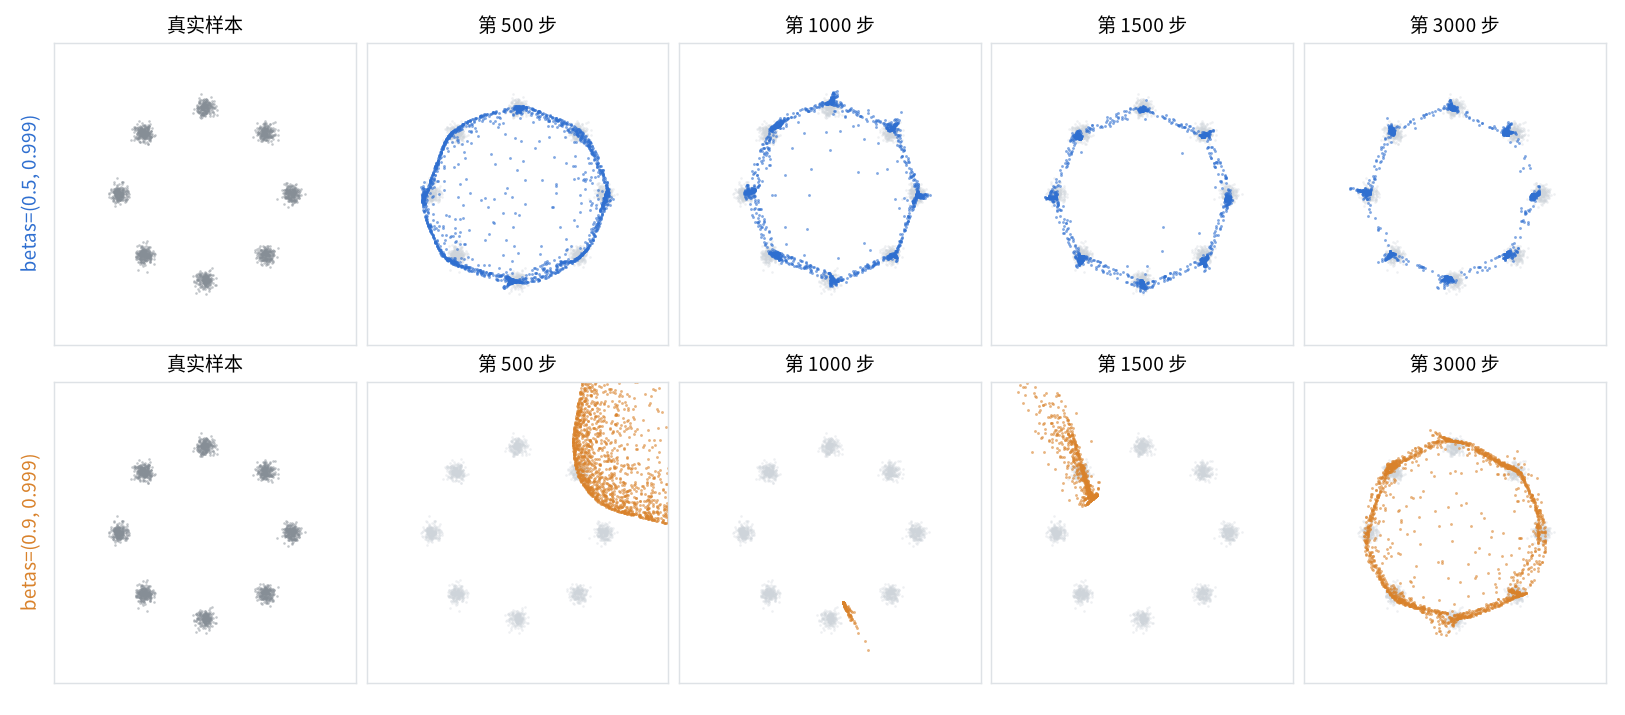
- 第 500 步时生成的点全部偏在一侧;第 1000 步时 2000 个点几乎重合在一起,不论输入什么噪声,生成器的输出都相同;第 1500 步时又整体移到了另一个位置
- 这种生成器只输出很少几种样本的现象称为模式坍缩:生成器发现只生成某一种样本就足以骗过当前的判别器,于是放弃了其他类型;判别器学会识别之后,生成器再换一个位置,两者互相追逐
- 判别器的损失明显低于 1.39、生成器的损失明显偏高,说明判别器占了上风,这是训练失衡的信号
- 这次训练在 2500 步之后恢复,覆盖了全部 8 个中心,但到第 3000 步时落在中心附近的比例只有 0.50,远低于前一种设置的 0.92
- 这里的随机种子是 1,坍缩得最典型。种子为 0、2、3 时使用默认值同样不稳定,分别到第 1000、1500、2500 步才覆盖全部 8 个中心;使用
(0.5, 0.999)时这四个种子在每次检查时都覆盖了全部 8 个中心
扩散模型
扩散模型分为两个过程:前向过程给真实样本逐步加噪声,$T$步之后变成纯噪声,这个过程是固定的,不需要训练;反向过程从纯噪声出发,用网络一步步把噪声去掉,得到样本
前向过程
每一步加入的噪声的方差记作$\beta$,由一个事先定好的表给出,通常从很小的值线性增大。逐步加噪的结果可以写成闭式,从原图一步就能得到任意第$t$步的结果,不需要真的迭代$t$次
\[x_t = \sqrt{\bar{\alpha}_t}\, x_0 + \sqrt{1 - \bar{\alpha}_t}\, \epsilon, \qquad \bar{\alpha}_t = \prod_{s=1}^{t} (1 - \beta_s), \qquad \epsilon \sim \mathcal{N}(0, I)\]随着$t$增大,原图的系数从 1 降到 0,噪声的系数从 0 升到 1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import math

import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn

device = "cuda" if torch.cuda.is_available() else "cpu"

digits = load_digits()
images = torch.tensor(digits.data, dtype=torch.float32, device=device) / 8 - 1  # 像素值缩放到[-1, 1]
labels = torch.tensor(digits.target, device=device)

T = 1000
betas = torch.linspace(1e-4, 0.02, T, device=device)  # 每一步加入的噪声的方差
alphas = 1 - betas
alpha_bars = torch.cumprod(alphas, dim=0)             # 从第1步到第t步的alpha连乘


def add_noise(x0, t, noise):
    """前向过程:由x0一步得到第t步的结果,t的形状为(N,)"""
    alpha_bar = alpha_bars[t].unsqueeze(-1)
    return alpha_bar.sqrt() * x0 + (1 - alpha_bar).sqrt() * noise


for t in [0, 249, 499, 749, 999]:
    print(f"t = {t + 1:4d}, x0的系数 {alpha_bars[t].sqrt().item():.3f}, 噪声的系数 {(1 - alpha_bars[t]).sqrt().item():.3f}")
1
2
3
4
5
t =    1, x0的系数 1.000, 噪声的系数 0.010
t =  250, x0的系数 0.724, 噪声的系数 0.690
t =  500, x0的系数 0.280, 噪声的系数 0.960
t =  750, x0的系数 0.058, 噪声的系数 0.998
t = 1000, x0的系数 0.006, 噪声的系数 1.000
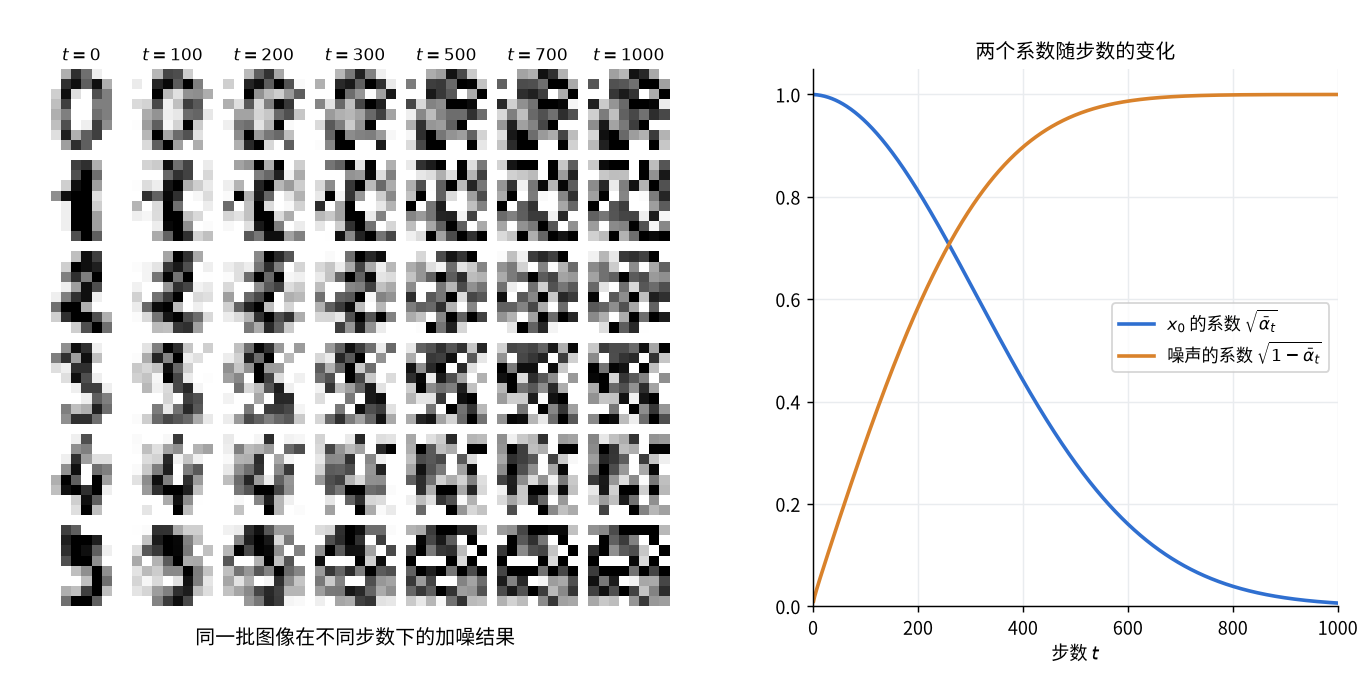
- 像素值要缩放到 -1 到 1 之间,与噪声的均值 0 对齐
- 代码中的下标从 0 开始,
alpha_bars[0]对应公式中的第 1 步 - 减少步数时噪声表要一起调整。 最后一步原图的系数必须接近 0,否则训练时见到的最后一步与采样时用的纯噪声不一致。上面的设置下这个系数为 0.006;保持
betas的范围不变而把$T$减到 200,这个系数变成 0.364,原图还清晰可见
训练
网络的输入是加噪后的样本和步数,输出是对其中噪声的预测,损失就是预测值与实际加入的噪声之间的均方误差
\[\mathcal{L} = \mathbb{E}_{x_0, t, \epsilon} \left\Vert \epsilon - \epsilon_\theta(x_t, t) \right\Vert^2\]每个训练步骤:取一批真实样本,给每个样本随机取一个步数,按闭式加噪,让网络预测噪声。以下代码接在上面的前向过程之后。训练循环的一般写法见PyTorch Training
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
def time_embedding(t, dim=64):
    """把整数的步数t变成向量,做法与Transformer的正弦位置编码相同"""
    freqs = torch.exp(-math.log(10000.0) * torch.arange(dim // 2, device=t.device) / (dim // 2))
    args = t.unsqueeze(-1) * freqs
    return torch.cat([args.sin(), args.cos()], dim=-1)


class Denoiser(nn.Module):
    def __init__(self, hidden=256):
        super().__init__()
        self.input = nn.Linear(64, hidden)
        self.time = nn.Linear(64, hidden)
        self.net = nn.Sequential(nn.SiLU(), nn.Linear(hidden, hidden), nn.SiLU(),
                                 nn.Linear(hidden, hidden), nn.SiLU(), nn.Linear(hidden, 64))

    def forward(self, x, t):
        return self.net(self.input(x) + self.time(time_embedding(t)))  # 输出与x形状相同,是对噪声的预测


torch.manual_seed(0)
model = Denoiser().to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)

for step in range(1, 3001):
    x0 = images[torch.randint(0, len(images), (128,), device=device)]
    t = torch.randint(0, T, (128,), device=device)  # 每个样本随机取一个步数
    noise = torch.randn_like(x0)

    loss = F.mse_loss(model(add_noise(x0, t, noise), t), noise)  # 预测加进去的噪声

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

    if step % 1000 == 0:
        print(f"step {step}, loss {loss.item():.3f}")
1
2
3
step 1000, loss 0.182
step 2000, loss 0.126
step 3000, loss 0.157
- 所有步数共用同一个网络,所以步数必须作为输入,这里用正弦编码把它变成向量再加到特征上
- 这里的数据只有 64 维,用全连接网络就够了;真实的图像使用带注意力的 U-Net 或 Transformer
- 损失降到 0.15 左右后就在这个范围内波动,不会趋近于 0:加入的噪声是随机的,不可能完全预测准;每个批次随机取到的步数不同,预测的难度不同,损失也随之波动
采样
生成时从纯噪声出发,从第$T$步倒着走到第 1 步。每一步用网络预测当前样本中的噪声,去掉其中一部分,再加回一点新的噪声
\[x_{t-1} = \frac{1}{\sqrt{\alpha_t}} \left( x_t - \frac{\beta_t}{\sqrt{1 - \bar{\alpha}_t}}\, \epsilon_\theta(x_t, t) \right) + \sqrt{\beta_t}\, z, \qquad z \sim \mathcal{N}(0, I)\]其中$\alpha = 1 - \beta$,都取第$t$步的值,最后一步不再加噪声
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
@torch.no_grad()
def sample(predict_noise, n):
    """predict_noise(x, t)返回对噪声的预测"""
    x = torch.randn(n, 64, device=device)  # 从纯噪声开始
    for i in reversed(range(T)):
        t = torch.full((n,), i, device=device)
        noise = predict_noise(x, t)
        # 去掉预测的噪声,得到上一步的均值
        x = (x - betas[i] / (1 - alpha_bars[i]).sqrt() * noise) / alphas[i].sqrt()
        if i > 0:
            x = x + betas[i].sqrt() * torch.randn_like(x)  # 除了最后一步,都要再加回一点噪声
    return x


torch.manual_seed(0)
samples = sample(model, 16)
print(samples.shape)  # torch.Size([16, 64])
print(f"{samples.min().item():.2f}, {samples.max().item():.2f}")
1
2
torch.Size([16, 64])
-2.30, 2.14
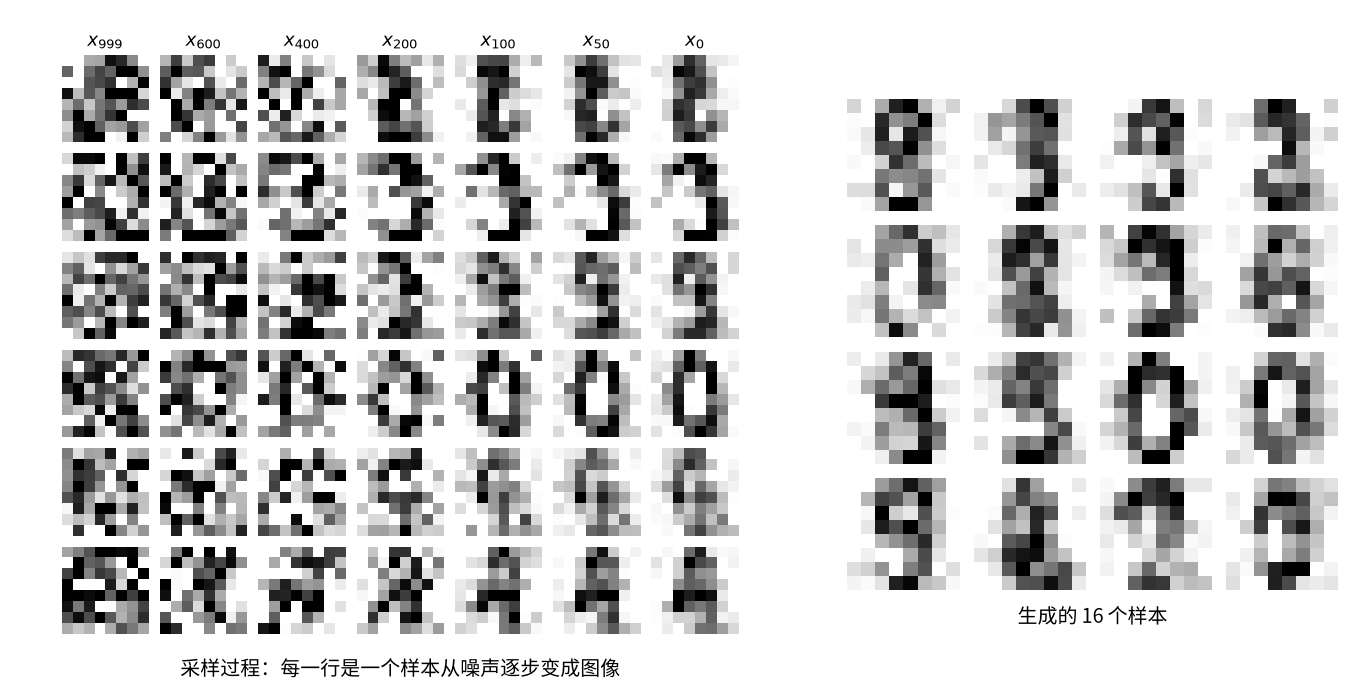
- 生成 16 张图需要调用网络 1000 次,而 VAE 和 GAN 只需要 1 次,这是扩散模型最主要的缺点。DDIM 等采样方法可以把步数减少到几十步
- 生成的样本笔画比 VAE 的清晰,但带有明显的噪点,其中一部分能认出是哪个数字,也有一些认不出
- 训练数据的取值在 -1 到 1 之间,而生成的样本超出了这个范围,说明网络对噪声的预测并不准确。显示或保存图像前要用
clamp(-1, 1)截断
条件生成
上面的模型只能随机生成,不能指定生成哪个数字。条件生成把条件(类别标签、文本等)作为网络的额外输入。对扩散模型来说,只需要把标签经过nn.Embedding变成向量,与步数的编码一样加到特征上
无分类器引导
只是把标签输入网络,生成的结果与条件的吻合程度往往不够。无分类器引导(classifier-free guidance)用同一个网络同时学习有条件和无条件两种预测:训练时以一定的概率把标签替换为一个表示“没有条件”的特殊编号;采样时两种预测都算一遍,再沿着从无条件指向有条件的方向外推
\[\hat{\epsilon} = \epsilon_\theta(x_t, t, \varnothing) + w \left( \epsilon_\theta(x_t, t, y) - \epsilon_\theta(x_t, t, \varnothing) \right)\]| 引导强度$w$ | 效果 |
|---|---|
| 0 | 完全不使用条件,等同于无条件生成 |
| 1 | 普通的条件生成 |
| 大于 1 | 放大条件的影响,结果与条件更吻合,但多样性下降,过大时图像被破坏 |
以下代码接在上面的扩散模型之后。为了检查生成的是不是指定的数字,用真实图像训练了一个逻辑回归分类器来判断
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
from sklearn.linear_model import LogisticRegression


class ConditionalDenoiser(Denoiser):
    def __init__(self, num_classes=10, hidden=256):
        super().__init__(hidden)
        self.null = num_classes  # 多出来的一个编号,表示“没有条件”
        self.label = nn.Embedding(num_classes + 1, hidden)

    def forward(self, x, t, y):
        return self.net(self.input(x) + self.time(time_embedding(t)) + self.label(y))


torch.manual_seed(0)
cond_model = ConditionalDenoiser().to(device)
optimizer = torch.optim.Adam(cond_model.parameters(), lr=1e-3)

for step in range(1, 3001):
    index = torch.randint(0, len(images), (128,), device=device)
    x0, y = images[index], labels[index]
    y = y.masked_fill(torch.rand(128, device=device) < 0.1, cond_model.null)  # 10%的样本丢掉标签
    t = torch.randint(0, T, (128,), device=device)
    noise = torch.randn_like(x0)

    loss = F.mse_loss(cond_model(add_noise(x0, t, noise), t, y), noise)

    optimizer.zero_grad()
    loss.backward()
    optimizer.step()


def guided(y, scale):
    """返回一个可以交给sample的函数,scale为引导强度"""
    def predict_noise(x, t):
        cond = cond_model(x, t, y)
        uncond = cond_model(x, t, torch.full_like(y, cond_model.null))
        return uncond + scale * (cond - uncond)
    return predict_noise


# 用真实图像训练一个分类器,检查生成的图像是不是指定的数字
classifier = LogisticRegression(max_iter=2000).fit(images.cpu().numpy(), labels.cpu().numpy())
y = torch.arange(10, device=device).repeat(20)  # 0到9各20张

for scale in [0.0, 1.0, 2.0, 5.0]:
    torch.manual_seed(0)
    out = sample(guided(y, scale), len(y))
    accuracy = (classifier.predict(out.cpu().numpy()) == y.cpu().numpy()).mean()
    print(f"scale {scale}, 与指定数字一致的比例 {accuracy:.3f}, 取值范围 {out.min().item():.1f} ~ {out.max().item():.1f}")
1
2
3
4
scale 0.0, 与指定数字一致的比例 0.150, 取值范围 -2.4 ~ 2.3
scale 1.0, 与指定数字一致的比例 0.930, 取值范围 -2.5 ~ 2.7
scale 2.0, 与指定数字一致的比例 1.000, 取值范围 -3.4 ~ 3.4
scale 5.0, 与指定数字一致的比例 0.775, 取值范围 -34.0 ~ 23.2
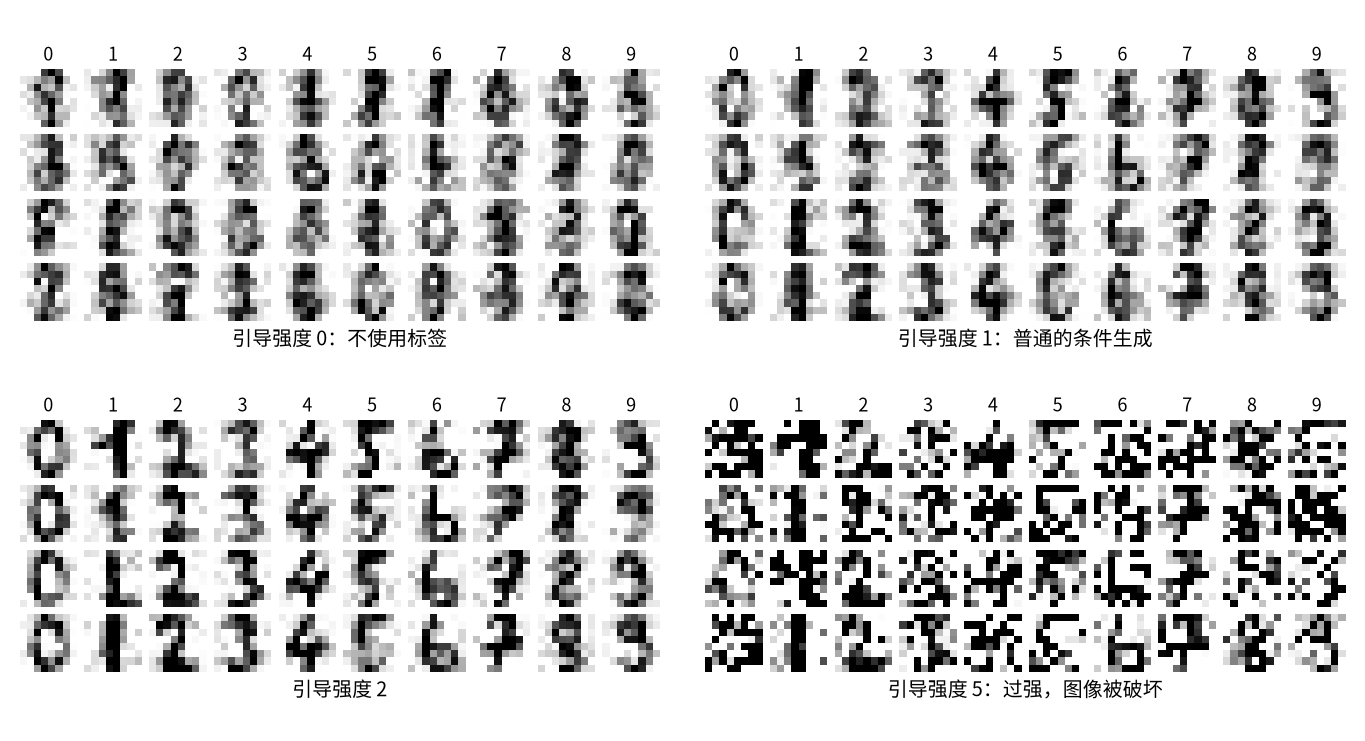
- 图中每一列指定生成同一个数字。引导强度为 0 时标签不起作用,与指定数字一致的比例和随机猜测差不多;为 1 时大部分与指定的数字一致;为 2 时全部一致,图像也比无条件生成的干净,但同一列中的几张更加相像
- 引导强度不是越大越好。 为 5 时生成结果的取值达到了正负几十,远远超出训练数据的范围,图像被破坏,一致的比例反而下降
- 每一步要调用网络两次,采样时间翻倍
- 有些文章把公式写成$(1 + w)$乘以有条件的预测减去$w$乘以无条件的预测,那种写法中的 0 对应这里的 1,使用别人的代码时要先确认是哪一种
- 文生图模型用的是同样的做法,只是条件从类别编号换成了文本编码器的输出,“没有条件”对应空字符串
VAE 和 GAN 也可以做条件生成:把标签的向量与隐变量或噪声拼接后输入解码器或生成器,判别器同样要输入标签。这两种在本文中没有运行验证
评价与对比
生成模型没有准确率这样直接的指标,损失也往往不能反映质量,评价主要靠以下几种方式
| 方式 | 做法 | 局限 |
|---|---|---|
| 直接观察 | 把生成的样本排成网格,看清晰程度和种类是否齐全 | 主观,无法比较相近的模型 |
| FID | 用预训练的 Inception 网络提取真实样本和生成样本的特征,比较两组特征的均值和协方差,越小越好 | 需要几千到几万个样本才稳定,只适用于自然图像 |
| 分类器 | 用在真实数据上训练的分类器判断条件生成的结果是否符合条件 | 只能衡量是否符合条件,不能衡量清晰程度和多样性 |
| 覆盖情况 | 数据的类型已知时,统计生成的样本覆盖了多少种 | 只适用于简单的数据 |
观察时既要看单个样本的质量,也要看多样性:只看质量会漏掉模式坍缩,生成的每个样本都很好,但都是同一种
三种模型的对比如下,最后一列是本文例子中观察到的情况
| 模型 | 训练稳定性 | 样本质量 | 采样速度 | 本文中的结果 |
|---|---|---|---|---|
| VAE | 稳定,损失持续下降 | 偏模糊 | 快,一次前向传播 | 数字模糊,部分介于两个数字之间 |
| GAN | 不稳定,对超参数敏感,损失不反映质量 | 清晰,但可能缺少某些类型 | 快,一次前向传播 | 二维的点基本落在 8 个中心上,换一组betas就出现了模式坍缩 |
| 扩散模型 | 稳定,损失就是均方误差 | 质量和多样性都好 | 慢,需要几十到上千次前向传播 | 数字比 VAE 清晰,但带有噪点,加上引导后更干净 |
这几种方法也经常组合使用。Stable Diffusion 先用一个 VAE 把图像压缩成尺寸小得多的隐变量,扩散模型在隐变量上训练和采样,最后用 VAE 的解码器还原出图像,这样扩散模型每一步的计算量小得多