PyTorch Debugging
整理 PyTorch 训练出现问题时的排查顺序,以及 NaN、学习率、梯度、过拟合与欠拟合问题的定位方法
深度学习系列:第 9 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
深度学习的代码有错误时往往不会报错,只是损失不下降,或者准确率比预期低一截。排查时不要凭感觉修改超参数,而是按固定的顺序逐项确认,每一步只验证一件事。训练循环本身的写法见PyTorch Training,不报错但结果错误的常见问题见PyTorch Common Mistakes,显存不足与速度问题见PyTorch Memory and Speed
文中的输出是在 CPU 上得到的。浮点运算的顺序与线程数、硬件有关,换一台机器运行时,训练过程中的具体数值可能略有不同,损失震荡、发散的例子差别会更大,但现象是一样的
排查顺序
按数据流动的方向依次检查,前面的环节确认无误之后再看后面的
| 顺序 | 检查对象 | 检查内容 |
|---|---|---|
| 1 | 数据 | 取出一个批次,查看形状、类型、数值范围,标签是否与样本对应、是否从 0 开始 |
| 2 | 模型输出 | 输出形状是否为 (批大小,类别数),初始损失是否接近理论值 |
| 3 | 损失函数 | 输入是 logits 还是概率,预测值与标签的形状和类型是否符合要求 |
| 4 | 优化器 | 模型的参数是否交给了优化器,每一步是否清零梯度,学习率的量级是否合理 |
| 5 | 单批次过拟合 | 在同一个批次上反复训练,损失能否降到接近 0 |
| 6 | 完整训练 | 同时记录训练和验证的损失,根据曲线判断是学习率、过拟合还是欠拟合的问题 |
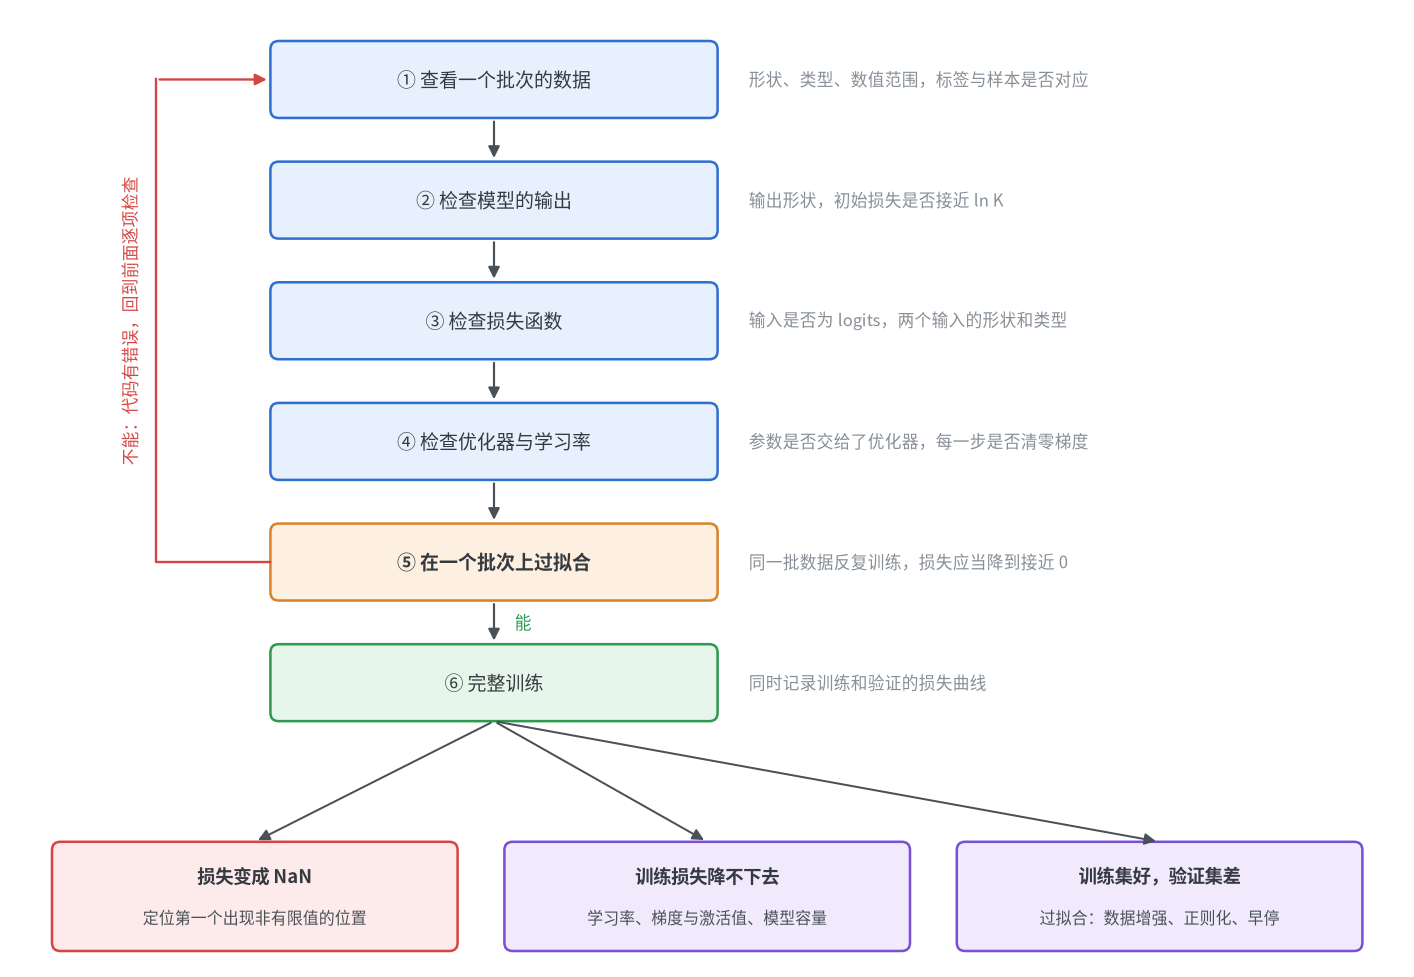
前两项只需要几行代码。$K$个类别的分类模型在刚初始化时对每个类别的预测概率接近$1/K$,交叉熵损失应当接近$\ln K$。初始损失与这个值相差很大,说明输出层、损失函数或标签有问题
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import math

import torch
from sklearn.datasets import load_digits
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(0)
digits = load_digits()  # 8x8的手写数字,共1797张,10个类别
dataset = TensorDataset(torch.tensor(digits.data, dtype=torch.float32) / 16, torch.tensor(digits.target))
loader = DataLoader(dataset, batch_size=64, shuffle=True)
model = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))

x, y = next(iter(loader))  # 取出一个批次
print(x.shape, x.dtype)  # torch.Size([64, 64]) torch.float32
print(f"min {x.min().item():.2f}  max {x.max().item():.2f}  mean {x.mean().item():.2f}  std {x.std().item():.2f}")
print(y.shape, y.dtype)  # torch.Size([64]) torch.int64
print(torch.bincount(y, minlength=10))  # 各个类别的样本数

out = model(x)
print(out.shape)  # torch.Size([64, 10])
print(f"初始损失 {nn.CrossEntropyLoss()(out, y).item():.4f}  ln(10) = {math.log(10):.4f}")
1
2
3
4
5
6
torch.Size([64, 64]) torch.float32
min 0.00  max 1.00  mean 0.30  std 0.38
torch.Size([64]) torch.int64
tensor([ 8, 10,  6,  5,  2,  7,  5,  7,  5,  9])
torch.Size([64, 10])
初始损失 2.2948  ln(10) = 2.3026
- 图像数据重点看数值范围:没有除以 255 的
uint8图像、重复做了两次归一化,都只能从min、max、mean中看出来 - 图像任务最好把一个批次的图像和标签画出来看一眼,数据增强把图像翻转了而标签(检测框、关键点)没有跟着变是常见的错误
- 某个类别的样本数为 0 或远多于其他类别时,先确认数据集的划分和标签的读取
在一个批次上过拟合
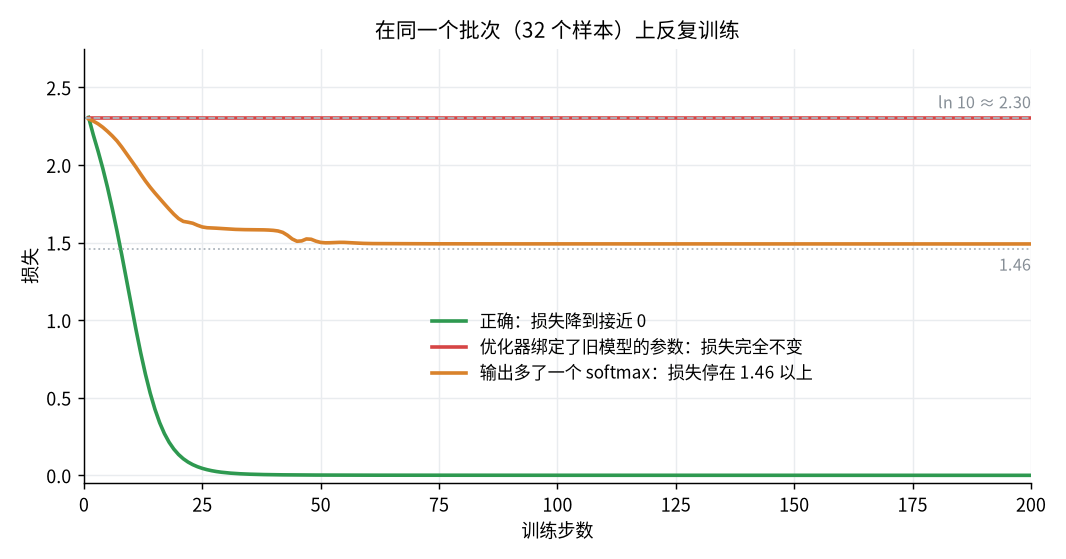
这是最有用的一项检查:只取一个批次(几十个样本),关闭数据增强,反复训练几百步。参数量远多于样本数的模型一定能把这几十个样本全部记住,损失应当降到接近 0、准确率达到 100%。做不到就说明代码有错误,此时调整超参数没有意义
这项检查只需要几秒钟,并且能够覆盖前向传播、损失、反向传播、参数更新整条链路
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
import torch
from sklearn.datasets import load_digits
from torch import nn

torch.manual_seed(0)
digits = load_digits()
x = torch.tensor(digits.data[:32], dtype=torch.float32) / 16  # 只取32个样本,反复训练
y = torch.tensor(digits.target[:32])

def make_model():
    return nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))

def overfit(name, model, optimizer, steps=200):
    criterion = nn.CrossEntropyLoss()
    losses = []
    for step in range(steps):
        out = model(x)
        loss = criterion(out, y)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        losses.append(loss.item())
    accuracy = (model(x).argmax(dim=1) == y).float().mean().item()
    print(f"{name}  " + "  ".join(f"{losses[i]:.4f}" for i in (0, 9, 49, 199)) + f"  准确率 {accuracy:.2f}")
    return losses

# 正确的写法
model = make_model()
overfit("正确          ", model, torch.optim.Adam(model.parameters(), lr=0.01))

# 错误1:创建优化器之后又重新创建了模型,优化器更新的是旧模型的参数
model = make_model()
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
model = make_model()
overfit("优化器绑错参数", model, optimizer)

# 错误2:模型的最后多了一个softmax
model = nn.Sequential(make_model(), nn.Softmax(dim=1))
overfit("多了softmax   ", model, torch.optim.Adam(model.parameters(), lr=0.01))
每一行依次为第 1、10、50、200 步的损失和最终的准确率
1
2
3
正确            2.3070  1.0991  0.0021  0.0004  准确率 1.00
优化器绑错参数  2.3057  2.3057  2.3057  2.3057  准确率 0.12
多了softmax     2.2970  2.0304  1.5012  1.4913  准确率 0.97
| 现象 | 可能的原因 |
|---|---|
| 损失完全不变 | 优化器没有拿到模型的参数,参数被冻结,计算图被切断,没有调用optimizer.step() |
| 损失下降后停在某个不为 0 的值 | 损失函数用错,输出层多了激活函数,标签与样本没有对应 |
| 损失一直停在$\ln K$附近 | 模型的输出与输入无关,输入全为 0 或学习率过大导致神经元全部失活 |
| 损失震荡或变成 NaN | 学习率过大,输入的数值范围过大 |
| 损失降到 0 但完整训练效果差 | 代码基本正确,问题在数据量、正则化或学习率,见后面几节 |
第二种错误的准确率有 0.97,只看准确率很容易放过去,所以要同时看损失的数值
损失出现 NaN
NaN 一旦出现就会传播到所有参数,之后的输出全部是 NaN。排查的目标是找到第一个出现 NaN 或 Inf 的位置
常见来源
| 来源 | 例子 | 处理方法 |
|---|---|---|
| 学习率过大 | 损失逐步增大,溢出为 Inf 后变成 NaN | 降低学习率,对输入做标准化,裁剪梯度 |
| 对 0 取对数 | torch.log(prob),概率下溢为 0 | 使用log_softmax、cross_entropy等自带的函数 |
| 除以 0 | 除以标准差、范数、样本数 | 分母加上一个很小的数,或用clamp(min=...) |
| 在 0 处开方 | torch.sqrt(x)在 0 处的导数为无穷大 | 开方之前加上一个很小的数 |
| 指数溢出 | torch.exp(x),$x$较大时超出浮点数的范围 | 限制输入的范围,或改用logsumexp等函数 |
| 数据本身 | 数据集中有 NaN、空值或异常大的值 | 读取数据后用torch.isfinite检查 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import torch
import torch.nn.functional as F

logits = torch.tensor([[5.0, 120.0, -3.0]], requires_grad=True)
target = torch.tensor([0])

# 错误:先softmax再取对数,概率下溢为0时log(0) = -inf
prob = logits.softmax(dim=1)
print(prob)  # tensor([[0., 1., 0.]], grad_fn=<SoftmaxBackward0>)
loss = -torch.log(prob[0, target]).mean()
loss.backward()
print(loss.item(), logits.grad)  # inf tensor([[nan, nan, nan]])

# 正确:log_softmax或cross_entropy在内部用数值稳定的方式计算
logits.grad = None
loss = F.cross_entropy(logits, target)
loss.backward()
print(loss.item(), logits.grad)  # 115.0 tensor([[-1.,  1.,  0.]])

# 其他常见来源
x = torch.tensor([0.0, 4.0], requires_grad=True)
torch.sqrt(x).sum().backward()
print(x.grad)  # tensor([   inf, 0.2500]),sqrt在0处的导数为无穷大

x = torch.tensor([0.0, 4.0], requires_grad=True)
torch.where(x > 0, torch.sqrt(x), torch.zeros_like(x)).sum().backward()
print(x.grad)  # tensor([   nan, 0.2500]),where不能挡住另一个分支的梯度

print(torch.tensor(0.0) / torch.tensor(0.0))  # tensor(nan)
print(torch.tensor(1000.0).exp())             # tensor(inf)
print(torch.tensor(1000.0).exp() * 0)         # tensor(nan),inf参与运算后很容易变成nan
torch.where的例子容易被忽略:前向传播的结果是对的,但反向传播时没有被选中的分支仍然会计算梯度,无穷大乘以 0 得到 NaN。应当在进入sqrt之前处理输入,而不是在之后挑选结果
学习率过大
学习率过大时损失不是突然变成 NaN 的,而是每一步都比上一步大,直到溢出。输入没有归一化时更容易出现,因为梯度的大小与输入的数值范围成正比。每一步用torch.isfinite检查损失,出现问题时立刻停下,比训练结束后才发现全是 NaN 要好
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import torch
from torch import nn

torch.manual_seed(0)
x = torch.rand(256, 4) * 100  # 输入没有归一化,数值范围为0~100
y = x.sum(dim=1, keepdim=True)

def train(x, y, lr, steps=200):
    torch.manual_seed(0)
    model = nn.Linear(4, 1)
    optimizer = torch.optim.SGD(model.parameters(), lr=lr)
    for step in range(1, steps + 1):
        loss = nn.functional.mse_loss(model(x), y)
        if not torch.isfinite(loss):
            print(f"lr={lr}  step {step}: loss = {loss.item()},停止训练")
            return
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        if step <= 3 or step == 7:
            print(f"lr={lr}  step {step}: loss = {loss.item():.4g}")
    print(f"lr={lr}  step {step}: loss = {loss.item():.4g}")

train(x, y, lr=0.01)
train(x, y, lr=0.00001)  # 降低学习率
train((x - x.mean(dim=0)) / x.std(dim=0), (y - y.mean()) / y.std(), lr=0.1)  # 对数据做标准化
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
lr=0.01  step 1: loss = 5.541e+04
lr=0.01  step 2: loss = 2.553e+09
lr=0.01  step 3: loss = 1.181e+14
lr=0.01  step 7: loss = 5.422e+32
lr=0.01  step 8: loss = inf,停止训练
lr=1e-05  step 1: loss = 5.541e+04
lr=1e-05  step 2: loss = 3.414e+04
lr=1e-05  step 3: loss = 2.107e+04
lr=1e-05  step 7: loss = 3183
lr=1e-05  step 200: loss = 0.2975
lr=0.1  step 1: loss = 1.844
lr=0.1  step 2: loss = 1.224
lr=0.1  step 3: loss = 0.8137
lr=0.1  step 7: loss = 0.1596
lr=0.1  step 200: loss = 9.236e-14
输入的范围为 0 到 100 时,学习率要降到 0.00001 才不发散;对数据做标准化之后,学习率 0.1 就能很快收敛。梯度偶尔出现很大的值时,可以在optimizer.step()之前裁剪梯度,返回值是裁剪之前的梯度范数,适合顺便记录下来
1
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
定位 NaN 的来源
前向传播中的 NaN 可以逐层检查:用torch.isfinite(output).all()检查每一层的输出,第一个不满足的层就是来源,给每一层注册前向钩子可以自动完成这件事,钩子的用法见后面的”查看梯度与激活值”。有时前向传播的结果完全正常,NaN 只出现在梯度里。torch.autograd.set_detect_anomaly(True)会在反向传播时检查每一步的结果,出现 NaN 时立刻报错,并给出对应的前向运算的位置
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
import torch
from torch import nn

def pairwise_distance(e):
    diff = e[:, None, :] - e[None, :, :]
    return torch.sqrt((diff ** 2).sum(dim=-1))  # 对角线是每个点到自己的距离,恰好为0

torch.manual_seed(0)
model = nn.Linear(4, 8)
x = torch.randn(16, 4)

loss = pairwise_distance(model(x)).mean()
loss.backward()
print(loss.item())  # 1.8669989109039307,前向传播的结果完全正常
print(torch.isfinite(model.weight.grad).all().item())  # False

model.zero_grad()
with torch.autograd.set_detect_anomaly(True):
    try:
        pairwise_distance(model(x)).mean().backward()
    except RuntimeError as e:
        print(e)  # Function 'PowBackward0' returned nan values in its 0th output.

# 修复:在开方之前加上一个很小的数
model.zero_grad()
diff = model(x)[:, None, :] - model(x)[None, :, :]
torch.sqrt((diff ** 2).sum(dim=-1) + 1e-12).mean().backward()
print(torch.isfinite(model.weight.grad).all().item())  # True
1
2
3
4
1.8669989109039307
False
Function 'PowBackward0' returned nan values in its 0th output.
True
- 报错的同时会打印一条警告,其中的调用栈指向产生这一步运算的代码,这里是
pairwise_distance中开方的那一行 - 报错的是第一个输出 NaN的运算。这个例子中
sqrt在 0 处的梯度是 Inf 而不是 NaN,传到前一步的平方时乘以 0 才变成 NaN,所以报告的是PowBackward0。真正的原因可能在报错位置的后一步运算,要连同附近的代码一起看 - 开启后训练会明显变慢,只在排查问题时使用
学习率的影响
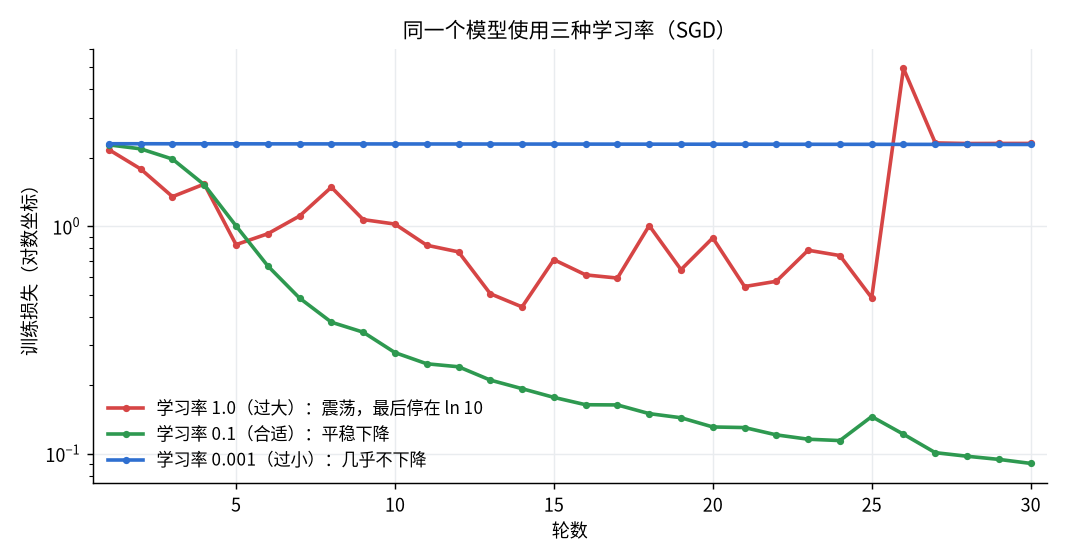
学习率是影响最大的超参数,代码确认无误之后首先调整它。同一个模型在同一份数据上使用三种学习率,每种训练 30 轮
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import torch
from sklearn.datasets import load_digits
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

digits = load_digits()
x = torch.tensor(digits.data, dtype=torch.float32) / 16
y = torch.tensor(digits.target)
criterion = nn.CrossEntropyLoss()

def train(lr, epochs=30):
    torch.manual_seed(0)
    model = nn.Sequential(nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 64), nn.ReLU(), nn.Linear(64, 10))
    optimizer = torch.optim.SGD(model.parameters(), lr=lr)
    loader = DataLoader(TensorDataset(x, y), batch_size=64, shuffle=True)
    history = []
    for epoch in range(epochs):
        total = 0.0
        for xb, yb in loader:
            loss = criterion(model(xb), yb)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            total += loss.item() * len(xb)
        history.append(total / len(x))
    return history

for lr in (1.0, 0.1, 0.001):
    history = train(lr)
    print(f"lr={lr:<6}" + "  ".join(f"{history[i]:.4f}" for i in (0, 4, 9, 19, 29)))
每一行依次为第 1、5、10、20、30 轮的平均损失
1
2
3
lr=1.0   2.1690  0.8296  1.0216  0.8884  2.3100
lr=0.1   2.2771  1.0031  0.2783  0.1311  0.0907
lr=0.001 2.3033  2.3010  2.2980  2.2921  2.2861
| 学习率 | 曲线的特征 | 处理方法 |
|---|---|---|
| 过大 | 损失上下震荡,突然增大,停在$\ln K$附近或变成 NaN | 每次缩小到原来的 1/10 再试 |
| 合适 | 损失平稳下降,前期快、后期慢 | 后期可以配合学习率衰减 |
| 过小 | 损失下降但非常慢,曲线接近水平 | 每次放大 10 倍再试 |
- 学习率 1.0 的损失在第 26 轮突然升到 4.94,之后停在 2.31,也就是$\ln 10$:一次过大的更新之后模型对所有输入都给出相同的预测,之后再也没有恢复
- 学习率过小与代码有错误的曲线很像,都是损失几乎不变,区别在于前者仍在缓慢下降。所以要先做单批次过拟合,排除代码的问题
- 学习率按 10 倍的间隔搜索,例如 1、0.1、0.01、0.001,找到合适的量级后再细调。合适的范围与优化器有关,
SGD常用 0.1 到 0.01,Adam常用 0.001 左右
查看梯度与激活值
各层的梯度范数
反向传播时梯度从输出层逐层传回输入层。每一层的梯度范数相差几个数量级时,梯度小的层几乎不更新,这就是梯度消失。在一次backward()之后读取每个参数的.grad即可
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
import torch
from torch import nn

def make_mlp(activation, depth=10, width=64, kaiming=False):
    layers = []
    for i in range(depth):
        layers += [nn.Linear(64 if i == 0 else width, width), activation()]
    model = nn.Sequential(*layers, nn.Linear(width, 10))
    if kaiming:
        for m in model:
            if isinstance(m, nn.Linear):
                nn.init.kaiming_normal_(m.weight, nonlinearity="relu")
                nn.init.zeros_(m.bias)
    return model

def grad_norms(model):
    """每个线性层权重的梯度范数,从输入端到输出端"""
    return [m.weight.grad.norm().item() for m in model if isinstance(m, nn.Linear)]

torch.manual_seed(0)
x = torch.randn(256, 64)
y = torch.randint(0, 10, (256,))

for name, activation, kaiming in [("Sigmoid", nn.Sigmoid, False), ("ReLU", nn.ReLU, False), ("ReLU + Kaiming", nn.ReLU, True)]:
    torch.manual_seed(0)
    model = make_mlp(activation, kaiming=kaiming)
    nn.CrossEntropyLoss()(model(x), y).backward()
    norms = grad_norms(model)
    print(f"{name}: 第一层 {norms[0]:.1e}  最后一层 {norms[-1]:.1e}  比值 {norms[0] / norms[-1]:.1e}")
    print("  " + " ".join(f"{n:.0e}" for n in norms))
1
2
3
4
5
6
Sigmoid: 第一层 1.2e-09  最后一层 3.6e-01  比值 3.3e-09
  1e-09 7e-09 5e-08 4e-07 2e-06 2e-05 1e-04 9e-04 7e-03 5e-02 4e-01
ReLU: 第一层 7.4e-05  最后一层 2.5e-02  比值 3.0e-03
  7e-05 7e-05 7e-05 7e-05 9e-05 2e-04 5e-04 1e-03 3e-03 9e-03 2e-02
ReLU + Kaiming: 第一层 3.9e-01  最后一层 4.3e-01  比值 8.9e-01
  4e-01 4e-01 5e-01 6e-01 7e-01 1e+00 1e+00 1e+00 7e-01 5e-01 4e-01
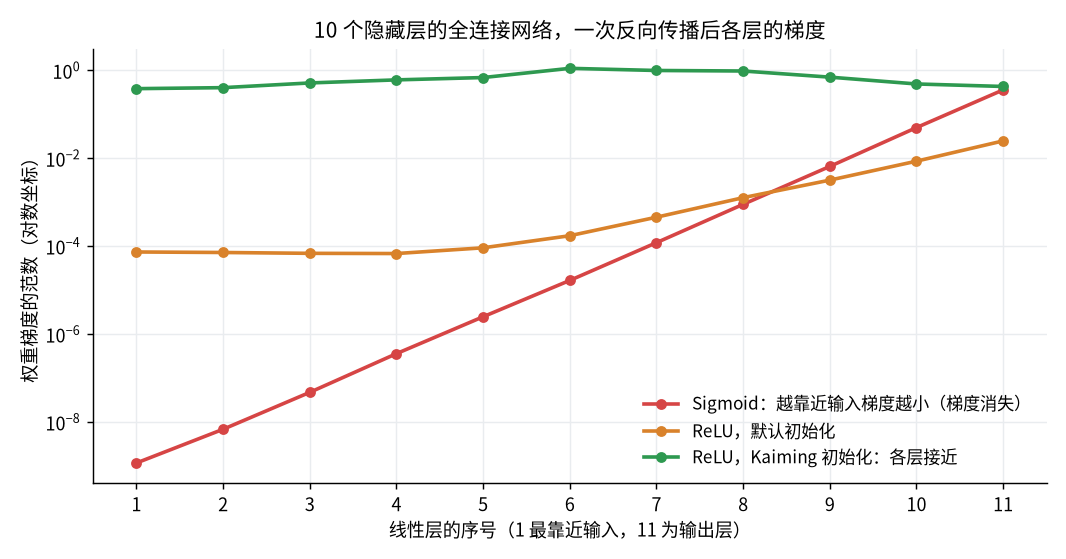
Sigmoid的导数最大只有 0.25,每经过一层梯度大约缩小到原来的 1/7,10 层之后第一层的梯度只有最后一层的十亿分之三ReLU配合nn.Linear默认的初始化时,梯度仍然缩小了几百倍;换成 Kaiming 初始化之后各层的梯度处于同一量级- 较深的网络还需要残差连接和归一化层,才能让梯度稳定地传到前面的层
- 梯度范数突然变得很大是梯度爆炸的信号,处理方法是降低学习率和裁剪梯度
用前向钩子统计激活值
register_forward_hook可以在不修改模型代码的情况下拿到任意一层的输出。钩子函数的三个参数依次为层本身、输入(元组)、输出
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import torch
from torch import nn

def activation_stats(model, x, layer_type=nn.ReLU):
    """用前向钩子收集每个激活层输出的均值、标准差和零值比例"""
    stats, handles = { }, []

    def make_hook(name):
        def hook(module, inputs, output):
            stats[name] = (output.mean().item(), output.std().item(), (output == 0).float().mean().item())
        return hook

    for name, module in model.named_modules():
        if isinstance(module, layer_type):
            handles.append(module.register_forward_hook(make_hook(name)))
    with torch.no_grad():
        model(x)
    for handle in handles:
        handle.remove()  # 用完后移除钩子,否则每次前向传播都会执行
    return stats

def make_mlp(depth=10, width=64):
    layers = []
    for i in range(depth):
        layers += [nn.Linear(width, width), nn.ReLU()]
    return nn.Sequential(*layers, nn.Linear(width, 10))

torch.manual_seed(0)
x = torch.randn(256, 64)
model = make_mlp()
for name, (mean, std, zero) in activation_stats(model, x).items():
    print(f"层 {name:>2}  均值 {mean:.4f}  标准差 {std:.4f}  零值比例 {zero:.2f}")
1
2
3
4
5
6
7
8
9
10
层  1  均值 0.2224  标准差 0.3315  零值比例 0.51
层  3  均值 0.0939  标准差 0.1330  零值比例 0.48
层  5  均值 0.0537  标准差 0.0705  零值比例 0.44
层  7  均值 0.0384  标准差 0.0516  零值比例 0.44
层  9  均值 0.0246  标准差 0.0429  零值比例 0.65
层 11  均值 0.0207  标准差 0.0356  零值比例 0.56
层 13  均值 0.0300  标准差 0.0451  零值比例 0.58
层 15  均值 0.0354  标准差 0.0481  零值比例 0.47
层 17  均值 0.0350  标准差 0.0497  零值比例 0.52
层 19  均值 0.0300  标准差 0.0438  零值比例 0.52
| 统计量 | 异常的表现 | 含义 |
|---|---|---|
| 标准差 | 逐层缩小到接近 0 | 信号在前向传播中逐渐消失,对应的梯度也会消失,检查初始化 |
| 标准差 | 逐层增大 | 信号逐层放大,容易溢出,检查初始化和归一化层 |
| 零值比例 | ReLU之后接近 1 | 这一层的神经元大多已经失活,不再更新,通常由学习率过大造成 |
| 均值 | Sigmoid、Tanh的输出集中在两端 | 激活函数饱和,梯度接近 0 |
这里使用的是默认初始化,标准差从第一层的 0.33 降到 0.04 左右,与上一节中梯度逐层缩小的现象一致。零值比例在 0.5 左右是正常的
过拟合与欠拟合
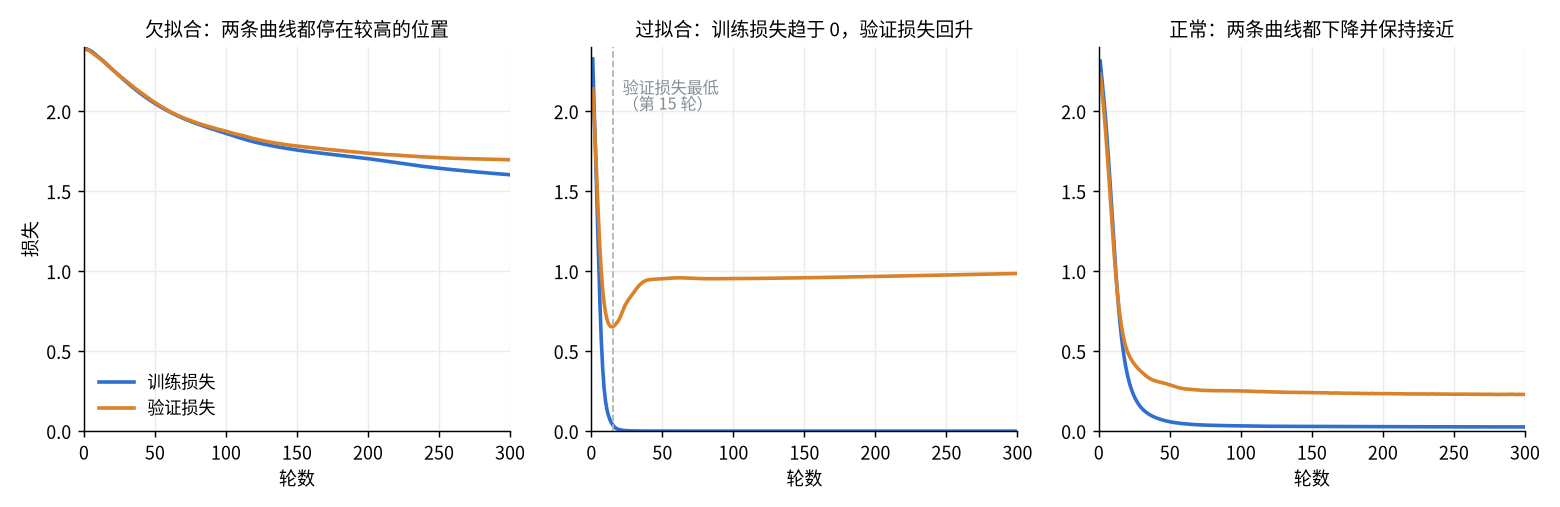
代码正确、学习率合适之后,剩下的问题通过对比训练和验证两条损失曲线来判断。用三组设置训练同一种结构的模型:隐藏层只有 2 个神经元;隐藏层有 256 个神经元但只用 100 个训练样本;隐藏层 64 个神经元、使用全部训练样本并加上权重衰减
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import torch
from sklearn.datasets import load_digits
from torch import nn

digits = load_digits()
x = torch.tensor(digits.data, dtype=torch.float32) / 16
y = torch.tensor(digits.target)
x_val, y_val = x[1297:], y[1297:]  # 后500张作为验证集
criterion = nn.CrossEntropyLoss()

def train(name, n_train, hidden, weight_decay=0.0, epochs=300):
    torch.manual_seed(0)
    x_train, y_train = x[:n_train], y[:n_train]
    model = nn.Sequential(nn.Linear(64, hidden), nn.ReLU(), nn.Linear(hidden, 10))
    optimizer = torch.optim.Adam(model.parameters(), lr=0.01, weight_decay=weight_decay)
    history = []
    for epoch in range(epochs):
        model.train()
        loss = criterion(model(x_train), y_train)
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
        model.eval()
        with torch.no_grad():
            out = model(x_val)
            history.append((loss.item(), criterion(out, y_val).item(), (out.argmax(dim=1) == y_val).float().mean().item()))
    best = min(range(epochs), key=lambda i: history[i][1])
    print(f"{name}  训练损失 {history[-1][0]:.4f}  验证损失 {history[-1][1]:.4f}  验证准确率 {history[-1][2]:.4f}"
          f"  验证损失最低在第 {best + 1} 轮({history[best][1]:.4f})")
    return history

train("欠拟合", n_train=1297, hidden=2)
train("过拟合", n_train=100, hidden=256)
train("正常  ", n_train=1297, hidden=64, weight_decay=0.001)
1
2
3
欠拟合  训练损失 1.6030  验证损失 1.6968  验证准确率 0.3020  验证损失最低在第 300 轮(1.6968)
过拟合  训练损失 0.0001  验证损失 0.9856  验证准确率 0.8080  验证损失最低在第 15 轮(0.6525)
正常    训练损失 0.0263  验证损失 0.2295  验证准确率 0.9360  验证损失最低在第 281 轮(0.2293)
| 情况 | 曲线的特征 | 处理方法 |
|---|---|---|
| 欠拟合 | 训练损失和验证损失都比较高,两者很接近 | 增大模型,训练更长时间,提高学习率,减弱正则化,检查输入的特征是否足够 |
| 过拟合 | 训练损失持续下降到接近 0,验证损失先降后升,两者差距越来越大 | 增加数据,数据增强,权重衰减,Dropout,减小模型,早停 |
| 正常 | 两条曲线都下降后趋于平稳,验证损失略高于训练损失 | 保存验证损失最低的模型 |
- 过拟合的例子中验证损失在第 15 轮最低(0.65),训练到第 300 轮时升到 0.99。早停就是在验证损失不再下降时停止训练,并使用验证损失最低时的参数
- 验证损失回升时验证准确率不一定下降,因为损失还反映了预测的置信度:模型对错误的预测越来越确定,损失就会变大。以哪个指标为准取决于任务
- 验证损失明显低于训练损失时,通常是因为训练时有
Dropout和数据增强而验证时没有,或者训练损失是一轮中的平均值而验证是在这一轮结束后计算的;如果差距很大,要检查验证集是否与训练集有重复的样本 - 正则化的各种方法见Normalization and Regularization