Experiment Tracking
整理训练实验的记录与比较方法,包括需要记录的内容、实验目录的组织、日志与指标文件、在训练脚本中记录以及多次实验的比较
深度学习系列:第 14 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
PyTorch Training整理了训练循环本身。真正做实验时,同一个模型往往要换着学习率、种子、数据增强跑上几十次,几周之后再回头看,经常已经说不清某个结果是用哪份代码、哪组参数跑出来的。这里整理怎样把每次训练的信息完整地记录下来,以及怎样比较多次实验
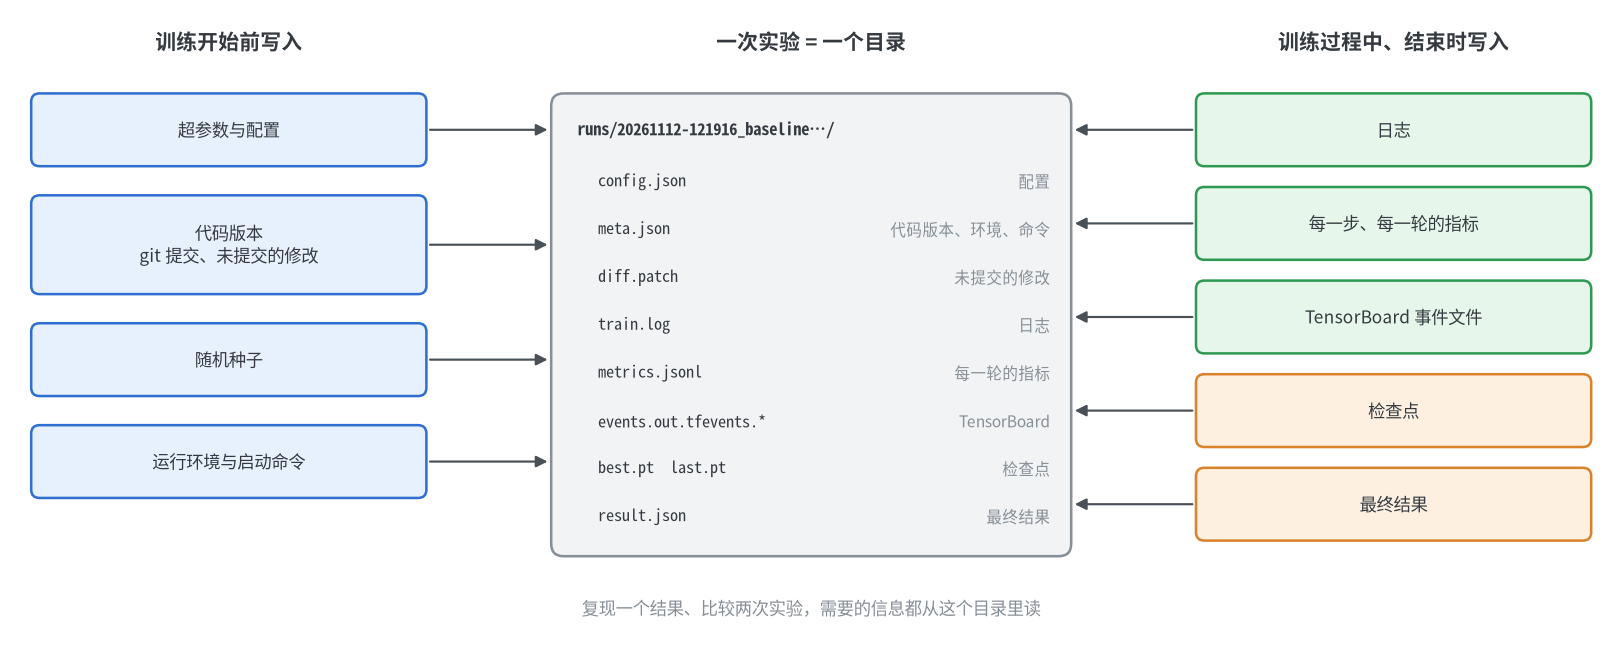
需要记录什么
判断一项信息要不要记录,标准只有一个:一个月后要复现这个结果、或者要解释两次实验为什么不同时,是否需要它
| 内容 | 例子 | 缺少时的后果 |
|---|---|---|
| 超参数与配置 | 学习率、批大小、轮数、权重衰减、模型结构 | 无法复现,也无法知道两次实验差在哪个参数 |
| 代码版本 | git 提交号,是否有未提交的修改 | 代码改过之后,同样的配置跑不出同样的结果 |
| 随机种子 | 参数初始化、数据打乱的种子 | 无法区分差异来自参数还是来自随机性 |
| 运行环境 | Python、PyTorch 版本,GPU 型号,启动命令 | 换机器、升级版本后结果变了,找不到原因 |
| 过程指标 | 每一步的损失、学习率,每一轮的验证指标 | 只有最终数字,看不出是否发散、过拟合、何时最好 |
| 检查点 | 最好一轮和最后一轮的参数 | 只能重新训练才能拿到模型 |
| 最终结果 | 最好的验证准确率,在第几轮 | 比较几十次实验时要逐个打开日志去找 |
- 配置、代码版本、种子、环境都要在训练开始之前写入。训练中途崩溃时,这些信息最有用
- 只记录 git 提交号是不够的:做实验时经常是改了几行就直接运行,没有提交。所以还要记录是否有未提交的修改,有的话把差异也存下来
- 种子固定后结果是否完全可复现,见PyTorch Checkpoints and Reproducibility
实验目录的组织
每次训练建一个单独的目录,目录名由启动时间和实验名组成,所有与这次训练有关的文件都放在里面。时间放在前面,按名字排序就是按时间排序;实验名中写上最关心的几个超参数,在文件列表和 TensorBoard 中一眼就能分辨
1
2
3
4
5
6
7
8
9
10
11
12
13
runs/
├── 20261112-121916_baseline_lr0.003_seed0/
│   ├── config.json                       # 超参数
│   ├── meta.json                         # git 提交号、启动命令、运行环境
│   ├── diff.patch                        # 有未提交的修改时才有
│   ├── train.log                         # 日志
│   ├── metrics.jsonl                     # 每一轮的指标,一行一条
│   ├── events.out.tfevents.<时间戳>.<主机名>.<进程号>.0   # TensorBoard 事件文件
│   ├── best.pt                           # 验证集上最好的一轮的参数
│   ├── last.pt                           # 最后一轮的检查点,用于中断后恢复
│   └── result.json                       # 最终结果
├── 20261112-121937_sweep_lr0.0003_seed0/
└── ...
下面把记录用的函数放在一个单独的文件tracking.py中,后面的训练脚本都导入它。这个文件分三段给出,按顺序放在一起就是完整的文件
配置
配置用dataclass定义:字段有类型和默认值,IDE 可以补全,拼错字段名时直接报错,而用字典时拼错的键只会悄悄地变成一个新的键。asdict把它转成字典,再用json保存
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
import argparse
import json
import logging
import platform
import subprocess
import sys
import time
from dataclasses import dataclass, fields
from pathlib import Path

import torch

@dataclass
class Config:
    name: str = "baseline"       # 实验名,写进目录名
    seed: int = 0
    epochs: int = 30
    batch_size: int = 64
    lr: float = 3e-3
    weight_decay: float = 0.05
    dropout: float = 0.3

def parse_config(argv=None):
    """每个字段自动成为一个命令行参数,例如 --lr 0.001 --seed 1"""
    parser = argparse.ArgumentParser()
    for field in fields(Config):
        parser.add_argument(f"--{field.name}", type=field.type, default=field.default)
    return Config(**vars(parser.parse_args(argv)))

def save_json(obj, path):
    Path(path).write_text(json.dumps(obj, indent=2, ensure_ascii=False) + "\n", encoding="utf-8")

def load_config(path):
    return Config(**json.loads(Path(path).read_text(encoding="utf-8")))

def make_run_dir(root, name):
    run_dir = Path(root) / f"{time.strftime('%Y%m%d-%H%M%S')}_{name}"
    run_dir.mkdir(parents=True, exist_ok=False)  # 目录已存在时报错,而不是覆盖之前的实验
    return run_dir
parse_config遍历Config的字段生成命令行参数,增加一个超参数时只需要在Config里加一行- 不要给布尔字段写
type=bool:bool("False")为True,传入--flag False得到的仍是True。布尔字段改用action=argparse.BooleanOptionalAction,命令行写--flag或--no-flag exist_ok=False使目录已经存在时报错。两次运行在同一秒内启动、名字又相同时会撞上,这时宁可报错也不要把两次实验混在一起- 配置也常用 YAML 格式保存,可读性更好、可以写注释,但需要另外安装
PyYAML;json是标准库,并且能原样读回,这里用它
代码版本与运行环境
在 Python 中调用git命令取得当前的提交号,用git status --porcelain判断是否有未提交的修改:它的输出每行对应一个改动过的文件,输出为空就说明工作区是干净的
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
def git(*args):
    return subprocess.run(["git", *args], capture_output=True, text=True, check=True).stdout.strip()

def git_info():
    try:
        return {
            "commit": git("rev-parse", "HEAD"),
            "branch": git("rev-parse", "--abbrev-ref", "HEAD"),
            "dirty": git("status", "--porcelain") != "",  # 有未提交的修改或未跟踪的文件
        }
    except (subprocess.CalledProcessError, FileNotFoundError):
        return None                                       # 不在git仓库中,或没有安装git

def save_code_state(run_dir):
    """记录代码版本、运行环境和启动命令;有未提交的修改时把差异也存下来"""
    info = git_info()
    meta = {
        "git": info,
        "command": " ".join(sys.argv),
        "time": time.strftime("%Y-%m-%d %H:%M:%S"),
        "host": platform.node(),
        "python": platform.python_version(),
        "torch": torch.__version__,
        "cuda": torch.version.cuda if torch.cuda.is_available() else None,
        "gpu": torch.cuda.get_device_name(0) if torch.cuda.is_available() else None,
    }
    save_json(meta, Path(run_dir) / "meta.json")
    if info is not None and info["dirty"]:
        (Path(run_dir) / "diff.patch").write_text(git("diff", "HEAD") + "\n", encoding="utf-8")
    return meta
git diff HEAD包含已暂存和未暂存的修改,但不包含未跟踪的新文件。新写的代码文件要先git add,否则差异里没有它- 训练结果、检查点和事件文件不要放进版本控制,在
.gitignore中写上runs*/,Python 的缓存目录__pycache__/也一样。否则每次训练都会让工作区变“脏” - 在 CPU 上运行时
cuda和gpu两项记为null
日志
logging
用print输出的信息只出现在终端里,用nohup或tmux在后台跑时很容易丢,也没有时间。标准库的logging可以同时输出到终端和文件,每条都带时间和级别
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
def setup_logger(run_dir):
    logger = logging.getLogger("train")
    logger.setLevel(logging.INFO)
    logger.handlers.clear()   # 同一个进程中多次调用时不重复添加处理器,否则每条日志会输出多遍
    logger.propagate = False  # 不再传给根日志器,避免被其他库的配置再输出一遍
    formatter = logging.Formatter("%(asctime)s %(levelname)s %(message)s", datefmt="%H:%M:%S")
    for handler in (logging.StreamHandler(sys.stdout),
                    logging.FileHandler(Path(run_dir) / "train.log", encoding="utf-8")):
        handler.setFormatter(formatter)
        logger.addHandler(handler)
    return logger

class MetricsLogger:
    """每次调用log()向文件追加一行JSON"""

    def __init__(self, path):
        self.file = open(path, "a", buffering=1, encoding="utf-8")  # 行缓冲:写完一行立即落盘

    def log(self, **row):
        self.file.write(json.dumps(row) + "\n")

    def close(self):
        self.file.close()

def read_metrics(path):
    with open(path, encoding="utf-8") as file:
        return [json.loads(line) for line in file]
| 处理器 | 输出到 | 说明 |
|---|---|---|
StreamHandler | 终端 | 传入sys.stdout,否则默认输出到标准错误 |
FileHandler | 文件 | 默认追加写入,指定encoding="utf-8"以免中文乱码 |
RotatingFileHandler | 文件,超过大小后轮换 | 很长的训练、日志很多时使用 |
- 同一个进程中第二次调用
setup_logger时,如果不先handlers.clear(),每条日志会输出两遍。在 Jupyter 中反复运行同一个单元格时最常遇到 logger.info("epoch %d", epoch)把格式化推迟到确实要输出时才做,级别被过滤掉的日志不会产生格式化的开销
指标文件
日志是给人看的,要重新画曲线、比较多次实验时,从日志里用正则表达式解析数字很麻烦。所以指标另外写一份结构化的文件:JSONL 格式每行是一个独立的 JSON 对象,追加写入,中途崩溃也只会丢掉最后一行;字段可以随时增加,不像 CSV 那样要先固定表头
MetricsLogger以行缓冲的方式打开文件,每写完一行就交给操作系统,进程崩溃时已经写入的行不会丢
试一下
下面在一个临时的 git 仓库里把前面的函数都用一遍。先提交一次,运行一遍;再改动一行不提交,再运行一遍
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import math
import os
from dataclasses import asdict

from tracking import (Config, MetricsLogger, git_info, load_config, make_run_dir, read_metrics,
                      save_code_state, save_json, setup_logger)

config = Config(name="demo", lr=1e-3)
run_dir = make_run_dir("runs_demo", config.name)
save_json(asdict(config), run_dir / "config.json")
print(load_config(run_dir / "config.json") == config)  # True,读回来的配置与原来相同
print(git_info())
save_code_state(run_dir)

logger = setup_logger(run_dir)
logger.info("run dir: %s", run_dir)
metrics = MetricsLogger(run_dir / "metrics.jsonl")
for epoch in range(1, 4):
    loss = math.exp(-epoch)                             # 用一个假的损失代替训练
    metrics.log(epoch=epoch, loss=loss)
    logger.info("epoch %d  loss %.4f", epoch, loss)
logger.warning("这条警告同样会写进文件")
metrics.close()

print(read_metrics(run_dir / "metrics.jsonl"))
print(sorted(os.listdir(run_dir)))
1
2
3
4
5
6
printf 'runs*/\n__pycache__/\n' > .gitignore   # 实验目录和 Python 的缓存不进版本控制
git init && git add -A && git commit -m "training script with experiment tracking"
python demo.py
echo "# try a change" >> demo.py   # 改动一行,不提交
python demo.py
cat runs_demo/*/diff.patch
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
True
{'commit': '96433690e744d42a0def02adc14c2bc343e08767', 'branch': 'main', 'dirty': False}
12:19:11 INFO run dir: runs_demo/20261112-121911_demo
12:19:11 INFO epoch 1  loss 0.3679
12:19:11 INFO epoch 2  loss 0.1353
12:19:11 INFO epoch 3  loss 0.0498
12:19:11 WARNING 这条警告同样会写进文件
[{'epoch': 1, 'loss': 0.36787944117144233}, {'epoch': 2, 'loss': 0.1353352832366127}, {'epoch': 3, 'loss': 0.049787068367863944}]
['config.json', 'meta.json', 'metrics.jsonl', 'train.log']
True
{'commit': '96433690e744d42a0def02adc14c2bc343e08767', 'branch': 'main', 'dirty': True}
12:19:12 INFO run dir: runs_demo/20261112-121912_demo
12:19:12 INFO epoch 1  loss 0.3679
12:19:12 INFO epoch 2  loss 0.1353
12:19:12 INFO epoch 3  loss 0.0498
12:19:12 WARNING 这条警告同样会写进文件
[{'epoch': 1, 'loss': 0.36787944117144233}, {'epoch': 2, 'loss': 0.1353352832366127}, {'epoch': 3, 'loss': 0.049787068367863944}]
['config.json', 'diff.patch', 'meta.json', 'metrics.jsonl', 'train.log']
diff --git a/demo.py b/demo.py
index f57b57c..9ecf8de 100644
--- a/demo.py
+++ b/demo.py
@@ -24,3 +24,4 @@ metrics.close()

 print(read_metrics(run_dir / "metrics.jsonl"))
 print(sorted(os.listdir(run_dir)))
+# try a change
两次运行的提交号相同,但第二次的dirty为True,目录里多了diff.patch。要复现第二次的结果,先git checkout到这个提交,再git apply diff.patch
在训练中记录
下面把PyTorch Training中的训练流程整理成一个可以从命令行传参数的脚本,同时写配置、日志、指标文件、TensorBoard 和检查点,SummaryWriter的用法见TensorBoard。数据、模型和训练过程与那篇文章相同,只是去掉了保存最佳参数的深拷贝,改为直接保存到文件
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
import json
from dataclasses import asdict

import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn
from torch.utils.data import DataLoader, TensorDataset
from torch.utils.tensorboard import SummaryWriter
from torchvision.utils import make_grid

from tracking import MetricsLogger, make_run_dir, parse_config, save_code_state, save_json, setup_logger

device = "cuda" if torch.cuda.is_available() else "cpu"

def make_loaders(batch_size):
    digits = load_digits()
    images = torch.from_numpy(digits.images).float().unsqueeze(1) / 16  # (1797, 1, 8, 8)
    labels = torch.from_numpy(digits.target).long()
    indices = torch.randperm(len(images), generator=torch.Generator().manual_seed(0))  # 划分方式与实验的种子无关
    train_idx, val_idx = indices[:1437], indices[1437:]
    mean, std = images[train_idx].mean(), images[train_idx].std()
    images = (images - mean) / std
    train_loader = DataLoader(TensorDataset(images[train_idx], labels[train_idx]),
                              batch_size=batch_size, shuffle=True, drop_last=True)
    val_loader = DataLoader(TensorDataset(images[val_idx], labels[val_idx]), batch_size=256)
    return train_loader, val_loader

def make_model(dropout):
    return nn.Sequential(
        nn.Conv2d(1, 32, kernel_size=3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
        nn.MaxPool2d(2),
        nn.Conv2d(32, 64, kernel_size=3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
        nn.AdaptiveAvgPool2d(1), nn.Flatten(),
        nn.Dropout(dropout),
        nn.Linear(64, 10),
    )

@torch.no_grad()
def evaluate(model, loader):
    model.eval()
    total_loss, correct, count = 0.0, 0, 0
    for images, labels in loader:
        images, labels = images.to(device), labels.to(device)
        logits = model(images)
        total_loss += F.cross_entropy(logits, labels, reduction="sum").item()
        correct += (logits.argmax(dim=-1) == labels).sum().item()
        count += len(labels)
    return total_loss / count, correct / count

def main():
    config = parse_config()

    # 1. 建立实验目录,训练开始之前就把配置和代码版本写进去
    run_dir = make_run_dir("runs", f"{config.name}_lr{config.lr:g}_seed{config.seed}")
    save_json(asdict(config), run_dir / "config.json")
    save_code_state(run_dir)
    logger = setup_logger(run_dir)
    metrics = MetricsLogger(run_dir / "metrics.jsonl")
    writer = SummaryWriter(run_dir)                    # 事件文件与其他记录放在同一个目录
    logger.info("run dir: %s", run_dir)
    logger.info("config: %s", config)

    torch.manual_seed(config.seed)
    train_loader, val_loader = make_loaders(config.batch_size)
    model = make_model(config.dropout).to(device)
    total_steps = config.epochs * len(train_loader)
    optimizer = torch.optim.AdamW(model.parameters(), lr=config.lr, weight_decay=config.weight_decay)
    scheduler = torch.optim.lr_scheduler.OneCycleLR(optimizer, max_lr=config.lr, total_steps=total_steps)

    writer.add_text("config", f"```json\n{json.dumps(asdict(config), indent=2)}\n```", 0)
    samples = val_loader.dataset.tensors[0][:32]
    writer.add_image("inputs", make_grid(samples, nrow=8, padding=1, normalize=True, pad_value=1.0), 0)

    step, best_accuracy, best_epoch = 0, 0.0, 0
    for epoch in range(1, config.epochs + 1):
        model.train()
        total_loss, correct, count = 0.0, 0, 0
        for images, labels in train_loader:
            images, labels = images.to(device), labels.to(device)
            logits = model(images)
            loss = F.cross_entropy(logits, labels)
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            scheduler.step()
            step += 1

            # 2. 每10步记录一次批次级别的量
            if step % 10 == 0:
                writer.add_scalar("step/loss", loss.item(), step)
                writer.add_scalar("step/lr", scheduler.get_last_lr()[0], step)
            total_loss += loss.item() * len(labels)
            correct += (logits.argmax(dim=-1) == labels).sum().item()
            count += len(labels)

        train_loss, train_accuracy = total_loss / count, correct / count
        val_loss, val_accuracy = evaluate(model, val_loader)

        # 3. 每一轮记录一次:同一组数值写进metrics.jsonl和TensorBoard,横轴都用全局步数
        metrics.log(epoch=epoch, step=step, train_loss=train_loss, train_accuracy=train_accuracy,
                    val_loss=val_loss, val_accuracy=val_accuracy)
        writer.add_scalar("loss/train", train_loss, step)
        writer.add_scalar("loss/val", val_loss, step)
        writer.add_scalar("accuracy/train", train_accuracy, step)
        writer.add_scalar("accuracy/val", val_accuracy, step)

        # 4. 直方图和日志每5轮记录一次
        if epoch % 5 == 0 or epoch == 1:
            for name, parameter in model.named_parameters():
                if parameter.ndim > 1:                 # 只记录卷积层和全连接层的权重
                    writer.add_histogram(f"weights/{name}", parameter, step)
            logger.info("epoch %2d  train loss %.4f acc %.4f  val loss %.4f acc %.4f",
                        epoch, train_loss, train_accuracy, val_loss, val_accuracy)

        # 5. 检查点
        torch.save({"model": model.state_dict(), "optimizer": optimizer.state_dict(),
                    "scheduler": scheduler.state_dict(), "epoch": epoch}, run_dir / "last.pt")
        if val_accuracy > best_accuracy:
            best_accuracy, best_epoch = val_accuracy, epoch
            torch.save(model.state_dict(), run_dir / "best.pt")

    # 6. 最终结果单独存一个文件,比较多次实验时只需要读它
    result = {"best_epoch": best_epoch, "best_val_accuracy": best_accuracy,
              "final_val_accuracy": val_accuracy, "final_val_loss": val_loss}
    save_json(result, run_dir / "result.json")
    logger.info("best epoch %d, val acc %.4f", best_epoch, best_accuracy)
    writer.add_hparams(asdict(config), {"hparam/best_val_accuracy": best_accuracy,
                                        "hparam/final_val_accuracy": val_accuracy}, run_name=".")
    writer.close()
    metrics.close()

if __name__ == "__main__":
    main()
1
python train.py
1
2
3
4
5
6
7
8
9
10
12:19:16 INFO run dir: runs/20261112-121916_baseline_lr0.003_seed0
12:19:16 INFO config: Config(name='baseline', seed=0, epochs=30, batch_size=64, lr=0.003, weight_decay=0.05, dropout=0.3)
12:19:16 INFO epoch  1  train loss 2.2931 acc 0.1378  val loss 2.2449 acc 0.2250
12:19:16 INFO epoch  5  train loss 1.1748 acc 0.8374  val loss 0.9206 acc 0.9194
12:19:16 INFO epoch 10  train loss 0.2208 acc 0.9702  val loss 0.1652 acc 0.9806
12:19:17 INFO epoch 15  train loss 0.1142 acc 0.9780  val loss 0.0814 acc 0.9889
12:19:17 INFO epoch 20  train loss 0.0676 acc 0.9908  val loss 0.0514 acc 0.9972
12:19:17 INFO epoch 25  train loss 0.0559 acc 0.9929  val loss 0.0461 acc 0.9889
12:19:17 INFO epoch 30  train loss 0.0535 acc 0.9922  val loss 0.0432 acc 0.9917
12:19:17 INFO best epoch 17, val acc 0.9972
本文的输出来自一台 CPU 为 Intel Core Ultra 9 285K、GPU 为 GeForce RTX 5090 D(32 GB 显存)、内存为 64 GB 的机器,都是在 CPU 上运行的结果。数值与PyTorch Training主循环的输出完全相同,说明加上这些记录没有改变训练本身。实验目录中的config.json和result.json如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
{
  "name": "baseline",
  "seed": 0,
  "epochs": 30,
  "batch_size": 64,
  "lr": 0.003,
  "weight_decay": 0.05,
  "dropout": 0.3
}
{
  "best_epoch": 17,
  "best_val_accuracy": 0.9972222222222222,
  "final_val_accuracy": 0.9916666666666667,
  "final_val_loss": 0.04315345022413466
}
- 记录的频率按开销和用途分开:标量每 10 步一次,每一轮的指标每轮一次,直方图每 5 轮一次,图片只在开始时记录一次
loss.item()在记录之前就已经调用过,统计这一轮的平均损失时也要用到它,所以step/loss的记录几乎没有额外开销。GPU 上训练时每次.item()都要等 GPU 算完,记录频率太高会拖慢训练- 同一组每一轮的指标同时写进
metrics.jsonl和 TensorBoard:前者方便用脚本分析,后者方便在浏览器里看
读取事件文件
事件文件是二进制格式,可以用tensorboard包中的EventAccumulator读回来。用它可以确认记录的内容是否正确,也可以把数据导出来自己画图
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import sys

from tensorboard.backend.event_processing.event_accumulator import EventAccumulator

from tracking import read_metrics

run_dir = sys.argv[1]
# size_guidance为0表示全部保留;默认每个标签只保留10000个标量、1个直方图、4张图片,多出的被抽样丢弃
accumulator = EventAccumulator(run_dir, size_guidance={"scalars": 0, "histograms": 0, "images": 0, "tensors": 0})
accumulator.Reload()                                # 读取目录下所有的事件文件

for kind, tags in accumulator.Tags().items():
    if isinstance(tags, list) and tags:
        print(f"{kind:<14}{tags}")

events = accumulator.Scalars("accuracy/val")        # 每个元素有wall_time、step、value三个字段
print(len(events), events[0].step, events[-1].step)
print([round(event.value, 4) for event in events[:5]])

rows = read_metrics(f"{run_dir}/metrics.jsonl")
print(events[-1].value, rows[-1]["val_accuracy"])   # 事件文件中的标量是32位浮点数
print(all(event.step == row["step"] and abs(event.value - row["val_accuracy"]) < 1e-6
          for event, row in zip(events, rows)))

print([(event.step, round(event.value, 4)) for event in accumulator.Scalars("step/loss")[:4]])

histograms = accumulator.Histograms("weights/10.weight")
print([event.step for event in histograms])
value = histograms[-1].histogram_value
print(value.num, round(value.min, 4), round(value.max, 4), len(value.bucket))

image = accumulator.Images("inputs")[0]
print(image.width, image.height, image.encoded_image_string[:4])
1
python read_events.py runs/20261112-121916_baseline_lr0.003_seed0
1
2
3
4
5
6
7
8
9
10
11
12
13
images        ['inputs']
histograms    ['weights/0.weight', 'weights/4.weight', 'weights/10.weight']
scalars       ['step/loss', 'step/lr', 'loss/train', 'loss/val', 'accuracy/train', 'accuracy/val', 'hparam/best_val_accuracy', 'hparam/final_val_accuracy']
distributions ['weights/0.weight', 'weights/4.weight', 'weights/10.weight']
tensors       ['config/text_summary']
30 22 660
[0.225, 0.6194, 0.7944, 0.8889, 0.9194]
0.9916666746139526 0.9916666666666667
True
[(10, 2.3126), (20, 2.2042), (30, 2.1638), (40, 2.0643)]
[22, 110, 220, 330, 440, 550, 660]
640.0 -0.4477 0.3936 566
73 37 b'\x89PNG'
- 每一轮记录一次的
accuracy/val共 30 个点,步数从 22 到 660,与metrics.jsonl中的值逐一相同,只是事件文件用 32 位浮点数保存,末几位有差别 add_text写入的文字在tensors中,标签变成了config/text_summary;add_hparams的指标同时作为标量记录weights/10.weight是最后一个全连接层的权重,共 640 个数。直方图记录的不是原始数值,而是分好的桶和最小值、最大值- 不指定
size_guidance时,EventAccumulator对每个标签默认只保留 10000 个标量、1 个直方图、4 张图片,多出的被抽样丢弃,所以上面把它们都设为 0。TensorBoard 界面同样会抽样,默认每个标签显示 1000 个标量、500 个直方图、10 张图片,界面上看到的曲线不一定包含每一个点
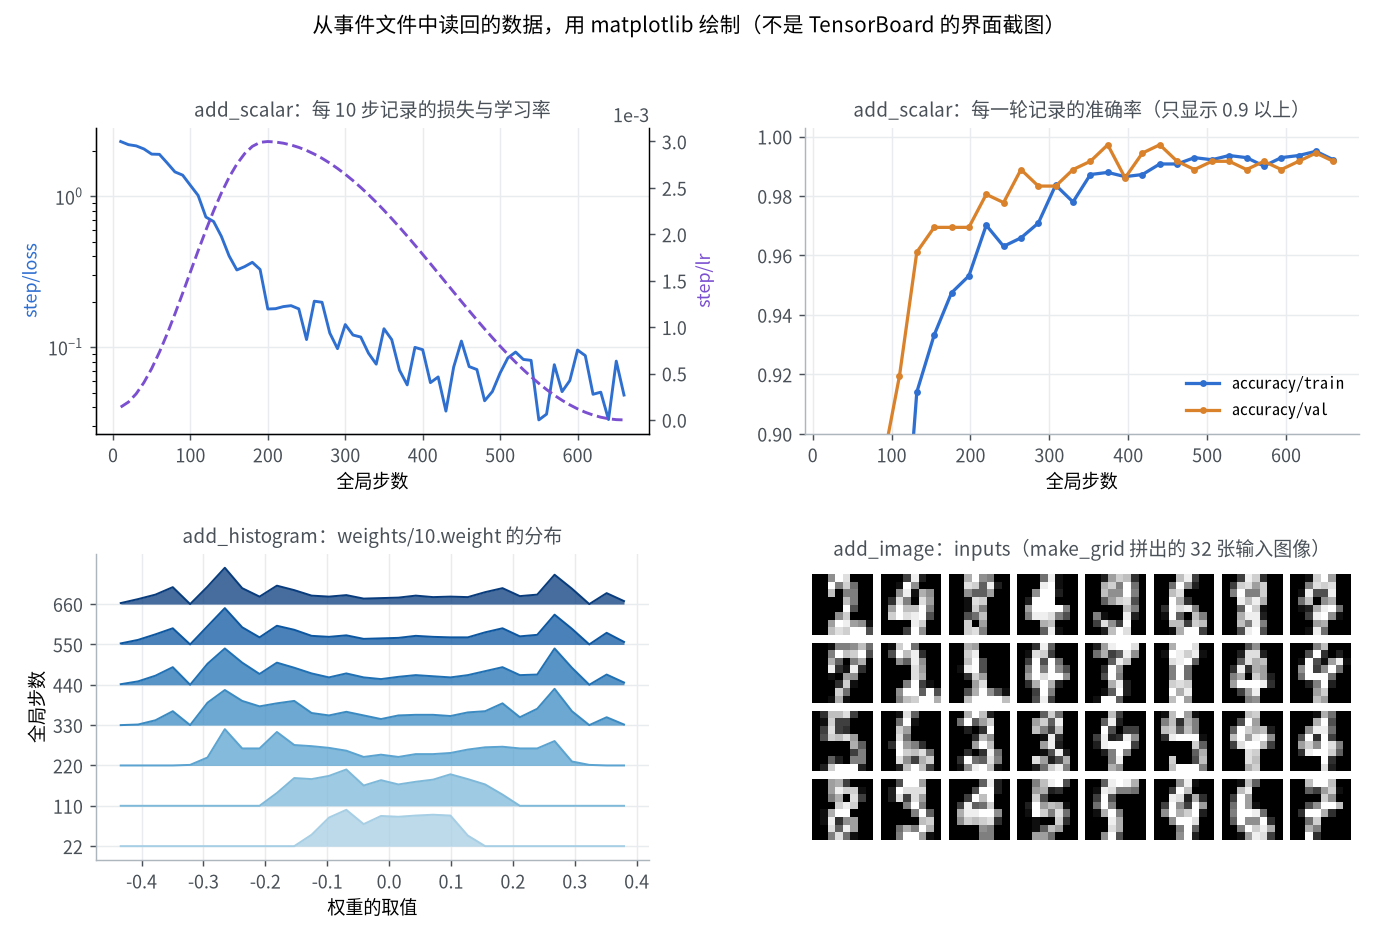
上图不是 TensorBoard 界面的截图,而是把读回的数据用 matplotlib 重新画出来的,内容与界面上对应的几个页面相同。权重的分布随训练逐渐变宽,学习率按OneCycleLR先升后降
用 metrics.jsonl 画图
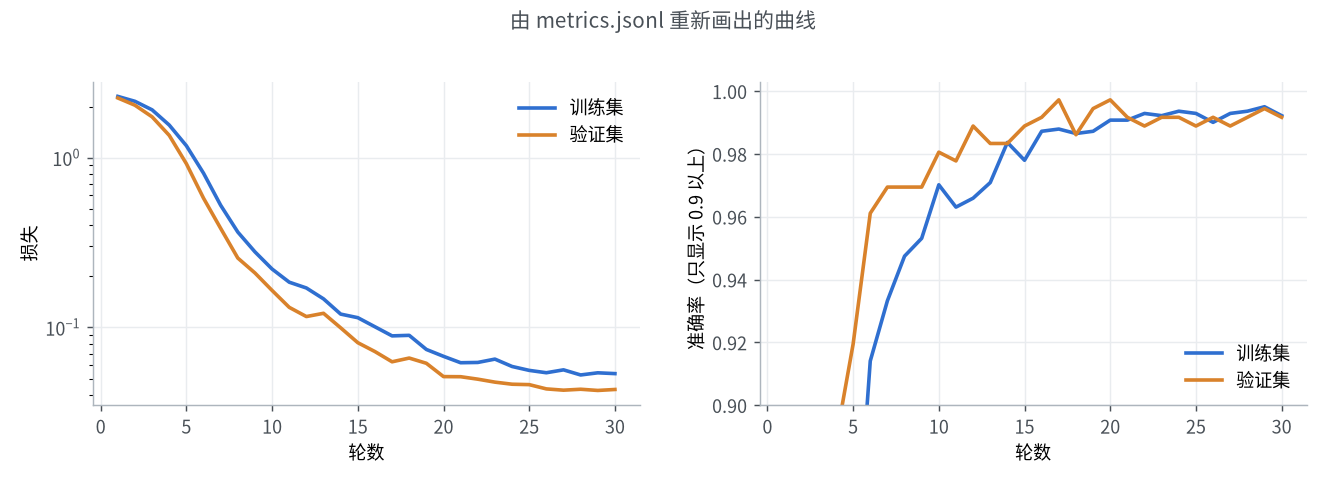
不依赖 TensorBoard,直接读metrics.jsonl也可以重新画出曲线,写论文、写报告时需要自己控制图的样式,用的就是这种方式
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import sys

import matplotlib
matplotlib.use("Agg")                               # 没有图形界面的服务器上也能画图
import matplotlib.pyplot as plt

from tracking import read_metrics

run_dir = sys.argv[1]
rows = read_metrics(f"{run_dir}/metrics.jsonl")
epochs = [row["epoch"] for row in rows]

figure, axes = plt.subplots(1, 2, figsize=(10, 3.6))
for key in ("train_loss", "val_loss"):
    axes[0].plot(epochs, [row[key] for row in rows], label=key)
axes[0].set_yscale("log")
for key in ("train_accuracy", "val_accuracy"):
    axes[1].plot(epochs, [row[key] for row in rows], label=key)
axes[1].set_ylim(0.9, 1.0)
for axis in axes:
    axis.set_xlabel("epoch")
    axis.legend()
figure.tight_layout()
figure.savefig(f"{run_dir}/curves.png", dpi=130)
print(len(rows), min(rows, key=lambda row: row["val_loss"])["epoch"])
1
30 29
共 30 轮,验证损失最低的是第 29 轮,而验证准确率最高的是第 17 轮。用哪个指标挑选最好的一轮,也要记录下来
比较多次实验
组织运行
用同一个脚本、不同的参数跑多次,实验名中包含要比较的参数。下面对 5 个学习率各用 5 个种子,共跑 25 次
1
2
3
4
5
6
for lr in 0.0003 0.001 0.003 0.01 0.03; do
    for seed in 0 1 2 3 4; do
        python train.py --name sweep --lr $lr --seed $seed > /dev/null
    done
done
ls runs
1
2
3
4
5
20261112-121916_baseline_lr0.003_seed0
20261112-121937_sweep_lr0.0003_seed0
20261112-121940_sweep_lr0.0003_seed1
20261112-121943_sweep_lr0.0003_seed2
...
在 TensorBoard 中有两种比较方式:
| 页面 | 显示的内容 | 适合 |
|---|---|---|
| SCALARS | 勾选的运行的曲线画在同一张图里 | 比较收敛速度、是否过拟合;左侧可以用正则表达式筛选运行,例如lr0.01_ |
| HPARAMS | 每个运行一行,列为add_hparams记录的超参数和指标 | 按指标排序,找出最好的配置;平行坐标视图显示超参数与指标的关系 |
运行多了以后,SCALARS 页面上几十条曲线叠在一起很难看清,种子带来的波动也和参数带来的差别混在一起。这时更可靠的做法是写一个脚本,从各个实验目录的config.json和result.json汇总
汇总与统计
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import json
import statistics
from collections import defaultdict
from pathlib import Path

runs = []
for run_dir in sorted(Path("runs").glob("*_sweep_*")):
    if not (run_dir / "result.json").exists():      # 中断或还没跑完的实验没有这个文件
        continue
    config = json.loads((run_dir / "config.json").read_text())
    result = json.loads((run_dir / "result.json").read_text())
    runs.append({**config, **result})
print(len(runs))

groups = defaultdict(list)
for run in runs:
    groups[run["lr"]].append(run)

print("lr       n  final acc (mean ± std)  min     max     best-epoch acc (mean)")
for lr in sorted(groups):
    final = [run["final_val_accuracy"] for run in groups[lr]]
    best = [run["best_val_accuracy"] for run in groups[lr]]
    print(f"{lr:<8g} {len(final)}  {statistics.mean(final):.4f} ± {statistics.stdev(final):.4f}"
          f"         {min(final):.4f}  {max(final):.4f}  {statistics.mean(best):.4f}")

for lr in (0.003, 0.01):
    print(lr, [round(run["final_val_accuracy"], 4) for run in sorted(groups[lr], key=lambda run: run["seed"])])
1
2
3
4
5
6
7
8
9
25
lr       n  final acc (mean ± std)  min     max     best-epoch acc (mean)
0.0003   5  0.9606 ± 0.0125         0.9389  0.9694  0.9628
0.001    5  0.9906 ± 0.0058         0.9833  0.9972  0.9928
0.003    5  0.9928 ± 0.0042         0.9889  0.9972  0.9956
0.01     5  0.9961 ± 0.0015         0.9944  0.9972  0.9972
0.03     5  0.9956 ± 0.0015         0.9944  0.9972  0.9983
0.003 [0.9917, 0.9889, 0.9972, 0.9889, 0.9972]
0.01 [0.9944, 0.9972, 0.9972, 0.9944, 0.9972]
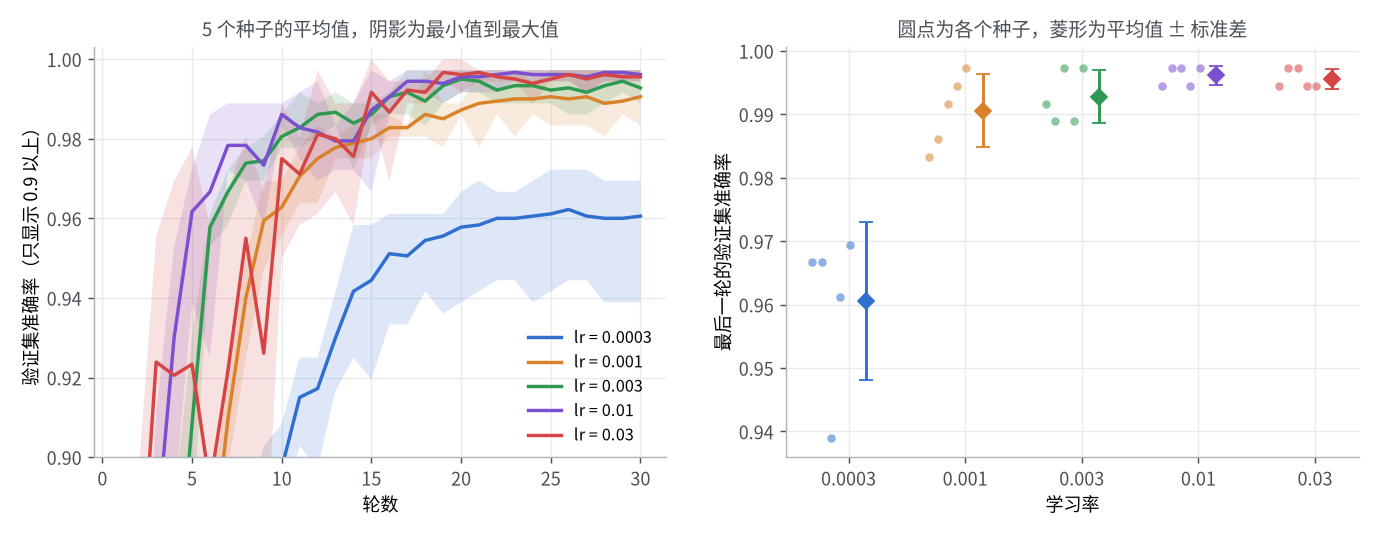
- 只换种子,学习率为 0.003 时最后一轮的准确率就在 0.9889 到 0.9972 之间变化,验证集 360 个样本,相当于差了 3 个样本。0.001、0.003、0.01、0.03 四组的范围互相重叠,只跑一个种子就说“0.01 比 0.003 好”是不可靠的
- 能明确得出的结论是 0.0003 太小:它的平均值比其他组低 3 个百分点,远大于各组内的标准差
- 报告结果时写成平均值 ± 标准差,并注明种子数,例如“0.9961 ± 0.0015(5 个种子)”。
statistics.stdev计算的是样本标准差(除以 n − 1) - “最好一轮”的准确率总是高于最后一轮,因为它是在验证集上挑出来的最大值,种子越多、轮数越多偏得越厉害。比较不同配置时要用同一种口径
- 汇总时跳过没有
result.json的目录,中断的实验不会混进统计
其他工具
TensorBoard 只负责画图,实验目录、配置和代码版本都要自己管理。下面两个工具把这些也包了进来,都需要注册账号或自己部署服务器,这里只做简单的比较
| 工具 | 部署方式 | 费用 | 比 TensorBoard 多出的功能 |
|---|---|---|---|
| TensorBoard | 本地读取事件文件 | 免费、开源 | 无 |
| Weights & Biases | 云服务,也可以私有部署 | 个人和学术免费,团队收费 | 自动记录代码版本、环境和系统资源;网页上按配置筛选、分组、汇总;超参数搜索;团队共享和报告 |
| MLflow | 本地文件,或自己部署跟踪服务器 | 免费、开源 | 实验与运行的管理和检索;保存模型文件和依赖;模型注册与版本管理 |
两者的用法都是在训练开始时初始化一次(wandb.init(config=...)、mlflow.start_run()),然后在循环中记录指标(wandb.log、mlflow.log_metric),与上面MetricsLogger的位置相同。一个人做实验、实验数量不多时,自己的实验目录加 TensorBoard 已经足够;多人协作、实验数以百计时,再考虑换成它们
常见问题
覆盖之前的实验
两次实验写进同一个目录时,TensorBoard 不会覆盖旧的记录,而是把两份数据混在一起
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
import os

from tensorboard.backend.event_processing.event_accumulator import EventAccumulator
from torch.utils.tensorboard import SummaryWriter

from tracking import make_run_dir

def read(path):
    accumulator = EventAccumulator(path)
    accumulator.Reload()
    return accumulator.Scalars("loss")

for value in (1.0, 2.0):                            # 两次实验写进同一个目录,步数都从0开始
    writer = SummaryWriter("tb_same/exp")
    for step in range(100):
        writer.add_scalar("loss", value, step)
    writer.close()
events = read("tb_same/exp")
print(len(os.listdir("tb_same/exp")), len(events), {event.value for event in events})

make_run_dir("tb_same", "exp")
try:
    make_run_dir("tb_same", "exp")                  # 同一秒内用同一个名字再建一次
except FileExistsError as error:
    print(type(error).__name__)

# 从检查点恢复训练:第一次训练到第99步,从第60步的检查点接着训练
writer = SummaryWriter("tb_same/resume")
for step in range(100):
    writer.add_scalar("loss", 1.0, step)
writer.close()
writer = SummaryWriter("tb_same/resume", purge_step=60)  # 第60步及之后的旧记录作废
for step in range(60, 120):
    writer.add_scalar("loss", 2.0, step)
writer.close()
events = read("tb_same/resume")
print(len(events), [event.step for event in events if event.value == 1.0][-1])
1
2
3
2 200 {1.0, 2.0}
FileExistsError
120 59
- 目录中有两个事件文件,读出来同一个标签有 200 个点,每一步都有两个值,界面上画出的曲线会来回跳。用带时间戳的目录名,并用
exist_ok=False在目录已存在时报错,就能避免 - 从检查点恢复训练时则相反,本来就应该写进原来的目录,但检查点之后的旧记录要作废。传入
purge_step后,读取时会丢弃旧记录中这一步及之后的部分,读出来的 120 个点中旧值只到第 59 步。读取时会打印一条“Detected out of order event.step”的提示,这是正常的
TensorBoard 本身的常见问题(记录太频繁、没有关闭SummaryWriter、事件文件过大)见TensorBoard