深度学习系列:第 15 篇,共 22 篇 用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
PyTorch Training 中的训练都在一个进程、一张显卡上完成。数据集和模型变大以后,一张显卡要么太慢,要么放不下足够大的批次,这时就要把训练分到多张显卡上。这里整理 PyTorch 中最常用的数据并行方式DistributedDataParallel(DDP)
本文的例子都可以用多个进程在 CPU 上运行,因此没有多张显卡也能检查 DDP 的每一个环节。写作时只有一张显卡可用,所以本文没有测量增加显卡带来的加速 ,文中也不给出任何加速比
几种训练方式 方式 进程 每一步做什么 现状 单卡 1 个 一张显卡完成整个批次 最简单 nn.DataParallel1 个 把批次拆到各张显卡上前向传播,梯度汇总到第一张显卡 只适合快速试一试 DistributedDataParallel每张显卡 1 个 每个进程处理自己的那份数据,反向传播时把各进程的梯度取平均 标准做法,官方推荐
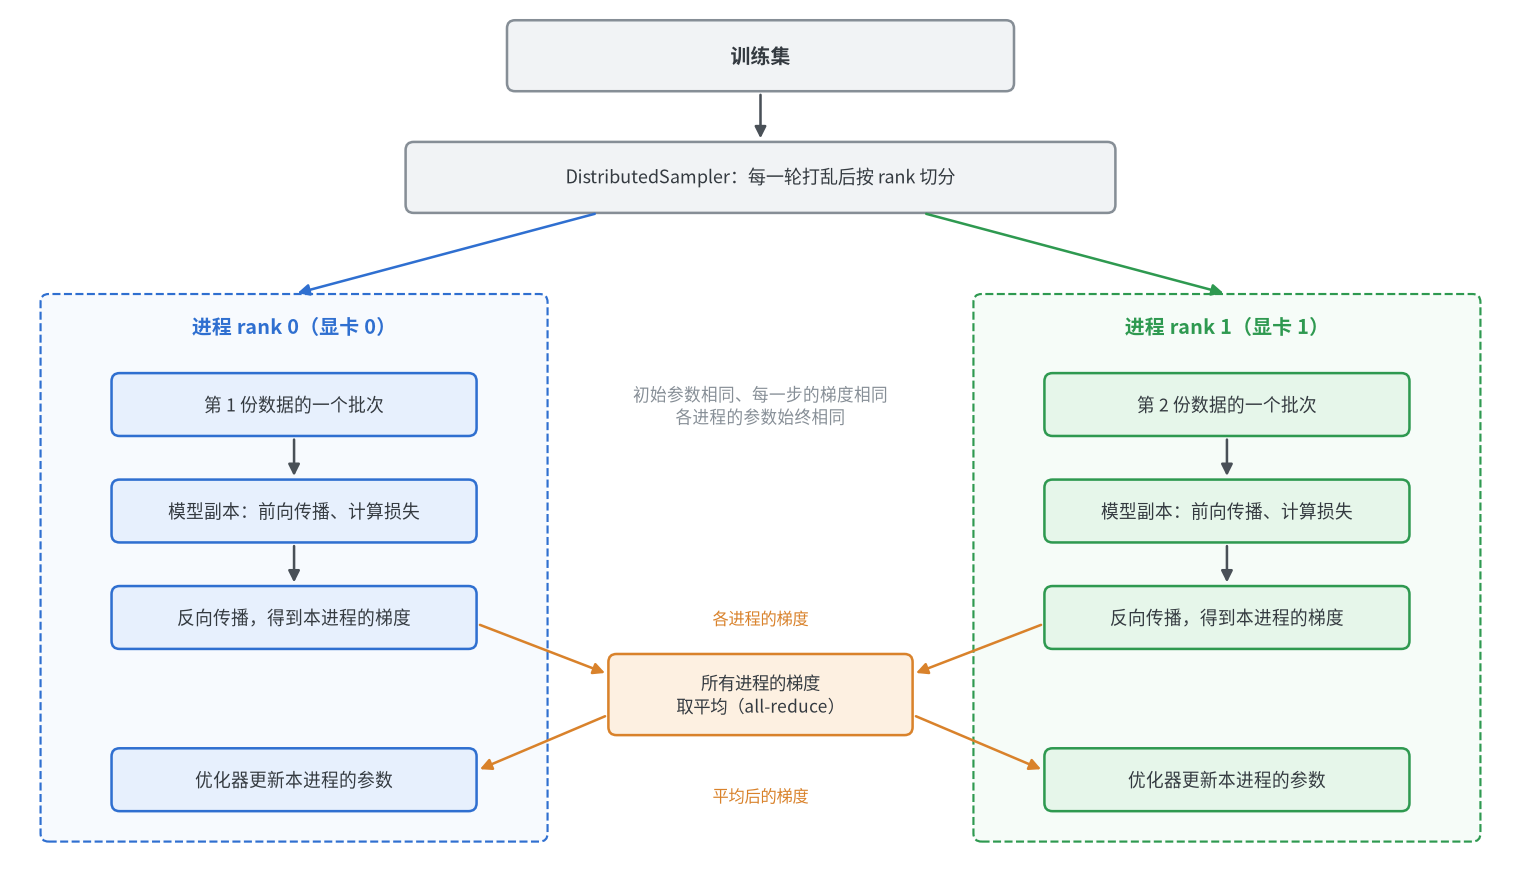
DDP 的思路是:启动和显卡数量相同的进程,每个进程持有一份完整的模型,DistributedSampler把训练集分成互不重叠的几份,每个进程只取自己那一份。反向传播时,各进程计算出的梯度通过 all-reduce 取平均,所以每个进程拿到的梯度完全相同。初始参数相同、每一步的梯度又相同,各进程的模型就始终保持一致,相当于用一个大批次训练一个模型
每张显卡由一个独立的进程控制,不受 Python 全局解释器锁的限制,也没有一张显卡负责汇总的瓶颈 通信只发生在反向传播中,而且是边计算边通信:靠后的层的梯度算出来以后就开始同步,不等整个反向传播结束 模型很大、一张显卡放不下时,数据并行就不够用了,需要 FSDP 这类把参数也切分到各张显卡上的方法,不在本文范围内 基本概念 概念 含义 进程组 参与训练的所有进程,进程之间的通信都在进程组内进行 WORLD_SIZE进程总数,单机时通常等于显卡数 RANK进程在所有进程中的编号,从 0 开始。rank 0 通常负责打印日志和保存模型 LOCAL_RANK进程在本机上的编号,用来选择本进程使用的显卡。单机时与RANK相同 后端 进程之间通信的实现。显卡之间用nccl,CPU 上用gloo
多个进程需要先“碰头”,互相知道对方的存在,才能建立进程组。torchrun负责启动这些进程,并把上表中的信息通过环境变量传给每个进程,dist.init_process_group再从环境变量中读取。下面的脚本打印这些环境变量,然后用all_reduce做一次最简单的通信
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import os
import torch
import torch.distributed as dist
names = [ " RANK " , " LOCAL_RANK " , " WORLD_SIZE " , " MASTER_PORT " ]
print ( " 环境变量: " , { name : os . environ . get ( name ) for name in names })
dist . init_process_group ( backend = " gloo " ) # 从上面的环境变量中读取所需的信息
print ( f " 进程 { os . getpid () } : rank= { dist . get_rank () } , world_size= { dist . get_world_size () } , backend= { dist . get_backend () } " )
# 每个进程准备一个不同的张量,all_reduce之后每个进程得到的都是所有进程的和
value = torch . tensor ([ 10.0 * ( dist . get_rank () + 1 )])
dist . all_reduce ( value , op = dist . ReduceOp . SUM )
print ( f " rank { dist . get_rank () } : all_reduce之后 { value } " )
dist . destroy_process_group ()
1
CUDA_VISIBLE_DEVICES = "" torchrun --nproc_per_node = 2 env.py
1
2
3
4
5
环境变量: {'RANK': '0', 'LOCAL_RANK': '0', 'WORLD_SIZE': '2', 'MASTER_PORT': '40325'}
环境变量: {'RANK': '1', 'LOCAL_RANK': '1', 'WORLD_SIZE': '2', 'MASTER_PORT': '40325'}
进程 89044: rank=1, world_size=2, backend=gloo
进程 89043: rank=0, world_size=2, backend=gloo
rank 1: all_reduce之后 tensor([30.])rank 0: all_reduce之后 tensor([30.])
两个进程运行的是同一个脚本,区别只在于环境变量不同。同一份代码根据RANK决定自己做什么,这是分布式训练代码的基本写法 all_reduce之后每个进程都得到了 10 + 20 = 30,DDP 同步梯度用的就是这个操作,只是对象换成了梯度没有指定--master_port时,这次运行自动选择了一个空闲端口 各个进程同时向终端输出,行的先后顺序每次运行都可能不同,甚至可能两行挤在一起 最小的训练脚本 下面是一个完整的 DDP 训练脚本,数据和模型都很小:8x8 的手写数字和一个两层卷积的网络。有显卡时使用nccl后端,每个进程使用一张显卡;没有显卡时使用gloo后端在 CPU 上运行,代码不需要修改。后面几节的例子都从这个文件中导入数据和模型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
import os
import torch
import torch.distributed as dist
import torch.nn as nn
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch.nn.parallel import DistributedDataParallel
from torch.utils.data import DataLoader , DistributedSampler , TensorDataset
def load_data ():
""" 8x8的手写数字,共1797张,1440张用于训练,357张用于验证 """
digits = load_digits ()
images = torch . from_numpy ( digits . images ). float (). unsqueeze ( 1 ) / 16
labels = torch . from_numpy ( digits . target ). long ()
indices = torch . randperm ( len ( labels ), generator = torch . Generator (). manual_seed ( 0 ))
train , val = indices [: 1440 ], indices [ 1440 :]
return TensorDataset ( images [ train ], labels [ train ]), TensorDataset ( images [ val ], labels [ val ])
class Net ( nn . Module ):
def __init__ ( self ):
super (). __init__ ()
self . conv1 = nn . Conv2d ( 1 , 16 , 3 , padding = 1 )
self . conv2 = nn . Conv2d ( 16 , 32 , 3 , padding = 1 )
self . fc = nn . Linear ( 32 * 2 * 2 , 10 )
def forward ( self , x ):
x = F . max_pool2d ( F . relu ( self . conv1 ( x )), 2 ) # (N, 16, 4, 4)
x = F . max_pool2d ( F . relu ( self . conv2 ( x )), 2 ) # (N, 32, 2, 2)
return self . fc ( x . flatten ( 1 ))
@torch.no_grad ()
def evaluate ( model , loader , device ):
model . eval ()
correct = 0
for images , labels in loader :
images , labels = images . to ( device ), labels . to ( device )
correct += ( model ( images ). argmax ( dim = 1 ) == labels ). sum (). item ()
return correct / len ( loader . dataset )
def main ():
# 1. 初始化进程组:rank、进程总数、主进程的地址都从torchrun设置的环境变量中读取
use_cuda = torch . cuda . is_available ()
dist . init_process_group ( backend = " nccl " if use_cuda else " gloo " )
rank , world_size = dist . get_rank (), dist . get_world_size ()
# 2. 每个进程使用自己的那一张显卡
device = torch . device ( f " cuda: { os . environ [ ' LOCAL_RANK ' ] } " if use_cuda else " cpu " )
# 3. 数据:DistributedSampler把训练集分给各个进程,shuffle交给它,DataLoader不再设置shuffle
train_set , val_set = load_data ()
sampler = DistributedSampler ( train_set , shuffle = True , seed = 0 )
train_loader = DataLoader ( train_set , batch_size = 32 , sampler = sampler , drop_last = True )
val_loader = DataLoader ( val_set , batch_size = 256 )
# 4. 模型:先放到设备上,再用DistributedDataParallel包装
torch . manual_seed ( 0 )
model = Net (). to ( device )
model = DistributedDataParallel ( model , device_ids = [ device . index ] if use_cuda else None )
optimizer = torch . optim . SGD ( model . parameters (), lr = 0.1 , momentum = 0.9 )
if rank == 0 :
print ( f " 进程数 { world_size } ,每个进程每轮 { len ( train_loader ) } 个批次,等效批大小 { 32 * world_size } " )
for epoch in range ( 5 ):
sampler . set_epoch ( epoch ) # 每一轮都要调用,否则每一轮的打乱顺序相同
model . train ()
for images , labels in train_loader :
images , labels = images . to ( device ), labels . to ( device )
loss = F . cross_entropy ( model ( images ), labels )
optimizer . zero_grad ()
loss . backward () # 各个进程的梯度在这里取平均
optimizer . step () # 每个进程用相同的梯度更新自己的模型
# 5. 日志、验证和保存只在rank 0上进行,用model.module取出原始的模型
if rank == 0 :
accuracy = evaluate ( model . module , val_loader , device )
print ( f " epoch { epoch } : 最后一个批次的损失 { loss . item () : . 4 f } ,验证准确率 { accuracy : . 4 f } " )
torch . save ( model . module . state_dict (), " model.pt " )
dist . destroy_process_group ()
if __name__ == " __main__ " :
main ()
1
2
CUDA_VISIBLE_DEVICES = "" torchrun --nproc_per_node = 2 train.py # 2 个进程,在 CPU 上运行
torchrun --nproc_per_node = 4 train.py # 单机 4 张显卡,每张显卡一个进程
1
2
3
4
5
6
进程数 2,每个进程每轮 22 个批次,等效批大小 64
epoch 0: 最后一个批次的损失 1.7133,验证准确率 0.6134
epoch 1: 最后一个批次的损失 0.2718,验证准确率 0.8207
epoch 2: 最后一个批次的损失 0.3057,验证准确率 0.9216
epoch 3: 最后一个批次的损失 0.1111,验证准确率 0.9636
epoch 4: 最后一个批次的损失 0.0235,验证准确率 0.9748
与单进程的训练相比,需要改动的地方只有下面几处
步骤 单进程 DDP 初始化 无 dist.init_process_group(backend)设备 cudacuda:{LOCAL_RANK},每个进程一张显卡打乱数据 DataLoader(shuffle=True)DataLoader(sampler=DistributedSampler(...))每一轮开始 无 sampler.set_epoch(epoch)模型 model.to(device)DistributedDataParallel(model.to(device), device_ids=…)日志与保存 直接进行 只在 rank 0 上进行,保存model.module 结束 无 dist.destroy_process_group()
训练集有 1440 个样本,2 个进程各分到 720 个,每个进程的批大小为 32,所以每轮 22 个批次。每一步实际使用 2 × 32 = 64 个样本,称为等效批大小 DistributedSampler已经负责打乱,DataLoader就不能再设置shuffle=True,两者同时设置会报错训练循环本身与单进程完全相同,梯度的同步在loss.backward()中自动完成 验证只在 rank 0 上用整个验证集进行,其他进程直接进入下一轮,在第一次反向传播的同步处等待 rank 0。验证集很大时,应把验证也分给所有进程,见下文 验证 DDP 确实在同步 DDP 的效果看不见,下面的脚本在训练过程中直接检查三件事:每个进程取到的样本是否互不重复,每一步之后各进程的参数是否完全相同,以及结果是否与单进程训练一致。为了记录取到了哪些样本,数据集多返回一个样本的下标;all_gather把每个进程上的同一个张量收集到一起,方便比较
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
import sys
import torch
import torch.distributed as dist
import torch.nn.functional as F
from torch.nn.parallel import DistributedDataParallel
from torch.utils.data import DataLoader , DistributedSampler , TensorDataset
from train import Net , load_data
batch_size , lr = int ( sys . argv [ 1 ]), float ( sys . argv [ 2 ])
dist . init_process_group ( backend = " gloo " )
rank , world_size = dist . get_rank (), dist . get_world_size ()
train_set , _ = load_data ()
images , labels = train_set . tensors
train_set = TensorDataset ( images , labels , torch . arange ( len ( labels ))) # 多返回一个下标,用来记录每个进程取到了哪些样本
sampler = DistributedSampler ( train_set , shuffle = True , seed = 0 )
loader = DataLoader ( train_set , batch_size = batch_size , sampler = sampler , drop_last = True )
torch . manual_seed ( 0 )
model = DistributedDataParallel ( Net ())
optimizer = torch . optim . SGD ( model . parameters (), lr = lr , momentum = 0.9 )
def gather ( tensor ):
""" 把每个进程上的同一个张量收集起来,返回 (world_size, ...) 的张量 """
output = [ torch . zeros_like ( tensor ) for _ in range ( world_size )]
dist . all_gather ( output , tensor )
return torch . stack ( output )
losses = []
for epoch in range ( 5 ):
sampler . set_epoch ( epoch )
seen , max_diff = [], 0.0
for images , labels , indices in loader :
loss = F . cross_entropy ( model ( images ), labels )
optimizer . zero_grad ()
loss . backward ()
optimizer . step ()
seen . append ( indices )
losses . append ( gather ( loss . detach ()). mean (). item ()) # 所有进程的损失取平均,即整个等效批次的损失
# 每一步之后比较各个进程的参数:收集到一起,计算与rank 0的最大差值
params = gather ( torch . cat ([ p . detach (). flatten () for p in model . parameters ()]))
max_diff = max ( max_diff , ( params - params [ 0 ]). abs (). max (). item ())
seen = gather ( torch . cat ( seen )) # (world_size, 每个进程本轮取到的样本数)
if rank == 0 :
total = seen . flatten (). tolist ()
print ( f " epoch { epoch } : 共取到 { len ( total ) } 个样本,其中不重复的 { len ( set ( total )) } 个,各进程参数的最大差值 { max_diff } " )
for r in range ( world_size ):
print ( f " rank { r } : { seen . shape [ 1 ] } 个样本,前 6 个的下标 { seen [ r , : 6 ]. tolist () } " )
if rank == 0 :
params = torch . cat ([ p . detach (). flatten () for p in model . parameters ()])
torch . save ({ " losses " : losses , " params " : params }, f " run_ { world_size } x { batch_size } _lr { lr } .pt " )
print ( f " 共 { len ( losses ) } 步,最后一步的损失 { losses [ - 1 ] : . 6 f } " )
dist . destroy_process_group ()
1
2
3
CUDA_VISIBLE_DEVICES = "" torchrun --nproc_per_node = 2 sync_check.py 32 0.1 # 2 个进程,每个进程批大小 32
CUDA_VISIBLE_DEVICES = "" torchrun --nproc_per_node = 1 sync_check.py 64 0.1 # 1 个进程,批大小 64
CUDA_VISIBLE_DEVICES = "" torchrun --nproc_per_node = 1 sync_check.py 32 0.1 # 1 个进程,批大小 32
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
epoch 0: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 704 个样本,前 6 个的下标 [44, 259, 883, 415, 1249, 1361]
    rank 1: 704 个样本,前 6 个的下标 [1056, 1014, 854, 1300, 504, 325]
epoch 1: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 704 个样本,前 6 个的下标 [805, 844, 155, 1421, 1215, 778]
    rank 1: 704 个样本,前 6 个的下标 [586, 692, 823, 118, 720, 423]
epoch 2: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 704 个样本,前 6 个的下标 [648, 773, 1234, 360, 368, 1330]
    rank 1: 704 个样本,前 6 个的下标 [620, 474, 1209, 183, 1401, 43]
epoch 3: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 704 个样本,前 6 个的下标 [1066, 1079, 100, 828, 1317, 964]
    rank 1: 704 个样本,前 6 个的下标 [1100, 1095, 690, 1209, 982, 810]
epoch 4: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 704 个样本,前 6 个的下标 [1210, 1219, 393, 497, 434, 178]
    rank 1: 704 个样本,前 6 个的下标 [1209, 293, 1181, 1247, 180, 358]
共 110 步,最后一步的损失 0.027162
1
2
3
epoch 4: 共取到 1408 个样本,其中不重复的 1408 个,各进程参数的最大差值 0.0
    rank 0: 1408 个样本,前 6 个的下标 [1210, 1209, 1219, 293, 393, 1181]
共 110 步,最后一步的损失 0.027162
每一轮两个进程合计取到 1408 个样本,没有重复,说明数据确实被分开了。1440 个样本每个进程 720 个,按批大小 32 丢弃最后不满的一批,各剩 704 个 每一步之后两个进程的参数差值都是 0.0,逐位相同 每一轮两个进程取到的样本都不同,这是每轮调用了set_epoch的结果 再把 2 个进程的结果与单进程的结果对比
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import json
import torch
runs = { name : torch . load ( f " run_ { name } .pt " ) for name in [ " 2x32_lr0.1 " , " 1x64_lr0.1 " , " 1x32_lr0.1 " , " 2x32_lr0.2 " ] }
ddp = runs [ " 2x32_lr0.1 " ] # 2个进程,每个进程的批大小为32,学习率0.1
for name in [ " 1x64_lr0.1 " , " 1x32_lr0.1 " ]:
other = runs [ name ]
steps = min ( len ( ddp [ " losses " ]), len ( other [ " losses " ]))
loss_diff = ( torch . tensor ( ddp [ " losses " ][: steps ]) - torch . tensor ( other [ " losses " ][: steps ])). abs (). max (). item ()
param_diff = ( ddp [ " params " ] - other [ " params " ]). abs (). max (). item ()
print ( f " 2x32_lr0.1 与 { name } : 损失的最大差值 { loss_diff : . 2 e } ,最终参数的最大差值 { param_diff : . 2 e } " )
# 每一轮的平均训练损失
for name , run in runs . items ():
losses = torch . tensor ( run [ " losses " ]). view ( 5 , - 1 ) # (轮数, 每轮的步数)
print ( f " { name } : 每轮 { losses . shape [ 1 ] } 步,各轮的平均损失 { [ round ( v , 4 ) for v in losses . mean ( dim = 1 ). tolist ()] } " )
json . dump ({ name : run [ " losses " ] for name , run in runs . items () }, open ( " curves.json " , " w " )) # 画图用
1
2
3
4
5
6
2x32_lr0.1 与 1x64_lr0.1: 损失的最大差值 4.77e-07,最终参数的最大差值 6.56e-07
2x32_lr0.1 与 1x32_lr0.1: 损失的最大差值 7.23e-01,最终参数的最大差值 6.07e-01
2x32_lr0.1: 每轮 22 步,各轮的平均损失 [2.166, 0.7764, 0.2621, 0.1483, 0.091]
1x64_lr0.1: 每轮 22 步,各轮的平均损失 [2.166, 0.7764, 0.2621, 0.1483, 0.091]
1x32_lr0.1: 每轮 45 步,各轮的平均损失 [1.6013, 0.2751, 0.172, 0.0749, 0.1154]
2x32_lr0.2: 每轮 22 步,各轮的平均损失 [1.9512, 0.4619, 0.255, 0.1579, 0.0986]
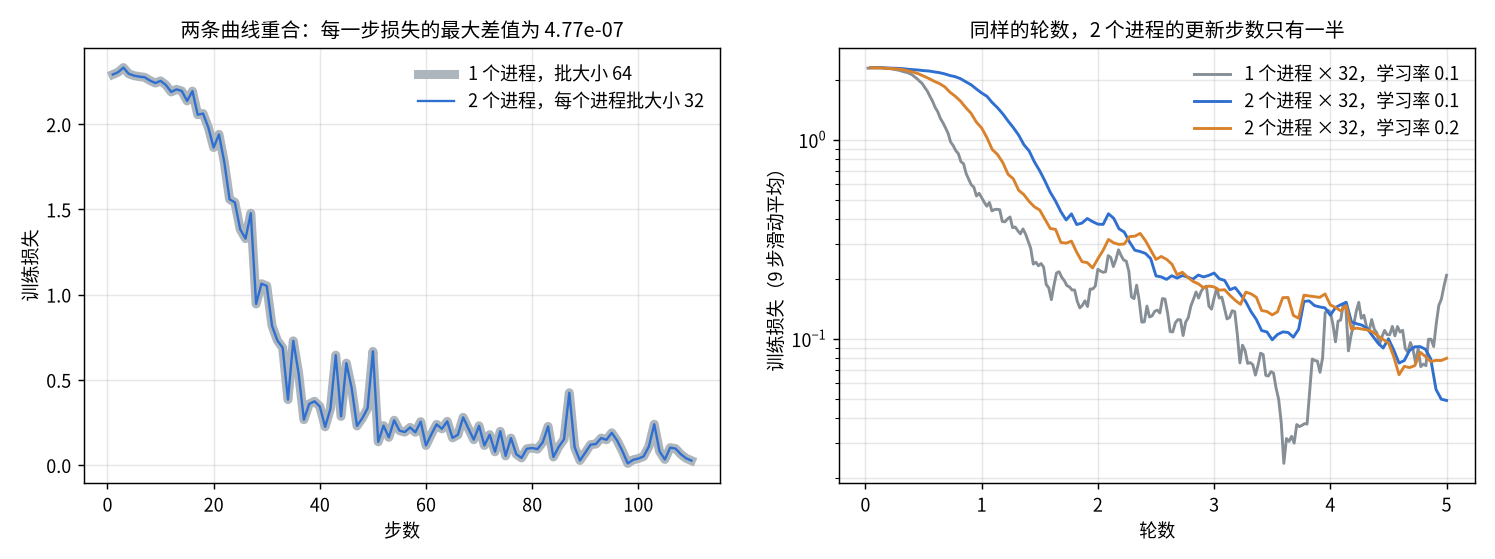
2 个进程、每个进程批大小 32,与 1 个进程、批大小 64 的训练几乎完全相同。 110 步中每一步的损失最大只差 4.77e-07,最终参数最大只差 6.56e-07。这里能对上,是因为两者每一步用到的样本恰好相同:DistributedSampler先用同一个种子打乱整个数据集,再让 rank 0 取第 0、2、4……个,rank 1 取第 1、3、5……个。所以两个进程的第一个批次合起来,正好是单进程打乱后的前 64 个样本,对比单进程最后一轮的下标[1210, 1209, 1219, 293, 393, 1181]和 2 个进程最后一轮的下标就能看出来。损失是批次内的平均值,两个 32 个样本的平均梯度再取平均,等于 64 个样本的平均梯度
剩下的 1e-07 量级的差异来自浮点数的计算顺序:先在 32 个样本内求和、再在两个进程之间求平均,与一次对 64 个样本求平均的舍入误差不同。这种差异会随训练逐渐累积,训练更久时两者不会保持逐位相同,但不影响结果
这种等价有两个前提:模型中没有 BatchNorm(它的统计量只在每个进程自己的 32 个样本上计算,见下文),损失是对批次求平均。与 1 个进程、批大小 32 的训练相比,2 个进程每轮只更新 22 步而不是 45 步,两者就完全不同了
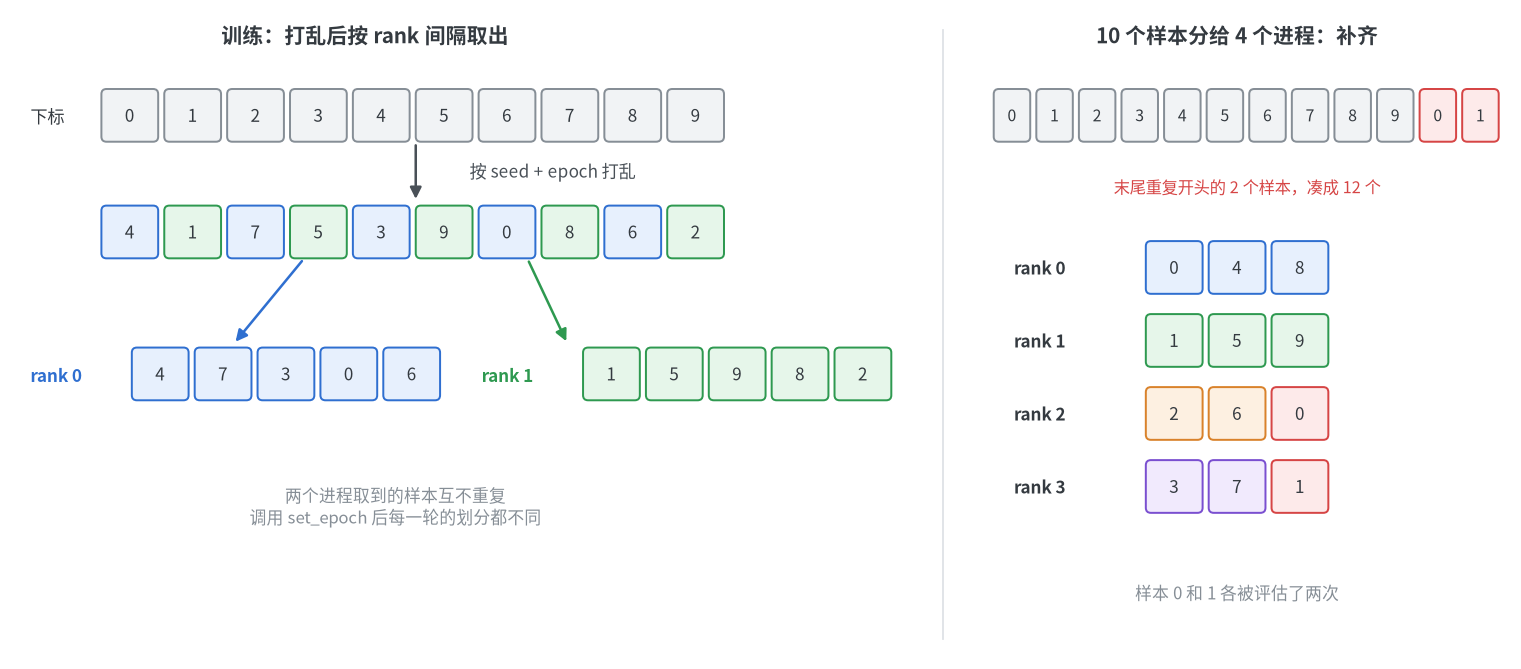
需要注意的地方 每一轮调用 set_epoch DistributedSampler用seed + epoch作为打乱的种子,epoch需要在每一轮开始时由set_epoch设置。忘记调用不会报错,但每一轮的顺序都与第一轮相同
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
from torch.utils.data import DistributedSampler
dataset = range ( 10 ) # 10个样本,下标0到9
# 不调用set_epoch:每一轮的顺序完全相同
sampler = DistributedSampler ( dataset , num_replicas = 2 , rank = 0 , shuffle = True , seed = 0 )
for epoch in range ( 3 ):
print ( " 不调用set_epoch " , list ( sampler ))
# 调用set_epoch:每一轮重新打乱,两个进程取到的下标互不重复
samplers = [ DistributedSampler ( dataset , num_replicas = 2 , rank = rank , shuffle = True , seed = 0 ) for rank in range ( 2 )]
for epoch in range ( 3 ):
for sampler in samplers :
sampler . set_epoch ( epoch )
print ( f " epoch { epoch } " , [ list ( sampler ) for sampler in samplers ])
# 样本数不能被进程数整除时,默认从头重复取几个样本补齐
print ( " 补齐 " , [ list ( DistributedSampler ( dataset , num_replicas = 4 , rank = rank , shuffle = False )) for rank in range ( 4 )])
# drop_last=True改为丢掉末尾的样本
print ( " 丢弃 " , [ list ( DistributedSampler ( dataset , num_replicas = 4 , rank = rank , shuffle = False , drop_last = True )) for rank in range ( 4 )])
1
2
3
4
5
6
7
8
不调用set_epoch [4, 7, 3, 0, 6]
不调用set_epoch [4, 7, 3, 0, 6]
不调用set_epoch [4, 7, 3, 0, 6]
epoch 0 [[4, 7, 3, 0, 6], [1, 5, 9, 8, 2]]
epoch 1 [[5, 1, 0, 9, 7], [6, 2, 8, 3, 4]]
epoch 2 [[8, 1, 6, 0, 2], [7, 5, 9, 4, 3]]
补齐 [[0, 4, 8], [1, 5, 9], [2, 6, 0], [3, 7, 1]]
丢弃 [[0, 4], [1, 5], [2, 6], [3, 7]]
每个进程上的打乱结果必须一致,否则各进程取到的样本会重叠或遗漏,所以种子由seed参数和轮数决定,而不是使用各进程自己的随机状态 样本数不能被进程数整除时,默认从头部重复取几个样本补齐,使每个进程的样本数相同。drop_last=True则丢掉末尾多出的样本。训练时影响不大,验证时会使结果略有偏差,见下文 等效批大小与学习率 等效批大小 = 每个进程的批大小 × 进程数。从单卡换到 4 张显卡时,如果每个进程的批大小不变,等效批大小就变为 4 倍,每一轮的更新步数变为四分之一。原来调好的学习率不一定还合适
做法 等效批大小 每轮步数 学习率 每个进程的批大小不变 变大 变少 通常按进程数等比放大,配合预热 每个进程的批大小除以进程数 不变 不变 不用改,结果与单卡接近
上面右图是实际的对比:2 个进程、学习率 0.1 时,前两轮的损失明显比单进程批大小 32 下降得慢;学习率加倍到 0.2 后,前两轮下降快了一些,但仍追不上单进程,5 轮之后三者的损失都在 0.1 左右。学习率按进程数等比放大是常用的经验做法,等效批大小很大时还需要在开始的几百步内逐渐升高学习率(预热),否则训练初期容易不稳定,学习率的调度见PyTorch Training
只在 rank 0 上打印和保存 所有进程运行同样的代码,不加判断时每条日志会打印多次,多个进程同时写同一个文件还可能把文件写坏。打印、验证、保存都放在if rank == 0:之下
包装后模型的参数名都多了module.前缀,因为DistributedDataParallel把原来的模型保存为自己的module属性。保存时应该保存model.module.state_dict(),这样的检查点可以直接加载到没有包装的模型中
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel
from train import Net
dist . init_process_group ( backend = " gloo " )
model = DistributedDataParallel ( Net ())
if dist . get_rank () == 0 :
print ( list ( model . state_dict ())[: 2 ]) # 包装后的参数名多了module.前缀
print ( list ( model . module . state_dict ())[: 2 ]) # model.module是原始的模型
# 错误:保存包装后的state_dict,之后无法直接加载到没有包装的模型中
torch . save ( model . state_dict (), " wrapped.pt " )
try :
Net (). load_state_dict ( torch . load ( " wrapped.pt " ))
except RuntimeError as error :
print ( " \n " . join ( line . strip ()[: 100 ] for line in str ( error ). splitlines ()))
# 正确:保存model.module的state_dict
torch . save ( model . module . state_dict (), " plain.pt " )
print ( Net (). load_state_dict ( torch . load ( " plain.pt " )))
# 已有的带前缀的检查点:去掉前缀后再加载
state = { name . removeprefix ( " module. " ): value for name , value in torch . load ( " wrapped.pt " ). items () }
print ( Net (). load_state_dict ( state ))
dist . destroy_process_group ()
1
2
3
4
5
6
7
['module.conv1.weight', 'module.conv1.bias']
['conv1.weight', 'conv1.bias']
Error(s) in loading state_dict for Net:
Missing key(s) in state_dict: "conv1.weight", "conv1.bias", "conv2.weight", "conv2.bias", "fc.weight
Unexpected key(s) in state_dict: "module.conv1.weight", "module.conv1.bias", "module.conv2.weight",
<All keys matched successfully>
<All keys matched successfully>
已有的带前缀的检查点,去掉前缀再加载即可,部分加载的更多情形见PyTorch Fine-Tuning 。从检查点恢复训练时,先把参数加载到原来的模型中,再用DistributedDataParallel包装;加载时传入map_location,否则每个进程都会把张量加载到保存时所在的显卡上
随机种子 两种随机性的要求相反:模型的初始化要在各进程上相同,而数据增强、Dropout的随机数各进程应该不同,否则各进程对不同样本做的却是同样的随机变换
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import torch
import torch.distributed as dist
from torch.nn.parallel import DistributedDataParallel
from train import Net
dist . init_process_group ( backend = " gloo " )
rank = dist . get_rank ()
# 所有进程使用相同的种子:之后每个进程生成的随机数完全相同
torch . manual_seed ( 0 )
same = torch . rand ( 3 )
# 每个进程使用不同的种子
torch . manual_seed ( 0 + rank )
different = torch . rand ( 3 )
# 种子不同,各进程初始化出的模型也不同;DistributedDataParallel在包装时会把rank 0的参数复制给其他进程
model = Net ()
before = model . fc . weight . sum (). item ()
model = DistributedDataParallel ( model )
after = model . module . fc . weight . sum (). item ()
print ( f " rank { rank } : 相同种子 { [ round ( v , 4 ) for v in same . tolist ()] } \n "
f " rank { rank } : 不同种子 { [ round ( v , 4 ) for v in different . tolist ()] } \n "
f " rank { rank } : 包装前 { before : . 6 f } ,包装后 { after : . 6 f } " )
dist . destroy_process_group ()
1
2
3
4
5
6
rank 0: 相同种子 [0.4963, 0.7682, 0.0885]
rank 0: 不同种子 [0.4963, 0.7682, 0.0885]
rank 0: 包装前 1.439105,包装后 1.439105
rank 1: 相同种子 [0.4963, 0.7682, 0.0885]
rank 1: 不同种子 [0.7576, 0.2793, 0.4031]
rank 1: 包装前 3.491233,包装后 1.439105
种子不同时,两个进程初始化出的模型不同(fc.weight之和 1.439105 和 3.491233),包装之后 rank 1 的参数变成了 rank 0 的。DistributedDataParallel在包装时会把 rank 0 的参数和缓冲区复制给所有进程,所以初始参数总是一致的 因此可以放心地用base_seed + rank作为各进程的种子,数据增强的随机数各不相同,模型初始化也不会出问题 DataLoader的工作进程的种子由主进程的随机状态生成,主进程的种子按 rank 不同,工作进程的种子也就不同BatchNorm 的统计量 普通的 BatchNorm 只用本进程的那一部分批次计算均值和方差,每个进程的running_mean也各不相同,训练结束后保存的是 rank 0 上的统计量。每个进程的批很小时(例如检测、分割任务每张显卡只有 2 张图),统计量很不稳定,可以用SyncBatchNorm在所有进程之间统计,BatchNorm 本身的行为见归一化与正则化
SyncBatchNorm只能在显卡上运行,在 CPU 上会报错SyncBatchNorm layers only work with GPU modules。这个例子在一台只有一张显卡的机器上(Intel Core Ultra 9 285K,GeForce RTX 5090 D(32 GB 显存),64 GB 内存)运行,两个进程共用这张显卡。nccl不允许多个进程使用同一张显卡,所以这里使用gloo后端,只用于演示
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
import torch
import torch.distributed as dist
import torch.nn as nn
from torch.nn.parallel import DistributedDataParallel
dist . init_process_group ( backend = " gloo " )
rank = dist . get_rank ()
device = torch . device ( " cuda:0 " ) # 只有一张显卡,两个进程共用它,仅用于演示
def run ( sync ):
torch . manual_seed ( 0 )
model = nn . Sequential ( nn . Conv2d ( 1 , 4 , 3 ), nn . BatchNorm2d ( 4 ), nn . ReLU (), nn . Flatten (), nn . Linear ( 4 * 6 * 6 , 10 ))
if sync :
model = nn . SyncBatchNorm . convert_sync_batchnorm ( model ) # 在包装之前转换
model = DistributedDataParallel ( model . to ( device ), device_ids = [ 0 ])
torch . manual_seed ( rank ) # 两个进程的数据不同:rank 1的数据整体偏大
images = torch . randn ( 8 , 1 , 8 , 8 , device = device ) + rank
model ( images ). sum (). backward ()
bn = model . module [ 1 ]
print ( f " rank { rank } : { type ( bn ). __name__ } running_mean { [ round ( v , 4 ) for v in bn . running_mean . tolist ()] } " )
run ( sync = False )
dist . barrier () # 等待所有进程都执行到这里
run ( sync = True )
dist . destroy_process_group ()
1
torchrun --nproc_per_node = 2 bn.py
1
2
3
4
rank 0: BatchNorm2d running_mean [-0.0183, 0.032, 0.0131, 0.0222]
rank 1: BatchNorm2d running_mean [-0.0338, -0.0103, 0.0624, -0.1154]
rank 0: SyncBatchNorm running_mean [-0.026, 0.0109, 0.0377, -0.0466]
rank 1: SyncBatchNorm running_mean [-0.026, 0.0109, 0.0377, -0.0466]
普通的BatchNorm2d:rank 1 的数据整体偏大 1,两个进程的running_mean不同 SyncBatchNorm:两个进程的统计量完全相同,是两个进程合在一起的 16 个样本的统计结果convert_sync_batchnorm要在用DistributedDataParallel包装之前调用。每一次前向传播都多了一次通信,每个进程的批足够大时没有必要使用汇总验证指标 把验证集分给所有进程后,每个进程只能算出自己那一部分的指标。正确的做法是汇总计数(正确的样本数、总样本数,或者混淆矩阵),用dist.all_reduce在进程之间求和,最后再算出指标;而不是让每个进程先算出准确率,再把几个准确率取平均。下面用 4 个进程评估上面训练好的模型,验证集有 357 个样本
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
import torch
import torch.distributed as dist
from torch.utils.data import DataLoader , DistributedSampler , Subset
from train import Net , load_data
dist . init_process_group ( backend = " gloo " )
rank , world_size = dist . get_rank (), dist . get_world_size ()
_ , val_set = load_data ()
model = Net ()
model . load_state_dict ( torch . load ( " model.pt " )) # 上面的训练脚本保存的模型
model . eval ()
@torch.no_grad ()
def count ( loader ):
""" 返回本进程上的 [预测正确的样本数, 样本数] """
result = torch . zeros ( 2 , dtype = torch . long )
for images , labels in loader :
result [ 0 ] += ( model ( images ). argmax ( dim = 1 ) == labels ). sum ()
result [ 1 ] += len ( labels )
return result
def report ( name , local ):
each = [ torch . zeros_like ( local ) for _ in range ( world_size )]
dist . all_gather ( each , local ) # 仅用于打印每个进程的结果
total = local . clone ()
dist . all_reduce ( total , op = dist . ReduceOp . SUM ) # 所有进程的计数相加
if rank == 0 :
accuracies = [( c / n ). item () for c , n in each ]
print ( f " { name } \n 各进程的 [正确数, 样本数] { [ e . tolist () for e in each ] } \n "
f " 各进程的准确率 { [ round ( a , 4 ) for a in accuracies ] } ,取平均 { sum ( accuracies ) / world_size : . 6 f } \n "
f " 计数相加后 { total [ 0 ]. item () } / { total [ 1 ]. item () } = { ( total [ 0 ] / total [ 1 ]). item () : . 6 f } " )
# 方式一:DistributedSampler,样本数不能被进程数整除时会重复几个样本
sampler = DistributedSampler ( val_set , shuffle = False )
report ( " DistributedSampler " , count ( DataLoader ( val_set , batch_size = 256 , sampler = sampler )))
# 方式二:按下标每隔world_size个取一个,不补齐,每个样本恰好被评估一次
subset = Subset ( val_set , range ( rank , len ( val_set ), world_size ))
report ( " 按下标切分 " , count ( DataLoader ( subset , batch_size = 256 )))
# 参照:一个进程评估整个验证集
if rank == 0 :
correct , total = count ( DataLoader ( val_set , batch_size = 256 )). tolist ()
print ( f " 单个进程评估整个验证集 \n { correct } / { total } = { correct / total : . 6 f } " )
dist . destroy_process_group ()
1
2
3
4
5
6
7
8
9
10
DistributedSampler
    各进程的 [正确数, 样本数] [[86, 90], [89, 90], [88, 90], [88, 90]]
    各进程的准确率 [0.9556, 0.9889, 0.9778, 0.9778],取平均 0.975000
    计数相加后 351 / 360 = 0.975000
按下标切分
    各进程的 [正确数, 样本数] [[86, 90], [88, 89], [87, 89], [87, 89]]
    各进程的准确率 [0.9556, 0.9888, 0.9775, 0.9775],取平均 0.974844
    计数相加后 348 / 357 = 0.974790
单个进程评估整个验证集
    348 / 357 = 0.974790
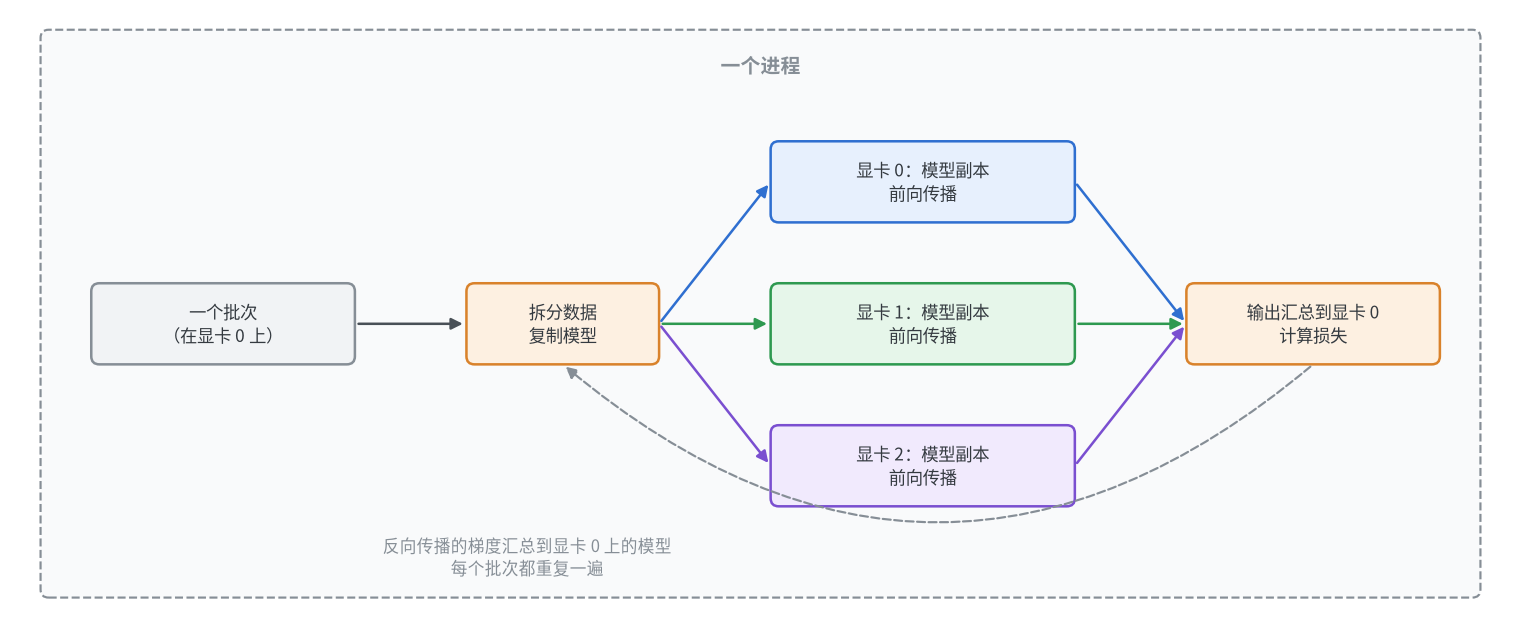
用DistributedSampler切分时,357 个样本被补齐到 360 个,有 3 个样本被评估了两次,得到 351 / 360 = 0.975,与真实的 0.974790 不同 按下标每隔 4 个取一个、不补齐时,计数相加的结果与单进程完全一致 各进程的样本数不同时,把准确率取平均(0.974844)是错的,各进程的样本数相同时两种算法才一致。精确率、F1 这类指标的分母随预测结果变化,取平均的误差更大,按计数累积指标的方法见评估指标 不补齐时各进程的批次数可能不同。在验证中只做前向传播没有问题,但如果某个进程多做了一次需要同步的操作,其他进程不会参与,程序就会一直等下去 nn.DataParallel nn.DataParallel只需要一行代码,不需要torchrun,也不需要改训练循环:在一个进程中,每个批次把数据拆到各张显卡上,把模型复制到各张显卡上分别前向传播,再把输出汇总到第一张显卡上计算损失和反向传播
1
2
3
4
5
6
7
8
9
10
11
import torch
import torch.nn as nn
from train import Net
model = nn . DataParallel ( Net (). cuda ()) # 默认使用所有可见的显卡,模型需要先放到第一张显卡上
print ( torch . cuda . device_count (), model . device_ids ) # 1 [0]
print ( list ( model . state_dict ())[: 2 ]) # ['module.conv1.weight', 'module.conv1.bias']
images = torch . randn ( 64 , 1 , 8 , 8 ). cuda () # 整个批次放在第一张显卡上,前向传播时再拆分到各张显卡
print ( model ( images ). shape ) # torch.Size([64, 10])
上面的例子在只有一张显卡的机器上运行,DataParallel只用了这一张显卡,什么也没有加速,只是验证了它的用法和参数名同样带有module.前缀。下面几点是它的已知缺点,本文没有多张显卡,无法实测
只有一个进程,多个线程驱动多张显卡,受 Python 全局解释器锁的限制 每一步都要把模型复制到各张显卡上,输出和梯度都汇总到第一张显卡,第一张显卡的显存占用和负载明显高于其他显卡 只能在一台机器上使用 PyTorch 官方文档推荐使用DistributedDataParallel,即使只有一台机器也是如此
启动与排错 torchrun 的常用参数 参数 作用 --nproc_per_node每台机器启动的进程数,通常等于显卡数,gpu表示使用所有可见的显卡 --nnodes机器数,默认 1 --node_rank本机的编号,多机时每台机器分别指定 --master_addrrank 0 所在机器的地址,多机时需要指定 --master_portrank 0 监听的端口,同一台机器上同时运行两个任务时要错开 --standalone单机时自动选择空闲端口,不需要再指定地址和端口
1
2
3
4
5
6
# 单机,只使用第 2、3 张显卡;进程内看到的编号是 0 和 1
CUDA_VISIBLE_DEVICES = 2,3 torchrun --standalone --nproc_per_node = 2 train.py
# 两台机器各 4 张显卡:两台机器上分别运行,只有 --node_rank 不同
torchrun --nnodes = 2 --node_rank = 0 --nproc_per_node = 4 --master_addr = 192.168.1.10 --master_port = 29500 train.py
torchrun --nnodes = 2 --node_rank = 1 --nproc_per_node = 4 --master_addr = 192.168.1.10 --master_port = 29500 train.py
用CUDA_VISIBLE_DEVICES选择显卡,进程内的编号总是从 0 开始,所以代码中用LOCAL_RANK选择显卡,而不是写死某个编号 进程数大于 1 而又没有设置OMP_NUM_THREADS时,torchrun会提示已把每个进程的OMP_NUM_THREADS设为 1。在 CPU 上做数据预处理较多时,按 CPU 核数除以进程数设置这个变量 多机启动的两条命令只按文档写出,本文没有在多台机器上运行过 常见的错误 现象 原因 environment variable RANK expected, but not set用python train.py直接运行,没有经过torchrun EADDRINUSE、address already in use端口被占用,通常是另一个任务或上一次没有退出的进程,换一个--master_port 启动后长时间没有输出,最后Timed out ... waiting for clients 实际启动的进程数少于WORLD_SIZE,rank 0 一直在等其他进程 Multiple Ranks are using the same GPU进程数多于显卡数,几个进程用上了同一张显卡 训练中途卡住不动 各进程执行的同步操作不一致,例如某个进程多跑了一个批次,或只有 rank 0 调用了all_reduce
上表前四行都实际复现过。等待其他进程的默认超时时间很长,看起来就像程序卡死了,排查时可以把init_process_group的timeout调小
另外,测试本文的例子时,偶尔有一个进程在所有输出都已完成、调用destroy_process_group之后,退出时收到SIGABRT,torchrun随即结束另一个进程并报告失败。之后把同样的脚本重复运行了几十次都没有再出现,原因没有查明。遇到这种情况时先看输出和保存的文件是否完整,再决定是否需要重新运行
1
2
3
4
5
6
7
8
from datetime import timedelta
import torch.distributed as dist
# 默认的超时时间很长,这里缩短到10秒
dist . init_process_group ( backend = " gloo " , timeout = timedelta ( seconds = 10 ))
print ( " 初始化完成 " )
dist . destroy_process_group ()
1
2
# 声称有 2 个进程,实际只启动了 rank 0
RANK = 0 LOCAL_RANK = 0 WORLD_SIZE = 2 MASTER_ADDR = 127.0.0.1 MASTER_PORT = 29600 python hang.py
1
torch.distributed.DistStoreError: Timed out after 11 seconds waiting for clients. 1/2 clients joined.
在只有一张显卡的机器上用torchrun --nproc_per_node=2启动train.py,两个进程都使用nccl,得到的错误如下
1
2
RuntimeError: Failed to initialize NCCL communicator: invalid usage (run with NCCL_DEBUG=WARN for details)
NCCL Last Error: Multiple Ranks are using the same GPU/Partition. Set NCCL_MULTI_RANK_GPU_ENABLE=1 to enable this configuration.
清理残留的进程 训练出错或被中断后,可能留下仍在运行的进程,占着端口和显存。先列出自己的进程,确认无误后按进程号结束
1
2
3
4
pgrep -u $USER -af train.py   # 列出自己的、命令行中含有train.py的进程,第一列是进程号
kill 12345                    # 结束torchrun的那个进程,它会先结束自己启动的所有训练进程
kill -9 12346                 # 某个进程不响应时才强制结束
nvidia-smi                    # 确认显存已经释放
在共享的机器上不要用pkill -f train.py这类按名字结束进程的命令,它会把别人同名的任务一起结束 pgrep -f匹配的是完整的命令行,用ssh或bash -c执行的命令中如果含有同样的文字,这个外层的 shell 也会被匹配到,结束之前要看清楚每一行是什么用kill(默认的SIGTERM)结束torchrun进程时,它会先结束自己启动的训练进程,这一点在本文中实际验证过;直接结束某一个训练进程,torchrun会结束其余的进程并报错退出 加速比 本文只有一张显卡,没有测量过多张显卡带来的加速 。一般来说,DDP 的加速在理想情况下接近线性,即 N 张显卡接近 N 倍,实际会低一些:每一步都要同步梯度,模型参数越多、显卡之间的连接越慢,通信占的时间越多;数据加载跟不上时,增加显卡也不会更快;每个进程的批太小时,显卡本身就没有被用满。增加显卡之前,先确认单卡训练时显卡的利用率已经很高
← 上一篇:Experiment Tracking 下一篇:PyTorch Fine-Tuning →