Evaluation Metrics
整理深度学习模型常用评估指标的含义、容易产生误导的情况与计算方法,包括混淆矩阵、精确率与召回率、ROC 与 PR 曲线、回归、分割与语言模型的指标,以及指标的正确累积方式
深度学习系列:第 12 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
损失函数是给优化器用的,评估指标是给人看的:训练时最小化损失,但判断模型好不好、要不要保存、能不能上线,看的是验证集上的指标。指标选得不对,或者算得不对,模型之间的比较就没有意义。训练与验证循环的写法见PyTorch Training
下面每个指标都先手动实现一遍,再与scikit-learn和torchmetrics的结果对照
1
pip install scikit-learn torchmetrics
两个库的参数顺序相反。 scikit-learn的函数是(真实值, 预测值),torchmetrics的指标是(预测值, 真实值)。准确率、F1 这类对称的指标写反了结果不变,而混淆矩阵、精确率、召回率、R² 写反了不会报错,只是结果是错的
混淆矩阵
分类任务的大多数指标都可以由混淆矩阵算出来。混淆矩阵统计的是每一种“真实类别 - 预测类别”的组合各出现了多少次
二分类
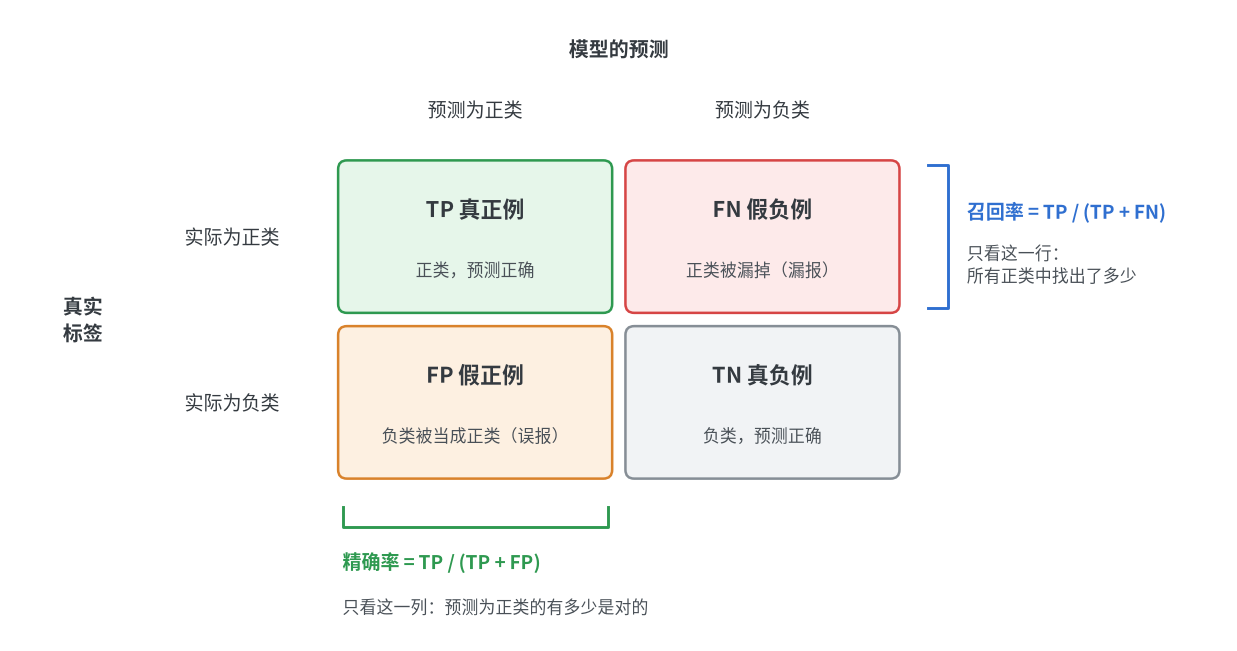
二分类中把关心的那一类称为正类(例如有缺陷、患病、是垃圾邮件),另一类称为负类。预测结果有四种情况
| 缩写 | 真实 | 预测 | 含义 |
|---|---|---|---|
| TP | 正类 | 正类 | 正确找出的正类 |
| FP | 负类 | 正类 | 误报,把负类当成了正类 |
| FN | 正类 | 负类 | 漏报,没有找出的正类 |
| TN | 负类 | 负类 | 正确排除的负类 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import torch
from sklearn.metrics import confusion_matrix
from torchmetrics.classification import BinaryConfusionMatrix

target = torch.tensor([1, 1, 1, 1, 0, 0, 0, 0, 0, 0])  # 真实标签,1为正类
pred = torch.tensor([1, 1, 1, 0, 1, 1, 0, 0, 0, 0])    # 模型的预测

tp = ((pred == 1) & (target == 1)).sum().item()
fp = ((pred == 1) & (target == 0)).sum().item()
fn = ((pred == 0) & (target == 1)).sum().item()
tn = ((pred == 0) & (target == 0)).sum().item()
print(tp, fp, fn, tn)  # 3 2 1 4

print(confusion_matrix(target, pred))
# [[4 2]
#  [1 3]]
print(confusion_matrix(target, pred).ravel())  # [4 2 1 3],顺序为TN、FP、FN、TP

print(BinaryConfusionMatrix()(pred, target))
# tensor([[4, 2],
#         [1, 3]])

# 两个参数的顺序写反时不会报错,得到的是转置后的矩阵,FP和FN互换
print(confusion_matrix(pred, target))
# [[4 1]
#  [2 3]]
scikit-learn和torchmetrics的混淆矩阵都是行为真实类别、列为预测类别,并且类别按编号从小到大排列,所以负类在前:左上角是 TN 而不是 TP,与上图以及很多教材中的画法相反。读取四个数时用ravel()按 TN、FP、FN、TP 的顺序取出,不要凭印象按位置去取
多分类
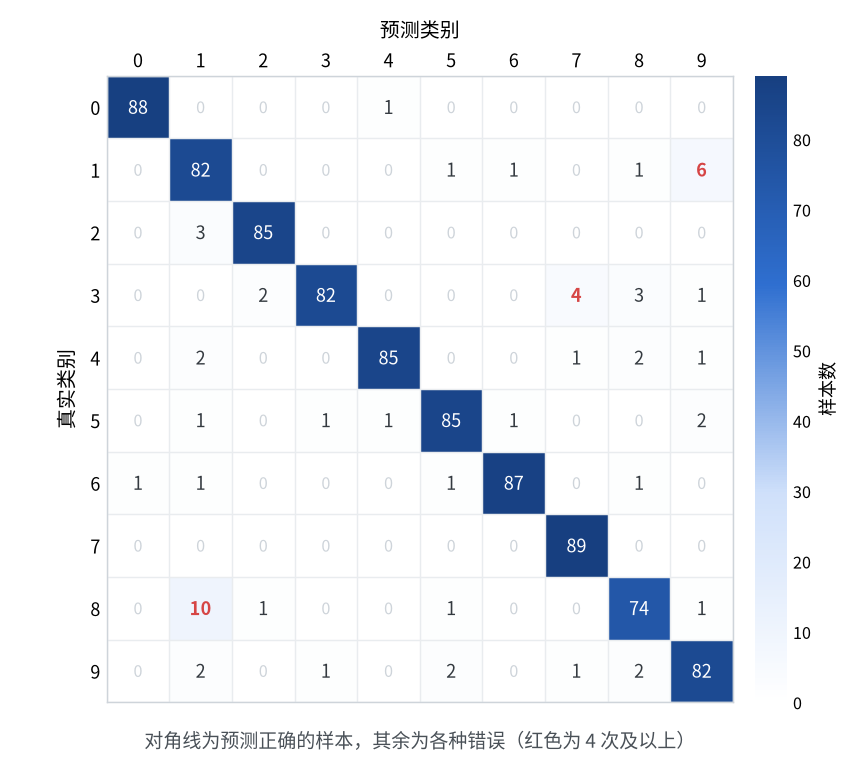
多分类的混淆矩阵是$K \times K$的,第$i$行第$j$列是真实为类别$i$、被预测为类别$j$的样本数。下面在load_digits手写数字数据集上训练一个很小的全连接网络,统计它在测试集上的混淆矩阵
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
import torch
from sklearn.datasets import load_digits
from sklearn.metrics import confusion_matrix
from sklearn.model_selection import train_test_split
from torch import nn
from torchmetrics.classification import MulticlassConfusionMatrix

torch.manual_seed(0)
images, labels = load_digits(return_X_y=True)  # 1797张8x8的手写数字,像素值为0到16
x_train, x_test, y_train, y_test = train_test_split(
    images / 16, labels, test_size=0.5, random_state=0, stratify=labels)
x_train, x_test = torch.tensor(x_train, dtype=torch.float32), torch.tensor(x_test, dtype=torch.float32)
y_train, y_test = torch.tensor(y_train), torch.tensor(y_test)

model = nn.Sequential(nn.Linear(64, 32), nn.ReLU(), nn.Linear(32, 10))
optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
for _ in range(40):
    loss = nn.functional.cross_entropy(model(x_train), y_train)
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

model.eval()
with torch.no_grad():
    pred = model(x_test).argmax(dim=1)


def confusion(pred, target, num_classes):
    """行为真实类别,列为预测类别"""
    index = target * num_classes + pred  # 把(真实, 预测)这一对编号为一个整数
    return torch.bincount(index, minlength=num_classes ** 2).reshape(num_classes, num_classes)


matrix = confusion(pred, y_test, 10)
print(matrix)
print(torch.equal(matrix, torch.tensor(confusion_matrix(y_test, pred))))             # True
print(torch.equal(matrix, MulticlassConfusionMatrix(num_classes=10)(pred, y_test)))  # True

print(matrix.diag().sum().item(), matrix.sum().item())  # 对角线之和为预测正确的个数
print(matrix.sum(dim=1))  # 每一行之和:各类别真实的样本数
print(matrix.sum(dim=0))  # 每一列之和:各类别被预测的次数

# 找出最容易混淆的三对类别
errors = matrix.clone()
errors.fill_diagonal_(0)
for index in errors.flatten().topk(3).indices:
    i, j = divmod(index.item(), 10)
    print(f"真实为{i}、预测为{j}:{errors[i, j].item()}次")
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
tensor([[88,  0,  0,  0,  1,  0,  0,  0,  0,  0],
        [ 0, 82,  0,  0,  0,  1,  1,  0,  1,  6],
        [ 0,  3, 85,  0,  0,  0,  0,  0,  0,  0],
        [ 0,  0,  2, 82,  0,  0,  0,  4,  3,  1],
        [ 0,  2,  0,  0, 85,  0,  0,  1,  2,  1],
        [ 0,  1,  0,  1,  1, 85,  1,  0,  0,  2],
        [ 1,  1,  0,  0,  0,  1, 87,  0,  1,  0],
        [ 0,  0,  0,  0,  0,  0,  0, 89,  0,  0],
        [ 0, 10,  1,  0,  0,  1,  0,  0, 74,  1],
        [ 0,  2,  0,  1,  0,  2,  0,  1,  2, 82]])
True
True
839 899
tensor([89, 91, 88, 92, 91, 91, 91, 89, 87, 90])
tensor([ 89, 101,  88,  84,  87,  90,  89,  95,  83,  93])
真实为8、预测为1:10次
真实为1、预测为9:6次
真实为3、预测为7:4次
读混淆矩阵时看三处
- 对角线:预测正确的样本。对角线之和除以总数就是准确率,这里是 839 / 899 = 93.3%
- 某一行:这个类别的样本被预测成了什么。第 8 行的 87 个样本中有 10 个被预测为 1,说明模型容易把 8 漏掉
- 某一列:被预测为这个类别的样本实际是什么。第 1 列共 101 个,只有 82 个真的是 1,说明模型预测为 1 时不太可靠
准确率只给出一个总数,混淆矩阵能看出错在哪里:这个模型的错误集中在 8 和 1、1 和 9 之间,改进时应当先看这几类的数据
准确率、精确率、召回率与 F1
四个指标都由混淆矩阵的四个数得到
\[\text{Accuracy} = \frac{TP + TN}{TP + FP + FN + TN}\] \[\text{Precision} = \frac{TP}{TP + FP} ,\qquad \text{Recall} = \frac{TP}{TP + FN}\] \[F_{1} = \frac{2 \cdot \text{Precision} \cdot \text{Recall}}{\text{Precision} + \text{Recall}} = \frac{2TP}{2TP + FP + FN}\]| 指标 | 回答的问题 | 关心的错误 |
|---|---|---|
| 准确率 Accuracy | 所有样本中预测对了多少 | 不区分错误类型 |
| 精确率 Precision | 预测为正类的样本中有多少是对的 | 误报 FP |
| 召回率 Recall | 所有正类中找出了多少 | 漏报 FN |
| F1 | 精确率和召回率的调和平均 | 两者兼顾 |
调和平均偏向较小的那个值:精确率 1.0、召回率 0.1 时,算术平均是 0.55,F1 只有 0.18。只有两者都高,F1 才会高
类别不平衡时,准确率会产生误导。 1000 个样本中只有 10 个正类时,一个什么都不做、全部预测为负类的模型,准确率也有 99%
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import torch
from sklearn.metrics import accuracy_score, f1_score, precision_score, recall_score
from torchmetrics.classification import BinaryAccuracy, BinaryF1Score, BinaryPrecision, BinaryRecall


def binary_metrics(pred, target):
    tp = ((pred == 1) & (target == 1)).sum().item()
    fp = ((pred == 1) & (target == 0)).sum().item()
    fn = ((pred == 0) & (target == 1)).sum().item()
    tn = ((pred == 0) & (target == 0)).sum().item()
    accuracy = (tp + tn) / (tp + fp + fn + tn)
    precision = tp / (tp + fp) if tp + fp > 0 else 0.0  # 没有预测出任何正类时分母为0
    recall = tp / (tp + fn) if tp + fn > 0 else 0.0
    f1 = 2 * tp / (2 * tp + fp + fn) if tp > 0 else 0.0
    return accuracy, precision, recall, f1


# 1000个样本中只有10个正类,例如从1000张产品图像中找出10张有缺陷的
target = torch.zeros(1000, dtype=torch.long)
target[:10] = 1

# 模型A:全部预测为负类
pred_a = torch.zeros(1000, dtype=torch.long)
print([round(v, 3) for v in binary_metrics(pred_a, target)])  # [0.99, 0.0, 0.0, 0.0]

# 模型B:找出了10个正类中的8个,同时把30个负类误报为正类
pred_b = torch.zeros(1000, dtype=torch.long)
pred_b[:8] = 1
pred_b[10:40] = 1
print([round(v, 3) for v in binary_metrics(pred_b, target)])  # [0.968, 0.211, 0.8, 0.333]

# 与scikit-learn的结果一致
print(round(accuracy_score(target, pred_b), 3), round(precision_score(target, pred_b), 3),
      round(recall_score(target, pred_b), 3), round(f1_score(target, pred_b), 3))  # 0.968 0.211 0.8 0.333

# 与torchmetrics的结果一致
for metric in (BinaryAccuracy(), BinaryPrecision(), BinaryRecall(), BinaryF1Score()):
    print(round(metric(pred_b, target).item(), 3), end=" ")  # 0.968 0.211 0.8 0.333
print()

# 模型A没有预测出任何正类,精确率的分母为0,scikit-learn会给出UndefinedMetricWarning
print(precision_score(target, pred_a, zero_division=0))  # 0.0,指定分母为0时的取值后不再警告
模型 A 一个正类都没有找到,准确率却比找出了 8 个正类的模型 B 还高。精确率、召回率和 F1 的公式中都没有 TN,不会被数量庞大的负类稀释,因此正类很少时应当看这三个指标,而不是准确率
精确率和召回率哪个更重要取决于两种错误的代价:漏掉一个缺陷产品或一个病人的代价很高时,优先保证召回率;误报会打扰用户或浪费人工复核时,优先保证精确率
多分类的平均方式
多分类时,把每个类别轮流当作正类、其余类别当作负类,可以得到每个类别各自的精确率、召回率和 F1。要把它们合成一个数,有三种平均方式
| 平均方式 | 计算方法 | 特点 |
|---|---|---|
macro | 先算每个类别的指标,再直接取平均 | 每个类别同等重要,小类别表现差会被体现 |
weighted | 先算每个类别的指标,再按各类别的样本数加权平均 | 结果由样本多的类别主导 |
micro | 先把所有类别的 TP、FP、FN 分别相加,再算一次指标 | 每个样本同等重要,结果由大类别主导 |
下面的例子有三个类别,样本数分别为 90、8、2,模型把样本最少的类别 2 全部预测错了
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
import torch
from sklearn.metrics import classification_report, f1_score
from torchmetrics import F1Score
from torchmetrics.classification import MulticlassAccuracy, MulticlassF1Score

# 三个类别的样本数分别为90、8、2,模型把类别2全部预测错
target = torch.tensor([0] * 90 + [1] * 8 + [2] * 2)
pred = torch.tensor([0] * 85 + [1] * 5 + [1] * 6 + [0] * 2 + [0] * 2)

num_classes = 3
index = target * num_classes + pred
matrix = torch.bincount(index, minlength=num_classes ** 2).reshape(num_classes, num_classes)
print(matrix)
# tensor([[85,  5,  0],
#         [ 2,  6,  0],
#         [ 2,  0,  0]])

tp = matrix.diag().float()
fp = matrix.sum(dim=0) - tp  # 这一列中除了对角线之外的:被误判为该类别的
fn = matrix.sum(dim=1) - tp  # 这一行中除了对角线之外的:该类别中被漏掉的
support = matrix.sum(dim=1)  # 每个类别真实的样本数

f1 = 2 * tp / (2 * tp + fp + fn).clamp(min=1)
print(f1)  # tensor([0.9497, 0.6316, 0.0000])

macro = f1.mean()
weighted = (f1 * support).sum() / support.sum()
micro = 2 * tp.sum() / (2 * tp.sum() + fp.sum() + fn.sum())
print(f"{macro.item():.4f} {weighted.item():.4f} {micro.item():.4f}")  # 0.5271 0.9053 0.9100
print(f"{(pred == target).float().mean().item():.4f}")                 # 0.9100,准确率与micro相同

# 与scikit-learn的结果一致
for average in ("macro", "weighted", "micro"):
    print(f"{f1_score(target, pred, average=average):.4f}", end=" ")  # 0.5271 0.9053 0.9100
print()
print(f1_score(target, pred, average=None))  # [0.94972067 0.63157895 0.        ]

# 与torchmetrics的结果一致
for average in ("macro", "weighted", "micro"):
    metric = MulticlassF1Score(num_classes=3, average=average)
    print(f"{metric(pred, target).item():.4f}", end=" ")  # 0.5271 0.9053 0.9100
print()

# 两种写法的默认平均方式不同
print(f"{MulticlassF1Score(num_classes=3)(pred, target).item():.4f}")           # 0.5271,默认macro
print(f"{F1Score(task='multiclass', num_classes=3)(pred, target).item():.4f}")  # 0.9100,默认micro

# MulticlassAccuracy默认也是macro,得到的是各类别召回率的平均,而不是通常所说的准确率
print(f"{MulticlassAccuracy(num_classes=3)(pred, target).item():.4f}")                   # 0.5648
print(f"{MulticlassAccuracy(num_classes=3, average='micro')(pred, target).item():.4f}")  # 0.9100

print(classification_report(target, pred, digits=4, zero_division=0))
1
2
3
4
5
6
7
8
9
              precision    recall  f1-score   support

           0     0.9551    0.9444    0.9497        90
           1     0.5455    0.7500    0.6316         8
           2     0.0000    0.0000    0.0000         2

    accuracy                         0.9100       100
   macro avg     0.5002    0.5648    0.5271       100
weighted avg     0.9032    0.9100    0.9053       100
- 同一组预测,
macro的 F1 是 0.53,weighted和micro都在 0.91 左右。类别 2 完全失败这件事,只有macro反映了出来 - 每个样本只属于一个类别时,一个样本预测错了,对真实类别是一次 FN,对预测类别是一次 FP,所以 FP 和 FN 的总数相等,
micro的精确率、召回率、F1 三者相同,并且都等于准确率。此时报告microF1 并没有比准确率多提供信息 - 类别均衡时三种平均方式的结果接近;类别不平衡并且小类别同样重要时用
macro,同时列出每个类别各自的指标
torchmetrics中不同写法的默认平均方式不同。 MulticlassF1Score、MulticlassAccuracy等类默认是macro,而F1Score(task='multiclass')、Accuracy(task='multiclass')这种写法默认是micro。尤其是MulticlassAccuracy,默认得到的是各类别召回率的平均(上例中为 0.5648),而不是通常所说的准确率(0.91)。使用时始终显式写出average
阈值、ROC 与 PR 曲线
阈值
二分类模型输出的是一个 0 到 1 之间的概率,大于等于阈值的预测为正类。阈值通常取 0.5,但这只是一个习惯,并不一定是最合适的值
下面生成一份正类约占 10% 的数据,训练一个逻辑回归模型,观察不同阈值下的指标
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import torch
from sklearn.datasets import make_classification
from sklearn.metrics import average_precision_score, roc_auc_score
from torch import nn
from torchmetrics.classification import BinaryAUROC, BinaryAveragePrecision

torch.manual_seed(0)
# 正类约占10%的二分类数据,前一半训练,后一半测试
features, labels = make_classification(n_samples=20000, n_features=20, n_informative=5,
                                       weights=[0.9], class_sep=0.8, random_state=0)
features = torch.tensor(features, dtype=torch.float32)
labels = torch.tensor(labels)
x_train, y_train, x_test, target = features[:10000], labels[:10000], features[10000:], labels[10000:]

model = nn.Linear(20, 1)
optimizer = torch.optim.Adam(model.parameters(), lr=0.05)
for _ in range(200):
    loss = nn.functional.binary_cross_entropy_with_logits(model(x_train).squeeze(1), y_train.float())
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

with torch.no_grad():
    score = model(x_test).squeeze(1).sigmoid()  # 每个样本为正类的概率

print(f"正类 {target.sum().item()} 个,负类 {(target == 0).sum().item()} 个")
for threshold in (0.1, 0.3, 0.5, 0.7, 0.9):
    pred = score >= threshold
    tp = (pred & (target == 1)).sum().item()
    fp = (pred & (target == 0)).sum().item()
    fn = (~pred & (target == 1)).sum().item()
    print(f"阈值 {threshold}: 预测为正类 {tp + fp:4d} 个,"
          f"精确率 {tp / (tp + fp):.3f},召回率 {tp / (tp + fn):.3f},F1 {2 * tp / (2 * tp + fp + fn):.3f}")
1
2
3
4
5
6
正类 1068 个,负类 8932 个
阈值 0.1: 预测为正类 2051 个,精确率 0.454,召回率 0.873,F1 0.598
阈值 0.3: 预测为正类 1053 个,精确率 0.748,召回率 0.738,F1 0.743
阈值 0.5: 预测为正类  759 个,精确率 0.883,召回率 0.627,F1 0.733
阈值 0.7: 预测为正类  532 个,精确率 0.942,召回率 0.469,F1 0.626
阈值 0.9: 预测为正类  258 个,精确率 0.977,召回率 0.236,F1 0.380
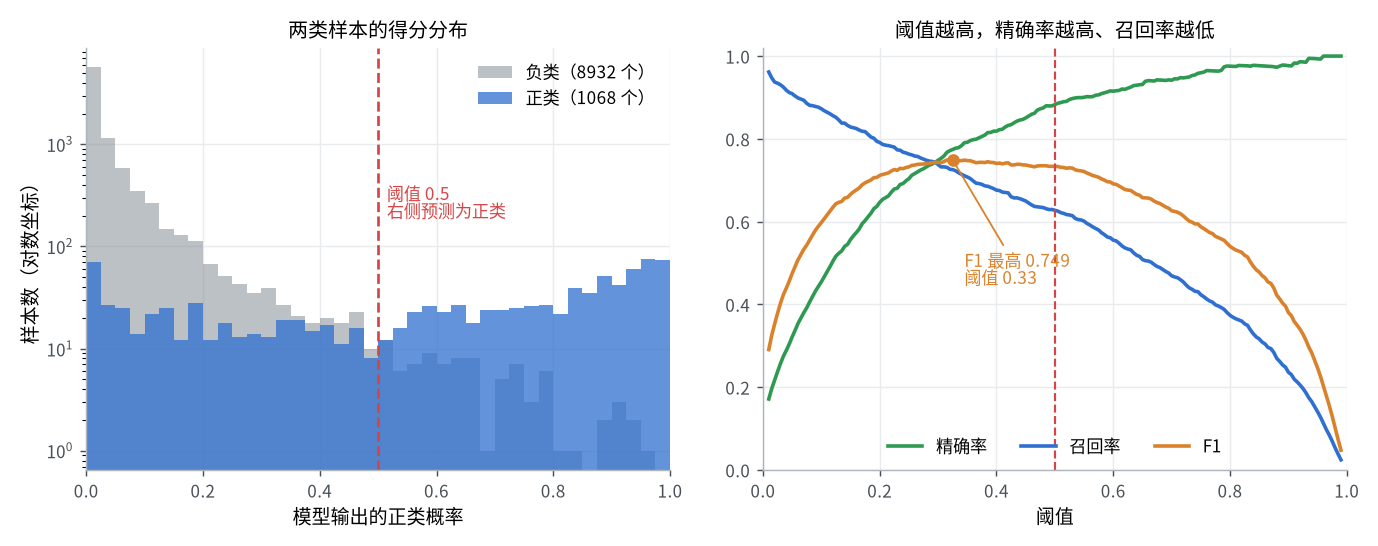
阈值越高,模型越“谨慎”,预测为正类的样本越少,精确率上升、召回率下降,两者此消彼长。模型本身没有变,变的只是在哪里切一刀
- 这个模型的 F1 在阈值 0.33 附近最高(0.749),而不是 0.5。正类较少时,最合适的阈值通常低于 0.5
- 阈值要在验证集上选,再到测试集上报告结果。在测试集上挑阈值相当于用测试集调参,得到的指标偏高
- 比较两个模型时,如果各自的阈值不同,精确率和召回率就没有可比性,这时需要不依赖阈值的指标
ROC 曲线与 PR 曲线
把阈值从高到低扫一遍,每个阈值得到一组指标,连起来就是一条曲线,曲线下的面积是一个不依赖阈值的指标
| 曲线 | 横轴 | 纵轴 | 面积 | 随机猜测时的面积 |
|---|---|---|---|---|
| ROC | 假正率 FPR | 真正率 TPR | AUC | 0.5 |
| PR | 召回率 Recall | 精确率 | AP(平均精确率) | 正类所占的比例 |
真正率就是召回率,假正率是所有负类中被误报的比例
\[\text{TPR} = \frac{TP}{TP + FN} ,\qquad \text{FPR} = \frac{FP}{FP + TN}\]AP 是各个阈值下精确率的加权和,权重是召回率的增量。下式中的$P$和$R$是精确率和召回率,下标$n$表示阈值降到第$n$个样本的得分时的取值
\[\text{AP} = \sum_{n} (R_{n} - R_{n-1}) \cdot P_{n}\]计算时不需要真的枚举阈值:把样本按得分从高到低排序,累加到第$n$个样本时的正类数和负类数,就是阈值取在该处时的 TP 和 FP。以下代码接在上一段之后
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
def curves(score, target):
    """把样本按得分从高到低排序,依次把阈值降到每个样本的得分处"""
    target = target[score.argsort(descending=True)]
    tp = target.cumsum(dim=0).double()        # 阈值降到第i个样本时的TP
    fp = (1 - target).cumsum(dim=0).double()  # 阈值降到第i个样本时的FP
    recall = tp / tp[-1]                      # 召回率,也就是真正率TPR
    fpr = fp / fp[-1]                         # 假正率FPR
    precision = tp / (tp + fp)
    return fpr, recall, precision


def roc_auc(score, target):
    fpr, tpr, _ = curves(score, target)
    zero = torch.zeros(1, dtype=torch.double)
    return torch.trapezoid(torch.cat([zero, tpr]), torch.cat([zero, fpr])).item()  # 曲线从(0, 0)开始


def average_precision(score, target):
    _, recall, precision = curves(score, target)
    previous = torch.cat([torch.zeros(1, dtype=torch.double), recall[:-1]])
    return ((recall - previous) * precision).sum().item()  # 召回率每增加一点,乘以此时的精确率


print(f"{roc_auc(score, target):.4f} {average_precision(score, target):.4f}")
print(f"{roc_auc_score(target, score):.4f} {average_precision_score(target, score):.4f}")
print(f"{BinaryAUROC()(score, target).item():.4f} {BinaryAveragePrecision()(score, target).item():.4f}")

# AUC的另一种含义:随机取一个正类和一个负类,正类得分更高的概率
positive, negative = score[target == 1], score[target == 0]
print(f"{(positive[:, None] > negative[None, :]).double().mean().item():.4f}")

# 保留全部负类,只留下一部分正类,模拟正类更稀少的情况
torch.manual_seed(0)
for keep in (len(positive), 300, 100, 30):
    chosen = positive[torch.randperm(len(positive))[:keep]]
    s = torch.cat([chosen, negative])
    t = torch.cat([torch.ones(keep, dtype=torch.long), torch.zeros(len(negative), dtype=torch.long)])
    print(f"正类占比 {keep / len(s):6.2%}: AUC {roc_auc(s, t):.3f},AP {average_precision(s, t):.3f},"
          f"阈值0.5时精确率 {((s >= 0.5) & (t == 1)).sum().item() / (s >= 0.5).sum().item():.3f}")
1
2
3
4
5
6
7
8
0.9326 0.8105
0.9326 0.8105
0.9326 0.8105
0.9326
正类占比 10.68%: AUC 0.933,AP 0.810,阈值0.5时精确率 0.883
正类占比  3.25%: AUC 0.932,AP 0.667,阈值0.5时精确率 0.675
正类占比  1.11%: AUC 0.943,AP 0.576,阈值0.5时精确率 0.422
正类占比  0.33%: AUC 0.953,AP 0.531,阈值0.5时精确率 0.191
- AUC 等于“随机取一个正类和一个负类,正类得分更高”的概率,衡量的是模型把正类排在负类前面的能力。它只与得分的排序有关,传入概率还是未经过
sigmoid的输出,结果相同 - 上面的手动实现假设没有两个样本的得分完全相同。得分有大量重复时(例如输出被量化过),相同得分的样本应当作为一个阈值一起处理,直接使用库函数更稳妥
scikit-learn另有一个通用的auc(x, y)函数,对 PR 曲线使用它得到的是梯形面积,与average_precision_score的结果略有不同,报告 AP 时用后者
类别不平衡时看 PR 曲线
上面输出的后四行是同一个模型、同一批负类,只是逐步减少正类的数量。AUC 几乎不变,始终在 0.93 以上;AP 从 0.81 降到 0.53,阈值 0.5 处的精确率从 0.88 降到 0.19
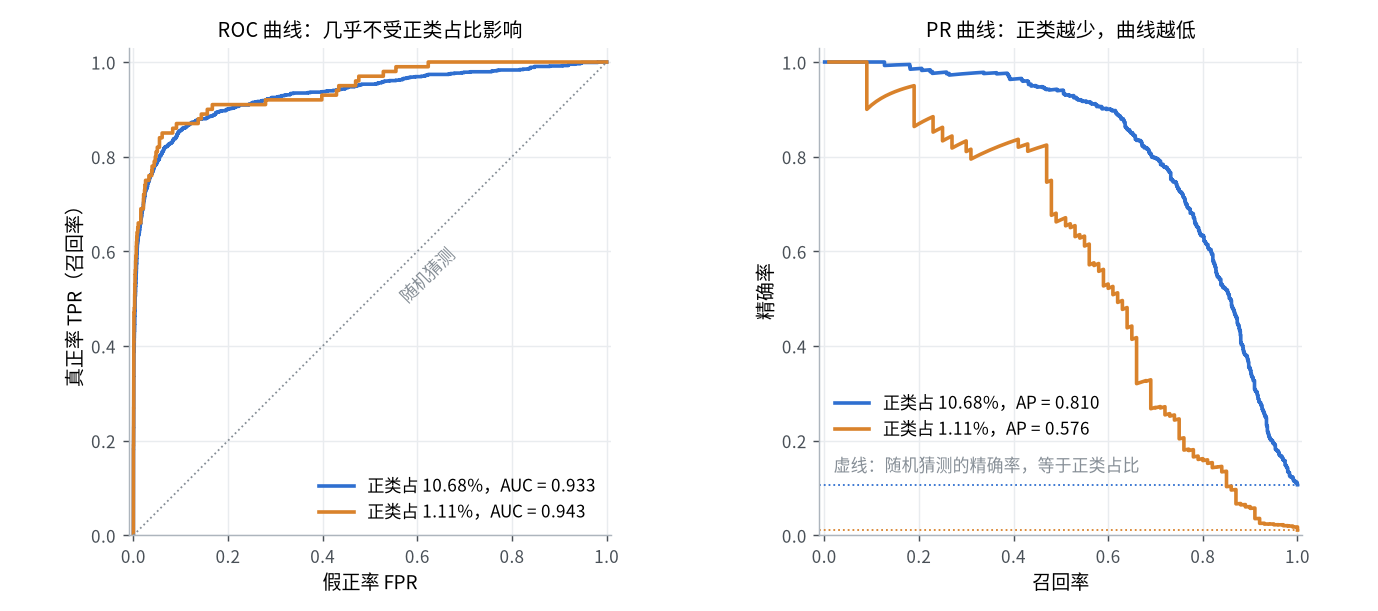
原因在于假正率的分母是负类总数。负类有 8932 个时,误报 100 个,假正率只有 1.1%,在 ROC 曲线上几乎看不出来;但如果正类总共只有 30 个,这 100 个误报就意味着模型报出的正类中绝大多数是错的。精确率把 FP 直接与 TP 比较,能反映出这一点
因此正类很少、并且关心的是“报出来的结果有多少可信”时(缺陷检测、欺诈识别、检索),用 PR 曲线和 AP;两类大致均衡,或者只关心排序能力时,用 ROC 曲线和 AUC。还要注意 AP 与正类占比有关,不同数据集上的 AP 不能直接比较
回归指标
下式中$y$为真实值,$\hat{y}$为预测值,$\bar{y}$为真实值的平均,$n$为样本数
\[\text{MAE} = \frac{1}{n} \sum_{i} \left| y_{i} - \hat{y}_{i} \right| ,\qquad \text{MSE} = \frac{1}{n} \sum_{i} (y_{i} - \hat{y}_{i})^{2} ,\qquad \text{RMSE} = \sqrt{\text{MSE}}\] \[R^{2} = 1 - \frac{\sum_{i} (y_{i} - \hat{y}_{i})^{2}}{\sum_{i} (y_{i} - \bar{y})^{2}}\]| 指标 | 单位 | 对离群值 | 说明 |
|---|---|---|---|
| MAE | 与目标相同 | 不敏感 | 平均偏差多少,最直观 |
| MSE | 目标单位的平方 | 很敏感 | 常用作损失函数,数值不直观 |
| RMSE | 与目标相同 | 敏感 | MSE 开方,可以与 MAE 直接比较 |
| R² | 没有单位 | 敏感 | 相对于“总是预测平均值”的改进程度,最大为 1 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
import torch
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score, root_mean_squared_error
from torchmetrics.regression import MeanAbsoluteError, MeanSquaredError, R2Score


def regression_metrics(pred, target):
    error = pred - target
    mae = error.abs().mean()
    mse = (error ** 2).mean()
    rmse = mse.sqrt()
    r2 = 1 - (error ** 2).sum() / ((target - target.mean()) ** 2).sum()
    return [round(v.item(), 3) for v in (mae, mse, rmse, r2)]


torch.manual_seed(0)
target = torch.rand(100) * 10             # 真实值在0到10之间
pred = target + torch.randn(100) * 0.5    # 预测值与真实值相差0.5左右
print(regression_metrics(pred, target))   # 依次为MAE、MSE、RMSE、R²

# 与scikit-learn的结果一致,参数顺序为(真实值, 预测值)
print(round(mean_absolute_error(target, pred), 3), round(mean_squared_error(target, pred), 3),
      round(root_mean_squared_error(target, pred), 3), round(r2_score(target, pred), 3))

# 与torchmetrics的结果一致,参数顺序为(预测值, 真实值)
print(round(MeanAbsoluteError()(pred, target).item(), 3), round(MeanSquaredError()(pred, target).item(), 3),
      round(MeanSquaredError(squared=False)(pred, target).item(), 3), round(R2Score()(pred, target).item(), 3))

# 100个预测中只有1个偏差很大
outlier = pred.clone()
outlier[0] = target[0] + 20
print(regression_metrics(outlier, target))

# 总是预测平均值时R²为0,比预测平均值还差时R²为负
print(regression_metrics(target.mean().expand(100), target)[3])
print(regression_metrics(10 - target, target)[3])

# R²的两个参数不能交换
print(round(r2_score(target, outlier), 3), round(r2_score(outlier, target), 3))
1
2
3
4
5
6
7
[0.368, 0.208, 0.456, 0.976]
0.368 0.208 0.456 0.976
0.368 0.208 0.456 0.976
[0.555, 4.191, 2.047, 0.512]
0.0
-3.006
0.512 0.656
- 100 个预测中只有 1 个偏了 20,MAE 变为原来的 1.5 倍,RMSE 变为 4.5 倍,MSE 变为 20 倍,R² 从 0.976 掉到 0.512。误差平方之后,大的误差占的比重被放大
- RMSE 明显大于 MAE 时,说明误差分布不均匀,存在少数偏差很大的样本,应当把它们找出来看一看
- 离群值来自标注错误或传感器故障时,用 MAE 评估更稳健;大的偏差确实更不可接受时(例如定位误差),用 RMSE
- R² 不是相关系数的平方,也不限于 0 到 1:总是预测平均值时为 0,比预测平均值还差时为负数
- MAE 和 RMSE 的数值与目标的单位和范围有关,不同任务之间不能比较;R² 没有单位,可以大致比较
分割与检测指标
IoU 与 Dice
语义分割的预测和标注都是掩码,评估的是两个区域的重叠程度。记预测的区域为$A$,真实的区域为$B$
\[\text{IoU} = \frac{|A \cap B|}{|A \cup B|} = \frac{TP}{TP + FP + FN} ,\qquad \text{Dice} = \frac{2|A \cap B|}{|A| + |B|} = \frac{2TP}{2TP + FP + FN}\]把每个像素看作一个样本,IoU(交并比,也叫 Jaccard 系数)和 Dice 都可以用 TP、FP、FN 表示,其中 Dice 就是像素级别的 F1。两者可以互相换算
\[\text{Dice} = \frac{2 \cdot \text{IoU}}{1 + \text{IoU}} ,\qquad \text{IoU} = \frac{\text{Dice}}{2 - \text{Dice}}\]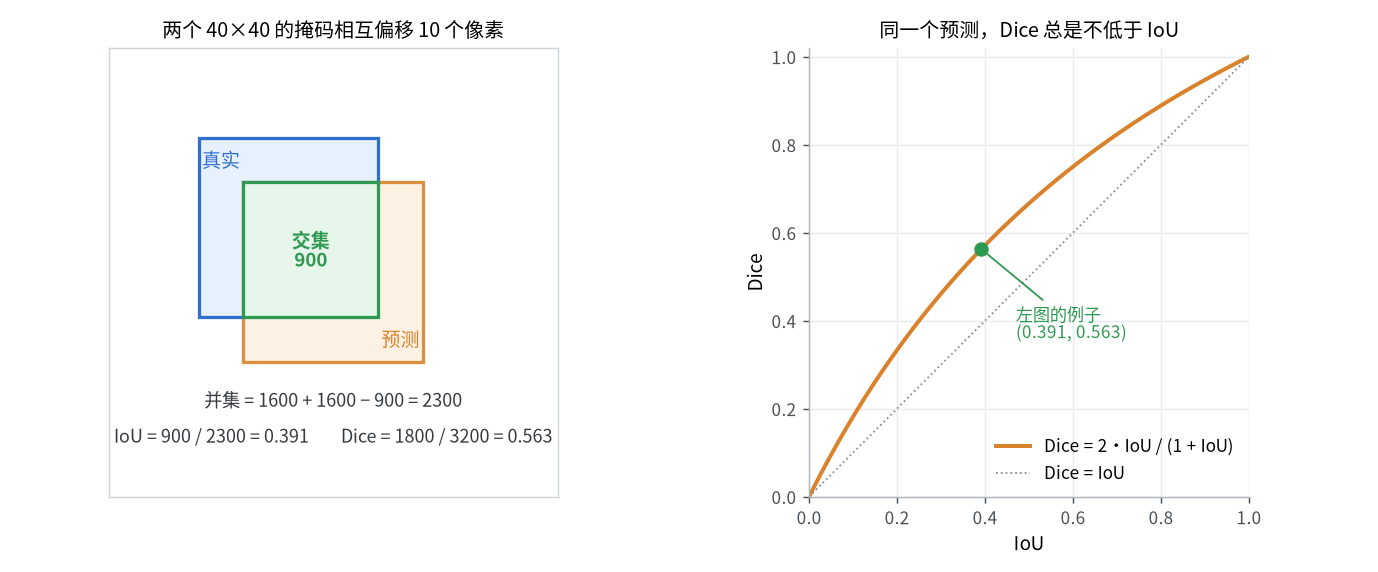
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import torch
from sklearn.metrics import f1_score, jaccard_score
from torchmetrics.classification import BinaryF1Score, BinaryJaccardIndex


def iou_dice(pred, target):
    intersection = (pred & target).sum().item()
    union = (pred | target).sum().item()
    return intersection / union, 2 * intersection / (pred.sum().item() + target.sum().item())


# 真实掩码是一个40x40的方块,预测的掩码向右下各偏移了10个像素
target = torch.zeros(100, 100, dtype=torch.bool)
target[20:60, 20:60] = True
pred = torch.zeros(100, 100, dtype=torch.bool)
pred[30:70, 30:70] = True

iou, dice = iou_dice(pred, target)
print(f"{iou:.4f} {dice:.4f}")                               # 0.3913 0.5625
print(f"{2 * iou / (1 + iou):.4f} {dice / (2 - dice):.4f}")  # 0.5625 0.3913,两者可以互相换算

# 把每个像素看作一个样本,IoU就是scikit-learn中的jaccard_score,Dice就是F1
flat_pred, flat_target = pred.flatten(), target.flatten()
print(f"{jaccard_score(flat_target, flat_pred):.4f} {f1_score(flat_target, flat_pred):.4f}")                # 0.3913 0.5625
print(f"{BinaryJaccardIndex()(pred, target).item():.4f} {BinaryF1Score()(pred, target).item():.4f}")  # 0.3913 0.5625

# 目标很小时,偏移同样的像素数,IoU下降得更多
small_target = torch.zeros(100, 100, dtype=torch.bool)
small_target[20:30, 20:30] = True
small_pred = torch.zeros(100, 100, dtype=torch.bool)
small_pred[25:35, 25:35] = True
print(f"{iou_dice(small_pred, small_target)[0]:.4f}")  # 0.1429,只偏移了5个像素
- 两者是单调的换算关系,按 IoU 排序和按 Dice 排序,模型的名次相同。但同一个预测的 Dice 总是不低于 IoU,读论文或比较结果时要先确认用的是哪一个
- 两个指标都不包含 TN,占图像大部分的背景不会把分数抬高。像素准确率则会:目标只占图像的 1% 时,全部预测为背景,像素准确率也有 99%
- 目标越小,IoU 对偏移越敏感:上例中 40 像素的方块偏移 10 像素,IoU 为 0.39;10 像素的方块只偏移 5 像素,IoU 就只有 0.14
平均 IoU
多类别的语义分割通常报告 mIoU:对每个类别分别计算 IoU,再对类别取平均。与多分类一样,先累积出像素级别的混淆矩阵,再从中计算
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
import torch
from sklearn.metrics import jaccard_score
from torchmetrics.classification import MulticlassJaccardIndex

torch.manual_seed(0)
num_classes = 5
# 2张64x64的图像,每个像素的值为类别编号,真实标签中只有类别0、1、2
# 类别3只在预测中出现,类别4在真实标签和预测中都没有出现
target = torch.randint(0, 3, (2, 64, 64))
pred = torch.where(torch.rand(2, 64, 64) < 0.7, target, torch.randint(0, 4, (2, 64, 64)))

index = target.flatten() * num_classes + pred.flatten()
matrix = torch.bincount(index, minlength=num_classes ** 2).reshape(num_classes, num_classes)

intersection = matrix.diag()
union = matrix.sum(dim=0) + matrix.sum(dim=1) - intersection  # 预测为该类 + 真实为该类 - 两者重叠
iou = intersection / union
print(iou)                         # tensor([0.6730, 0.6624, 0.6652, 0.0000,    nan])
print(f"{iou.nanmean().item():.4f}")  # 0.5002,跳过没有出现的类别

metric = MulticlassJaccardIndex(num_classes=5, average=None)
print(metric(pred, target))        # tensor([0.6730, 0.6624, 0.6652, 0.0000, 0.0000])
metric = MulticlassJaccardIndex(num_classes=5)
print(f"{metric(pred, target).item():.4f}")  # 0.5002,没有出现的类别不参与平均

labels = list(range(num_classes))
score = jaccard_score(target.flatten(), pred.flatten(), labels=labels, average="macro", zero_division=0)
print(f"{score:.4f}")              # 0.4001,没有出现的类别按0参与平均

# 只统计真实标签中出现过的类别
present = matrix.sum(dim=1) > 0
print(f"{iou[present].mean().item():.4f}")  # 0.6669
在真实标签和预测中都没有出现的类别,交集和并集都是 0,IoU 没有定义。 不同的库对它的处理不同,同一组预测可以得到不同的 mIoU
| 实现 | 没有出现的类别 | 上例的结果 |
|---|---|---|
手动实现,nanmean | 结果为nan,平均时跳过 | 0.5002 |
MulticlassJaccardIndex | 单独查看时为 0,平均时不计入 | 0.5002 |
jaccard_score(..., zero_division=0) | 按 0 计入平均 | 0.4001 |
另外,mIoU 应当在整个验证集上累积一个混淆矩阵之后再计算。先算每张图像的 mIoU 再取平均,会遇到大量“这张图像中没有这个类别”的情况,结果与标准的 mIoU 不同
mAP
目标检测的预测是带有置信度的框,评估时先用框与框之间的 IoU 判断一个预测是否命中了某个真实目标(例如 IoU 不低于 0.5 算命中),由此得到 TP 和 FP,再按置信度排序计算每个类别的 AP,最后对类别取平均得到 mAP。COCO 的 mAP 还会在 0.5 到 0.95 的多个 IoU 阈值上再取一次平均。其中的 AP 与上文二分类的 AP 是同一个概念,具体的匹配规则和计算过程见Object Detection
语言模型与生成指标
top-k 准确率
类别很多时(ImageNet 有 1000 类,语言模型的词表有几万个词),只看得分最高的一个类别过于严格。top-k 准确率是指正确类别出现在得分最高的$k$个类别之中的比例,top-1 就是普通的准确率
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import torch
from sklearn.metrics import top_k_accuracy_score
from torchmetrics.classification import MulticlassAccuracy


def topk_accuracy(logits, target, k):
    topk = logits.topk(k, dim=1).indices  # (N, k),每个样本得分最高的k个类别
    return (topk == target[:, None]).any(dim=1).float().mean().item()


torch.manual_seed(0)
num_classes = 100
target = torch.randint(0, num_classes, (1000,))
logits = torch.randn(1000, num_classes)
logits[torch.arange(1000), target] += 2.0  # 让正确类别的得分偏高一些

for k in (1, 5):
    print(f"top-{k}: {topk_accuracy(logits, target, k):.3f}", end=" ")
    print(f"{top_k_accuracy_score(target, logits, k=k, labels=range(num_classes)):.3f}", end=" ")
    print(f"{MulticlassAccuracy(num_classes=num_classes, top_k=k, average='micro')(logits, target).item():.3f}")
1
2
top-1: 0.327 0.327 0.327
top-5: 0.634 0.634 0.634
困惑度
语言模型逐词预测下一个词,评估时看它给正确的词分配了多大的概率。困惑度(Perplexity,PPL)是平均交叉熵的指数,其中$N$是词的总数,$p$是模型给每个位置上正确的词分配的概率
\[\text{PPL} = \exp\left( -\frac{1}{N} \sum_{i} \log p_{i} \right)\]困惑度可以理解为模型在每个位置上“相当于在多少个词中均匀地猜”:对所有词给出相同的概率时,困惑度等于词表大小;每次都以概率 1 预测对时,困惑度为 1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
import math

import torch
import torch.nn.functional as F
from torchmetrics.text import Perplexity

torch.manual_seed(0)
vocab_size = 1000
target = torch.randint(1, vocab_size, (4, 16))  # (N, L),每个位置正确的下一个词
target[0, 10:] = 0                              # 编号0为填充,第1个句子只有10个词
target[1, 4:] = 0                               # 第2个句子只有4个词

logits = torch.randn(4, 16, vocab_size)         # (N, L, 词表大小)
logits.scatter_add_(2, target[:, :, None], torch.full((4, 16, 1), 5.0))  # 让正确的词得分偏高
logits[:, :, 0][target == 0] += 10.0            # 填充的位置很容易预测

loss = F.cross_entropy(logits.reshape(-1, vocab_size), target.reshape(-1), ignore_index=0)
print(f"{loss.item():.4f} {loss.exp().item():.1f}")  # 交叉熵和困惑度

print(f"{Perplexity(ignore_index=0)(logits, target).item():.1f}")  # 与torchmetrics的结果一致

# 模型对所有词给出相同的概率时,困惑度等于词表大小
uniform = torch.zeros(4, 16, vocab_size)
print(f"{F.cross_entropy(uniform.reshape(-1, vocab_size), target.reshape(-1), ignore_index=0).exp().item():.1f}")  # 1000.0
print(f"{math.log(vocab_size):.4f}")  # 6.9078,对应的交叉熵

# 错误的做法一:把填充的位置也算进去
wrong = F.cross_entropy(logits.reshape(-1, vocab_size), target.reshape(-1))
print(f"{wrong.exp().item():.1f}")

# 错误的做法二:先求每个句子的困惑度,再取平均
per_token = F.cross_entropy(logits.reshape(-1, vocab_size), target.reshape(-1), ignore_index=0, reduction="none")
per_token = per_token.reshape(4, 16)
lengths = (target != 0).sum(dim=1)
per_sentence = (per_token.sum(dim=1) / lengths).exp()
print(per_sentence, f"{per_sentence.mean().item():.1f}")
1
2
3
4
5
6
2.4118 11.2
11.2
1000.0
6.9078
5.7
tensor([ 7.7862,  7.2947, 12.4193, 13.9451]) 10.4
- 填充的位置不能计入。填充很容易预测,算进去之后困惑度从 11.2 变成 5.7,模型看起来好了一倍,而且这个数值会随批次中填充的多少而变化
- 困惑度要由所有词的平均交叉熵取指数得到。先求每个句子的困惑度再平均(10.4),或者先求每个批次的困惑度再平均,结果都不同
- 困惑度与分词方式和词表有关,使用不同分词器的模型之间不能直接比较
- 困惑度只衡量模型对文本的预测能力。评价生成结果的质量时还有 BLEU、ROUGE(文本与参考答案的重合程度)、FID(生成图像与真实图像的分布差异)等指标
正确地累积指标
验证集是分批送入模型的,最后需要的是整个验证集上的指标。常见的错误是每个批次算一次指标,再对批次取平均
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import torch
from sklearn.metrics import f1_score

torch.manual_seed(0)
# 220个样本按类别排好:前200个为负类,后20个为正类,验证集不打乱时就是这样的顺序
target = torch.tensor([0] * 200 + [1] * 20)
wrong = torch.cat([torch.rand(200) < 0.05, torch.rand(20) < 0.5])  # 负类错5%,正类错一半
pred = torch.where(wrong, 1 - target, target)

# 批大小为64,最后一个批次只有28个样本
batches = list(zip(pred.split(64), target.split(64)))
print([len(t) for _, t in batches])  # [64, 64, 64, 28]

# 错误的做法:每个批次算一次指标,最后取平均
batch_accuracy = [(p == t).float().mean().item() for p, t in batches]
batch_f1 = [f1_score(t, p, zero_division=0) for p, t in batches]
print([round(v, 4) for v in batch_accuracy], round(sum(batch_accuracy) / len(batches), 4))
print([round(v, 4) for v in batch_f1], round(sum(batch_f1) / len(batches), 4))

# 正确的做法:累积计数,最后算一次
correct = total = tp = fp = fn = 0
for p, t in batches:
    correct += (p == t).sum().item()
    total += len(t)
    tp += ((p == 1) & (t == 1)).sum().item()
    fp += ((p == 1) & (t == 0)).sum().item()
    fn += ((p == 0) & (t == 1)).sum().item()
print(round(correct / total, 4), round(2 * tp / (2 * tp + fp + fn), 4))

# 与在整个数据集上直接计算的结果一致
print(round((pred == target).float().mean().item(), 4), round(f1_score(target, pred), 4))
1
2
3
4
5
[64, 64, 64, 28]
[0.9375, 0.9219, 0.9375, 0.6071] 0.851
[0.0, 0.0, 0.0, 0.6207] 0.1552
0.8909 0.4286
0.8909 0.4286
- 准确率:对批次取平均得到 0.851,实际是 0.8909。最后一个批次只有 28 个样本,却与其他批次有相同的权重。只有每个批次大小相同时,两种算法才相等
- F1:对批次取平均得到 0.1552,实际是 0.4286。前三个批次中没有正类,F1 为 0。精确率、召回率、F1、AUC、mIoU 这些指标都不是“每个样本的值的平均”,即使批大小相同,也不能对批次取平均
- 损失同样如此:
loss.item()是批内平均,累积时要乘以批大小,最后除以样本总数
正确的做法是在循环中只累积计数(或者保存所有的预测和标签),循环结束后计算一次。torchmetrics的指标对象就是这样设计的
| 方法 | 作用 |
|---|---|
update(pred, target) | 把一个批次累积到内部状态中,不返回结果 |
compute() | 根据累积的状态计算整个数据集上的指标 |
reset() | 清空内部状态 |
metric(pred, target) | 返回当前批次的指标,同时累积到内部状态中 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import torch
from torchmetrics import MetricCollection
from torchmetrics.classification import BinaryAccuracy, BinaryF1Score, BinaryPrecision, BinaryRecall

torch.manual_seed(0)
target = torch.tensor([0] * 200 + [1] * 20)
wrong = torch.cat([torch.rand(200) < 0.05, torch.rand(20) < 0.5])
pred = torch.where(wrong, 1 - target, target)

metrics = MetricCollection({
    "accuracy": BinaryAccuracy(),
    "precision": BinaryPrecision(),
    "recall": BinaryRecall(),
    "f1": BinaryF1Score(),
})

for epoch in range(2):
    metrics.reset()           # 每一轮评估开始前清空上一轮累积的计数
    for p, t in zip(pred.split(64), target.split(64)):
        metrics.update(p, t)  # 只累积计数,不计算结果
    result = metrics.compute()
    print({ name: round(value.item(), 4) for name, value in result.items() })

# 直接调用metric(pred, target)返回的是当前批次的结果,同时也会累积
f1 = BinaryF1Score()
for p, t in zip(pred.split(64), target.split(64)):
    print(round(f1(p, t).item(), 4), end=" ")  # 0.0 0.0 0.0 0.6207
print(round(f1.compute().item(), 4))           # 0.4286

# 忘记reset时,上一轮的计数会留下来
for p, t in zip(pred.split(64), target.split(64)):
    f1.update(p, t)
print((f1.tp + f1.fp + f1.tn + f1.fn).item())  # 440,每个样本被算了两次
1
2
3
4
{'accuracy': 0.8909, 'f1': 0.4286, 'precision': 0.4091, 'recall': 0.45}
{'accuracy': 0.8909, 'f1': 0.4286, 'precision': 0.4091, 'recall': 0.45}
0.0 0.0 0.0 0.6207 0.4286
440
- 每一轮评估开始前调用
reset(),否则上一轮的计数会混进来 - 训练循环中打印
metric(pred, target)的返回值时,看到的是单个批次的指标,波动很大,不要把它当作整个数据集上的结果 MetricCollection把多个指标打包在一起,一次update更新全部- 指标对象内部的状态也是张量,模型在 GPU 上时需要
metrics.to(device) Binary开头的指标可以直接传入概率,内部按threshold=0.5转换为类别;Multiclass开头的指标可以直接传入形状为$(N, K)$的模型输出,内部取argmax
如何选择指标
| 任务 | 推荐指标 | 注意事项 |
|---|---|---|
| 类别均衡的分类 | 准确率,配合混淆矩阵 | 混淆矩阵用来查看错在哪些类别之间 |
| 类别不平衡的分类 | 精确率、召回率、F1,macro平均 | 不要只看准确率;同时列出每个类别的指标 |
| 需要选择阈值的二分类 | PR 曲线与 AP,或 ROC 曲线与 AUC | 正类很少时用 PR;阈值在验证集上选 |
| 类别很多的分类 | top-1 与 top-5 准确率 | top-5 只在类别很多时有意义 |
| 回归 | MAE 与 RMSE,配合 R² | 两者相差很大说明有离群值;注意单位 |
| 语义分割 | mIoU 或 Dice | 确认是哪一个;注意没有出现的类别如何处理 |
| 目标检测 | mAP | 说明 IoU 阈值,mAP@0.5 与 COCO 的 mAP 相差很大 |
| 语言模型 | 困惑度 | 不计入填充;分词方式不同时不能比较 |
无论哪种任务,都有几条通用的原则
- 指标要与实际的目标一致。先想清楚哪种错误的代价更高,再决定看哪个指标,而不是哪个数值好看用哪个
- 只报告一个数会掩盖问题,至少同时看一个总体指标和每个类别各自的指标
- 用作保存最优模型、提前停止训练的依据的指标,要在验证集上计算;测试集只在最后使用一次
- 与别人的结果比较之前,确认平均方式、阈值、是否包含背景类等细节是否一致