PyTorch Training
整理 PyTorch 的训练流程,包括损失函数、优化器与学习率调度、训练与验证循环,以及梯度裁剪、梯度累积、混合精度、提前停止等训练技巧
深度学习系列:第 5 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
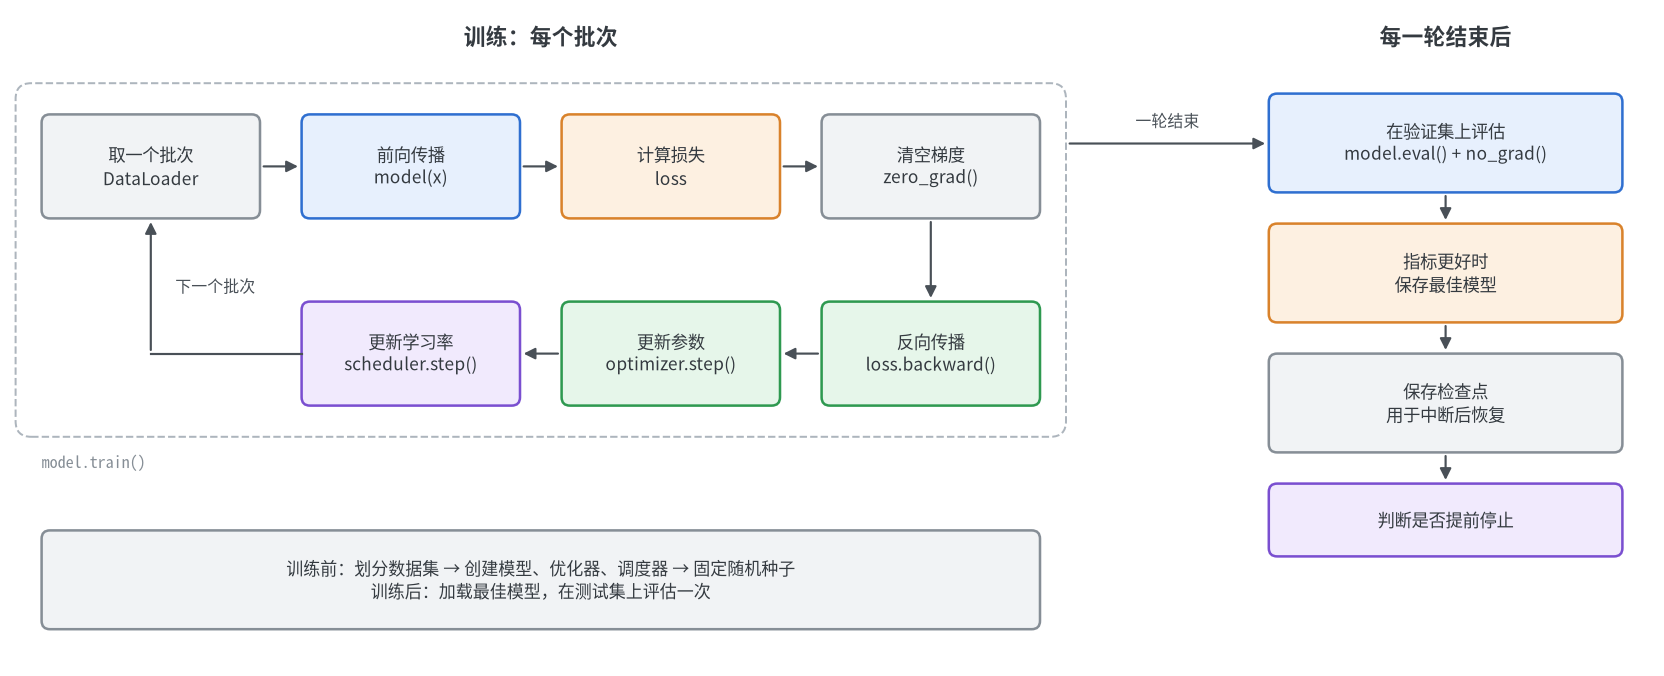
PyTorch CNN和PyTorch Transformer只讲了怎样搭建模型,这里整理把模型训练出来所需的其余部分。一次训练由两层循环组成:内层对每个批次做前向传播、反向传播和参数更新,外层在每一轮结束后验证、保存。数据的加载与增强见PyTorch Data Loading,检查点与可复现性见PyTorch Checkpoints and Reproducibility
损失函数
| 任务 | 损失函数 | 模型输出 | 标签 |
|---|---|---|---|
| 多分类,每个样本属于一个类别 | nn.CrossEntropyLoss | (N, K),原始输出 | (N,),int64的类别编号 |
| 二分类 | nn.BCEWithLogitsLoss | (N,),原始输出 | (N,),float的 0 或 1 |
| 多标签,每个样本可属于多个类别 | nn.BCEWithLogitsLoss | (N, K),原始输出 | (N, K),float的 0 或 1 |
| 语义分割 | nn.CrossEntropyLoss | (N, K, H, W) | (N, H, W),int64 |
| 回归 | nn.MSELoss、nn.L1Loss、nn.SmoothL1Loss | 与标签形状相同 | float |
其中 K 为类别数。原始输出指最后一个线性层的结果,没有经过softmax或sigmoid,通常称为 logits。每个损失函数都有类和函数两种写法,nn.CrossEntropyLoss()(logits, target)与F.cross_entropy(logits, target)等价
交叉熵
CrossEntropyLoss内部已经包含了log_softmax,模型的最后一层不要再加softmax
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
import torch
import torch.nn.functional as F

torch.manual_seed(0)
logits = torch.randn(4, 3)           # (N, K),模型的原始输出,没有经过softmax
target = torch.tensor([0, 2, 1, 2])  # (N,),类别编号,int64

print(F.cross_entropy(logits, target))  # tensor(0.9357)
# 等价于log_softmax之后取出正确类别的值,取负再求平均
print(-logits.log_softmax(dim=-1)[torch.arange(4), target].mean())  # tensor(0.9357)

# 错误:先做softmax再传入。不报错,但预测完全正确时损失也降不下去
confident = torch.tensor([[20.0, 0.0, 0.0]])
print(F.cross_entropy(confident, torch.tensor([0])))                     # tensor(0.)
print(F.cross_entropy(confident.softmax(dim=-1), torch.tensor([0])))     # tensor(0.5514)

# 错误:标签是浮点数
try:
    F.cross_entropy(logits, target.float())
except RuntimeError as error:
    print(error)  # expected target dtype to be Long or Byte, but got Float

# 标签也可以是每个类别的概率,形状与logits相同,用于软标签、mixup
print(F.cross_entropy(logits, F.one_hot(target, 3).float()))  # tensor(0.9357)

# 类别权重:带权重时的平均是除以权重之和,而不是除以样本数
weight = torch.tensor([1.0, 2.0, 5.0])
each = F.cross_entropy(logits, target, reduction="none")
print(F.cross_entropy(logits, target, weight=weight))        # tensor(1.2446)
print((each * weight[target]).sum() / weight[target].sum())  # tensor(1.2446)

# 标签平滑:正确类别的目标概率从1降为0.9 + 0.1 / 3,其余类别各为0.1 / 3
print(F.cross_entropy(logits, target, label_smoothing=0.1))  # tensor(0.9909)

# ignore_index:标签为-100的样本不计入损失,也不计入平均的分母
print(F.cross_entropy(logits, torch.tensor([0, 2, -100, -100])))  # tensor(1.2110)
print(each[:2].mean())                                            # tensor(1.2110)
| 参数 | 作用 |
|---|---|
weight | 每个类别的权重,形状为 (K,),类别不均衡时给样本少的类别更大的权重。BCEWithLogitsLoss中对应的是pos_weight |
label_smoothing | 标签平滑,取 0.1 左右。不要求模型对正确类别输出接近 1 的概率,减轻过拟合和过度自信 |
ignore_index | 标签等于该值的样本不计入损失,默认为 -100,常用于忽略填充位置 |
reduction | 'mean'求平均(默认)、'sum'求和、'none'返回每个样本的损失 |
- 先做
softmax再传入不会报错。此时输入被当作 logits 又做了一次softmax,预测完全正确时损失也只能降到 0.5514,模型学得很慢 - 模型输出的维度是 (N, K, …),类别在第 1 维。语言模型的输出为 (N, L, K),需要把前两维合并成 (N × L, K) 再计算
- 推理时需要概率才对 logits 做
softmax,只需要预测的类别时直接取argmax
二元交叉熵
二分类和多标签分类中,每个输出各自表示一个“是或否”的概率,使用sigmoid而不是softmax
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import torch
from torch import nn

logits = torch.tensor([2.0, -1.0, 0.5])
target = torch.tensor([1.0, 0.0, 1.0])  # 浮点数,形状与logits相同

print(nn.BCEWithLogitsLoss()(logits, target))    # tensor(0.3048)
print(nn.BCELoss()(logits.sigmoid(), target))    # tensor(0.3048),数值正常时两者相同

# logits很大时,sigmoid在float32下饱和为1,BCELoss只能得到被截断的结果
logits = torch.tensor([30.0, 100.0])
target = torch.tensor([0.0, 0.0])
print(logits.sigmoid())                                           # tensor([1., 1.])
print(nn.BCEWithLogitsLoss(reduction="none")(logits, target))     # tensor([ 30., 100.])
print(nn.BCELoss(reduction="none")(logits.sigmoid(), target))     # tensor([100., 100.])
BCEWithLogitsLoss接收 logits,内部包含sigmoid;BCELoss接收的是已经过sigmoid的概率- 应当使用
BCEWithLogitsLoss。sigmoid在 logits 较大时会饱和为 1,BCELoss再取对数时只能得到被截断的值 100,损失和梯度都不再准确 - 标签必须是浮点数,形状与输出相同,这一点与
CrossEntropyLoss相反
优化器
各个优化器的更新公式和学习率调度的原理见Optimizers and Learning Rate Schedules,这里只整理用法
| 优化器 | 特点 | 常见设置 |
|---|---|---|
SGD | 沿梯度的反方向更新,不带动量时收敛慢 | 很少单独使用 |
SGD加动量 | 累积之前的梯度方向,收敛更快更稳,常用于卷积网络 | lr=0.1、momentum=0.9、weight_decay=1e-4 |
Adam | 为每个参数自动调整步长,对学习率不敏感 | lr=1e-3 |
AdamW | 修正了Adam中权重衰减的实现,是 Transformer 的默认选择 | lr=1e-3到1e-4、weight_decay=0.01到0.05 |
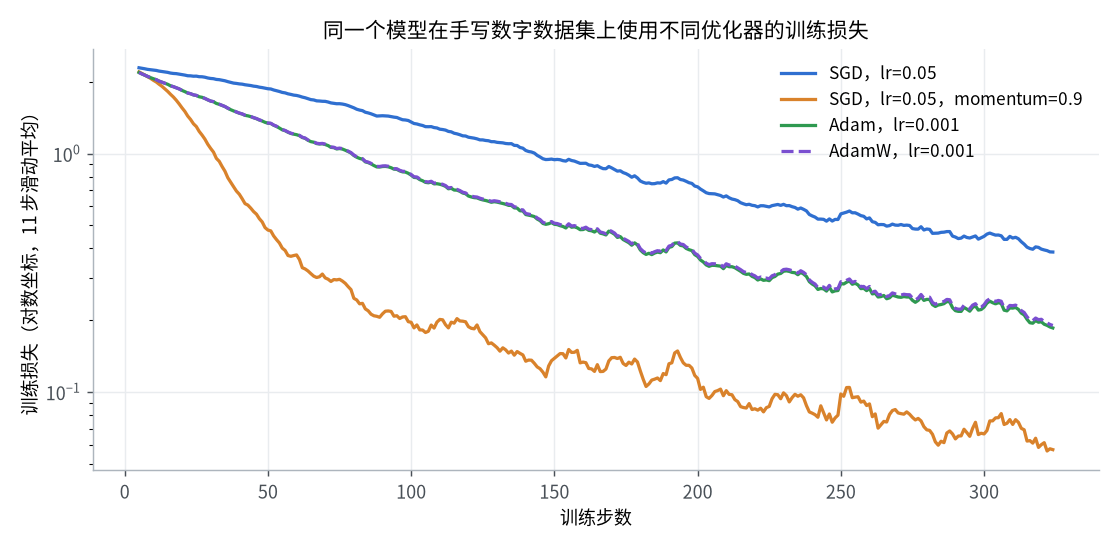
下图是同一个模型在手写数字数据集上用四种优化器各训练 15 轮的损失。带动量的SGD明显快于不带动量的;Adam与AdamW在这个小任务上几乎重合。哪一个更快取决于学习率的设置,不能据此认为某个优化器更好
权重衰减
权重衰减在每一步把参数向 0 拉近一点,用来抑制过拟合。需要权重衰减时使用AdamW,不要给Adam设置weight_decay:Adam把衰减项加到梯度上,再和梯度一起被自适应的步长归一化,衰减的实际强度与设置的系数几乎无关。两者的数值对比见Normalization and Regularization
参数组
偏置和归一化层的参数通常不做权重衰减:它们数量很少,不会造成过拟合,把归一化层的缩放系数拉向 0 反而有害。优化器可以接收多个参数组,每组使用各自的选项
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
import torch
from torch import nn

model = nn.Sequential(
    nn.Conv2d(1, 16, kernel_size=3, padding=1), nn.BatchNorm2d(16), nn.ReLU(),
    nn.Flatten(), nn.Linear(16 * 8 * 8, 10),
)

decay, no_decay = [], []
for name, param in model.named_parameters():
    if not param.requires_grad:
        continue
    # 维度小于2的是偏置和归一化层的缩放、偏移;卷积核和全连接层的权重至少是2维
    (no_decay if param.ndim < 2 else decay).append(param)
    print(f"{name:10s} {str(tuple(param.shape)):16s} {'不衰减' if param.ndim < 2 else '衰减'}")

optimizer = torch.optim.AdamW([
    {"params": decay, "weight_decay": 0.05},
    {"params": no_decay, "weight_decay": 0.0},
], lr=1e-3)  # 没有单独指定的选项(这里是lr)对所有组生效

for group in optimizer.param_groups:
    print(len(group["params"]), group["lr"], group["weight_decay"])
1
2
3
4
5
6
7
8
0.weight   (16, 1, 3, 3)    衰减
0.bias     (16,)            不衰减
1.weight   (16,)            不衰减
1.bias     (16,)            不衰减
4.weight   (10, 1024)       衰减
4.bias     (10,)            不衰减
2 0.001 0.05
4 0.001 0.0
参数组同样可以用来给不同的部分设置不同的学习率,在对应的组中写上"lr"即可,例如微调时让预训练的主干使用比新加的分类头更小的学习率
学习率调度
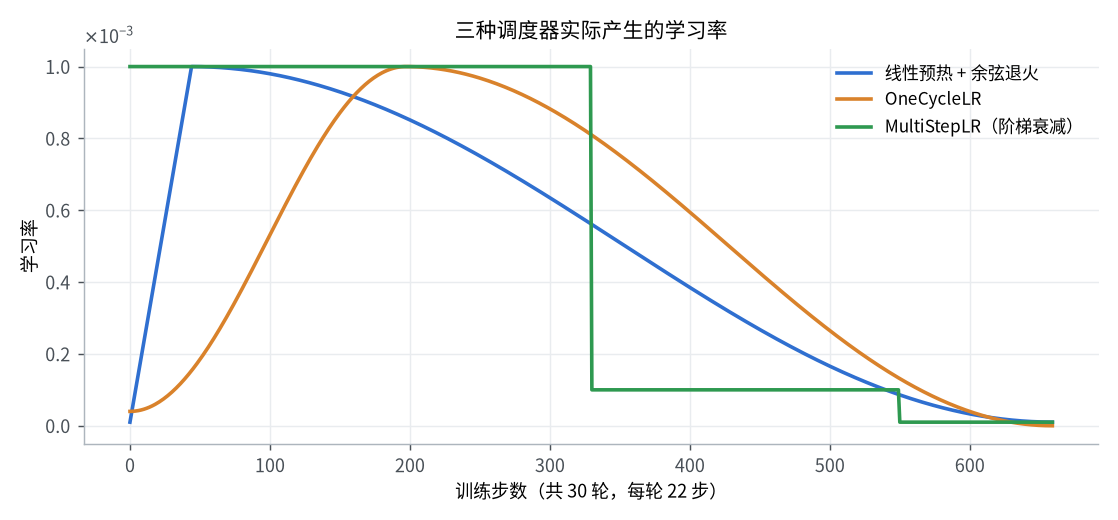
学习率在整个训练过程中通常不是固定的:开始时用较小的值预热,避免参数还很随机时一步走得太远;之后逐渐减小,使模型在后期稳定下来
| 调度器 | 学习率的变化 | 调用step()的时机 |
|---|---|---|
LinearLR加CosineAnnealingLR | 先线性升到设定值,再按余弦曲线降到最小值 | 每个批次 |
OneCycleLR | 从较小的值按余弦升到max_lr,再降到接近 0 | 每个批次 |
StepLR、MultiStepLR | 每隔固定轮数、或在指定的轮数乘以gamma | 每一轮 |
ReduceLROnPlateau | 验证指标连续patience轮没有改善时乘以factor | 每一轮,传入指标:scheduler.step(val_loss) |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
import torch
from torch import nn
from torch.optim import lr_scheduler

epochs, steps_per_epoch = 30, 22
total_steps = epochs * steps_per_epoch  # 660
warmup_steps = 2 * steps_per_epoch      # 前2轮预热

def make_optimizer():
    return torch.optim.AdamW(nn.Linear(2, 2).parameters(), lr=1e-3)

def warmup_cosine(optimizer):
    warmup = lr_scheduler.LinearLR(optimizer, start_factor=0.01, total_iters=warmup_steps)
    cosine = lr_scheduler.CosineAnnealingLR(optimizer, T_max=total_steps - warmup_steps, eta_min=1e-5)
    return lr_scheduler.SequentialLR(optimizer, [warmup, cosine], milestones=[warmup_steps])

def one_cycle(optimizer):
    return lr_scheduler.OneCycleLR(optimizer, max_lr=1e-3, total_steps=total_steps, pct_start=0.3)

def step_decay(optimizer):
    # 第15、25轮结束时各乘以0.1。这里每个批次调用一次step(),所以把轮数换算成步数
    return lr_scheduler.MultiStepLR(optimizer, milestones=[15 * steps_per_epoch, 25 * steps_per_epoch], gamma=0.1)

curves = {}
for name, make in [("warmup_cosine", warmup_cosine), ("one_cycle", one_cycle), ("step_decay", step_decay)]:
    optimizer = make_optimizer()
    scheduler = make(optimizer)
    lrs = []
    for step in range(total_steps):
        lrs.append(scheduler.get_last_lr()[0])  # 这一步实际使用的学习率
        optimizer.step()
        scheduler.step()                        # 在optimizer.step()之后调用
    curves[name] = lrs
    print(f"{name:14s} 开始 {lrs[0]:.2e}  最大 {max(lrs):.2e}(第 {lrs.index(max(lrs))} 步)  结束 {lrs[-1]:.2e}")
1
2
3
warmup_cosine  开始 1.00e-05  最大 1.00e-03(第 44 步)  结束 1.00e-05
one_cycle      开始 4.00e-05  最大 1.00e-03(第 197 步)  结束 4.00e-09
step_decay     开始 1.00e-03  最大 1.00e-03(第 0 步)  结束 1.00e-05
- 调度器只按
step()被调用的次数计数,并不知道一步是一个批次还是一轮。T_max、total_steps、milestones的单位必须与调用的频率一致,按批次调用却按轮数设置,学习率会在第一轮内就走完全程 scheduler.step()要在optimizer.step()之后调用,顺序反了会收到警告,并且跳过第一个学习率OneCycleLR的学习率完全由max_lr决定,创建优化器时设置的lr不起作用。起始值为max_lr / 25,前 30% 的步数用于上升OneCycleLR的总步数是固定的,调用次数超过total_steps会报错Tried to step 11 times. The specified number of total steps is 10SequentialLR把多个调度器首尾相接,milestones指定在第几步切换到下一个
训练与验证循环
下面在手写数字数据集上完整地训练一个小型卷积网络。以下代码按顺序放在同一个文件中
数据与模型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import copy

import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn
from torch.utils.data import DataLoader, TensorDataset

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

digits = load_digits()
images = torch.from_numpy(digits.images).float().unsqueeze(1) / 16  # (1797, 1, 8, 8)
labels = torch.from_numpy(digits.target).long()

indices = torch.randperm(len(images), generator=torch.Generator().manual_seed(0))
train_idx, val_idx = indices[:1437], indices[1437:]
mean, std = images[train_idx].mean(), images[train_idx].std()       # 只用训练集统计
images = (images - mean) / std                                      # 训练集和验证集用同一组统计量

train_loader = DataLoader(TensorDataset(images[train_idx], labels[train_idx]),
                          batch_size=64, shuffle=True, drop_last=True)
val_loader = DataLoader(TensorDataset(images[val_idx], labels[val_idx]), batch_size=256)

def make_model():
    return nn.Sequential(
        nn.Conv2d(1, 32, kernel_size=3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
        nn.MaxPool2d(2),                                            # 8x8 -> 4x4
        nn.Conv2d(32, 64, kernel_size=3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
        nn.AdaptiveAvgPool2d(1), nn.Flatten(),
        nn.Dropout(0.3),
        nn.Linear(64, 10),
    )
训练与验证函数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
def train_one_epoch(model, loader, optimizer, scheduler):
    model.train()                                  # Dropout生效,BatchNorm使用当前批次的统计量
    total_loss, correct, count = 0.0, 0, 0
    for images, labels in loader:
        images, labels = images.to(device), labels.to(device)

        logits = model(images)
        loss = F.cross_entropy(logits, labels)

        optimizer.zero_grad()                      # 清空上一步的梯度,否则梯度会累加
        loss.backward()                            # 反向传播,计算梯度
        optimizer.step()                           # 更新参数
        scheduler.step()                           # 更新学习率,在optimizer.step()之后

        # loss是这个批次的平均值,乘以样本数还原成总和;.item()取出数值,不保留计算图
        total_loss += loss.item() * len(labels)
        correct += (logits.argmax(dim=-1) == labels).sum().item()
        count += len(labels)
    return total_loss / count, correct / count

@torch.no_grad()                                   # 不记录计算图,省内存、更快
def evaluate(model, loader):
    model.eval()                                   # Dropout关闭,BatchNorm使用训练中累计的统计量
    total_loss, correct, count = 0.0, 0, 0
    for images, labels in loader:
        images, labels = images.to(device), labels.to(device)
        logits = model(images)
        total_loss += F.cross_entropy(logits, labels, reduction="sum").item()
        correct += (logits.argmax(dim=-1) == labels).sum().item()
        count += len(labels)
    return total_loss / count, correct / count
| 操作 | 训练 | 验证 |
|---|---|---|
| 模式 | model.train() | model.eval() |
| 梯度 | 需要 | 用torch.no_grad()关闭 |
| 反向传播与参数更新 | 有 | 没有 |
| 数据 | 打乱,带随机增强 | 不打乱,固定的变换 |
zero_grad()、backward()、step()三者的顺序固定。PyTorch 中的梯度是累加的,每次反向传播之前必须清空model.eval()只切换Dropout和BatchNorm的行为,并不关闭梯度;torch.no_grad()只关闭梯度,并不改变层的行为。验证时两者都需要- 统计损失时用
loss.item()取出数值。直接累加loss张量会把每一步的计算图都留在内存中 - 一轮的平均损失要按样本数加权。验证时最后一个批次通常不满,把各批次的平均值直接再取平均是不准确的:10 个样本的损失为 0 到 9、批大小为 4 时,这样算出的是 5.17,而实际的平均值是 4.5
主循环
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
epochs = 30
model = make_model().to(device)
optimizer = torch.optim.AdamW(model.parameters(), lr=3e-3, weight_decay=0.05)
scheduler = torch.optim.lr_scheduler.OneCycleLR(optimizer, max_lr=3e-3,
                                                total_steps=epochs * len(train_loader))

history = []
best_accuracy, best_epoch, best_state = 0.0, 0, None
for epoch in range(1, epochs + 1):
    train_loss, train_accuracy = train_one_epoch(model, train_loader, optimizer, scheduler)
    val_loss, val_accuracy = evaluate(model, val_loader)
    history.append((train_loss, train_accuracy, val_loss, val_accuracy))

    if val_accuracy > best_accuracy:
        best_accuracy, best_epoch = val_accuracy, epoch
        best_state = copy.deepcopy(model.state_dict())  # 必须深拷贝,见下文

    if epoch % 5 == 0 or epoch == 1:
        print(f"epoch {epoch:2d}  train loss {train_loss:.4f} acc {train_accuracy:.4f}  "
              f"val loss {val_loss:.4f} acc {val_accuracy:.4f}")

print(f"best epoch {best_epoch}, val acc {best_accuracy:.4f}")
model.load_state_dict(best_state)                       # 恢复到验证集上最好的那一轮
1
2
3
4
5
6
7
8
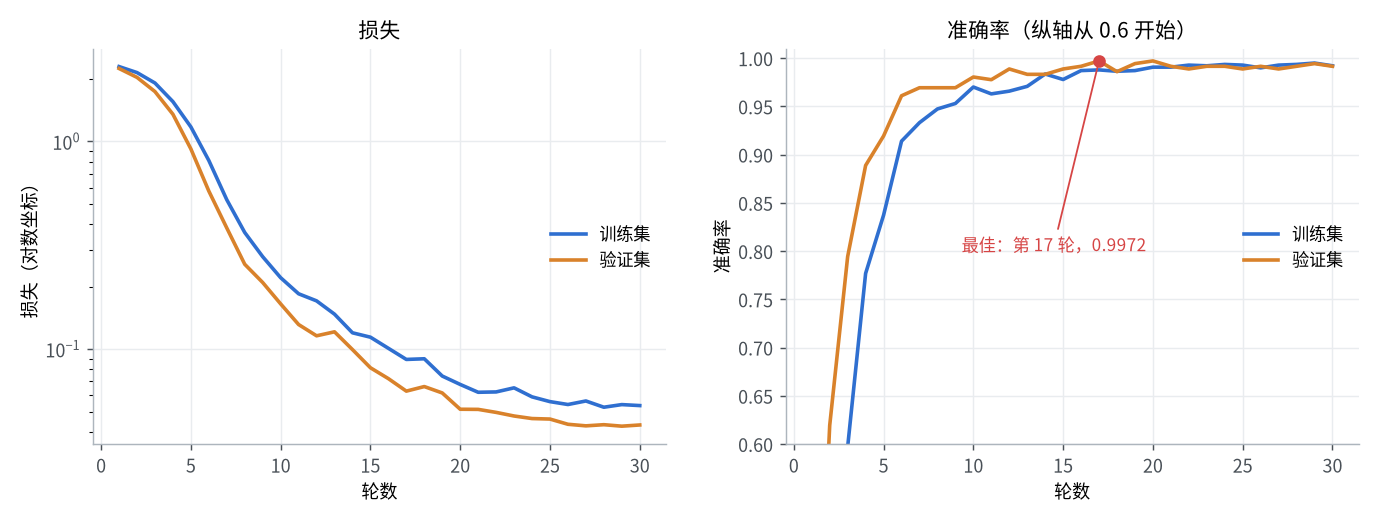
epoch  1  train loss 2.2931 acc 0.1378  val loss 2.2449 acc 0.2250
epoch  5  train loss 1.1748 acc 0.8374  val loss 0.9206 acc 0.9194
epoch 10  train loss 0.2208 acc 0.9702  val loss 0.1652 acc 0.9806
epoch 15  train loss 0.1142 acc 0.9780  val loss 0.0814 acc 0.9889
epoch 20  train loss 0.0676 acc 0.9908  val loss 0.0514 acc 0.9972
epoch 25  train loss 0.0559 acc 0.9929  val loss 0.0461 acc 0.9889
epoch 30  train loss 0.0535 acc 0.9922  val loss 0.0432 acc 0.9917
best epoch 17, val acc 0.9972
- 本文的输出来自一台 CPU 为 Intel Core Ultra 9 285K、GPU 为 GeForce RTX 5090 D(32 GB 显存)、内存为 64 GB 的机器。上面是在 CPU 上运行的结果,多次运行完全相同。在 GPU 上运行时数值略有不同,而且每次运行都不一样:两次运行中最好的一轮分别是第 15 轮和第 14 轮,准确率分别为 0.9944 和 0.9972
- 验证指标并不是单调变好的,最好的一轮是第 17 轮而不是最后一轮,所以要在训练过程中保留最好的参数
- 这里训练集的损失一直略高于验证集,是因为训练时
Dropout在起作用,并且训练集的指标是一轮中边训练边统计的平均值,而验证是在这一轮结束后进行的。验证损失开始上升而训练损失继续下降,才是过拟合的信号 - 验证集被用来挑选最好的一轮和调整超参数,它上面的指标是偏乐观的。要报告最终性能,需要另外留出一个始终不参与任何选择的测试集
常见错误
接着上面的代码,用训练好的模型验证两个常见的问题:验证时的归一化与训练时不一致(见PyTorch Data Loading),以及验证前没有调用model.eval()
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
loss, accuracy = evaluate(model, val_loader)
print(f"正常评估          loss {loss:.4f} acc {accuracy:.4f}")

# 错误1:验证数据没有做与训练时相同的归一化
raw_loader = DataLoader(TensorDataset(images[val_idx] * std + mean, labels[val_idx]), batch_size=256)
loss, accuracy = evaluate(model, raw_loader)
print(f"输入未归一化      loss {loss:.4f} acc {accuracy:.4f}")

# 错误2:评估时忘记调用model.eval()
@torch.no_grad()
def evaluate_in_train_mode(model, loader):
    model.train()
    correct = sum((model(images.to(device)).argmax(dim=-1) == labels.to(device)).sum().item()
                  for images, labels in loader)
    return correct / len(loader.dataset)

small_loader = DataLoader(val_loader.dataset, batch_size=4)  # 批越小,BatchNorm的批统计量越不准
state = copy.deepcopy(model.state_dict())
print(f"忘记 model.eval() acc {evaluate_in_train_mode(model, small_loader):.4f}")
changed = not torch.equal(state["1.running_mean"], model.state_dict()["1.running_mean"])
print("BatchNorm 的统计量被验证数据改动:", changed)
model.load_state_dict(state)
1
2
3
4
正常评估          loss 0.0628 acc 0.9972
输入未归一化      loss 5.6577 acc 0.1056
忘记 model.eval() acc 0.8694
BatchNorm 的统计量被验证数据改动: True
- 输入没有做与训练时相同的归一化,准确率从 0.9972 降到 0.1056,与随机猜测相当
- 没有调用
model.eval()时,Dropout仍在随机丢弃,BatchNorm用的是当前批次的统计量,批越小结果越差。更隐蔽的是BatchNorm累计的统计量会被验证数据改动,模型本身被修改了。这些层在两种模式下的行为见Normalization and Regularization
保留最好的参数时必须深拷贝。model.state_dict()返回的张量与模型共享内存,继续训练后它也跟着变,最后得到的只是最后一轮的参数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import copy

import torch
from torch import nn

model = nn.Linear(4, 2)
optimizer = torch.optim.SGD(model.parameters(), lr=0.1)

reference = model.state_dict()                # 只是引用,张量与模型共享内存
snapshot = copy.deepcopy(model.state_dict())  # 深拷贝,保留当时的值

model(torch.randn(8, 4)).sum().backward()
optimizer.step()                              # 继续训练一步

print(torch.equal(reference["weight"], model.weight))  # True,跟着模型一起变了
print(torch.equal(snapshot["weight"], model.weight))   # False
训练技巧
梯度裁剪
个别批次的梯度可能非常大,一步就把参数带到很差的位置。梯度裁剪在更新之前检查所有参数梯度的总范数,超过上限时整体按比例缩小,方向不变。它放在backward()之后、optimizer.step()之前
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
import torch
import torch.nn.functional as F
from torch import nn

torch.manual_seed(0)
model = nn.Linear(10, 1)
loss = F.mse_loss(model(torch.randn(16, 10)), torch.randn(16, 1) * 100)
loss.backward()

def grad_norm(model):
    return torch.cat([p.grad.flatten() for p in model.parameters()]).norm()

print(grad_norm(model))                                              # tensor(139.8301)
returned = nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
print(returned)                                                      # tensor(139.8301),返回的是裁剪前的范数
print(grad_norm(model))                                              # tensor(1.)
clip_grad_norm_的返回值是裁剪前的范数,把它记录下来可以观察训练是否稳定。max_norm常取 1.0,Transformer 和循环神经网络的训练中基本都会使用
梯度累积
显存放不下想要的批大小时,可以连续计算几个小批次的梯度并累加,再更新一次参数,效果等同于一个大批次
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import torch
import torch.nn.functional as F
from torch import nn

torch.manual_seed(0)
model = nn.Sequential(nn.Linear(10, 32), nn.ReLU(), nn.Linear(32, 3))
inputs, targets = torch.randn(64, 10), torch.randint(0, 3, (64,))

# 一次性计算64个样本的梯度
model.zero_grad()
F.cross_entropy(model(inputs), targets).backward()
full = [p.grad.clone() for p in model.parameters()]

# 分成4个批次,每个批次16个样本,梯度累加
accumulation_steps = 4
model.zero_grad()
for step, (x, y) in enumerate(zip(inputs.split(16), targets.split(16)), start=1):
    loss = F.cross_entropy(model(x), y) / accumulation_steps  # 除以累积次数,使累加后等于大批次的平均
    loss.backward()                                           # 不清空梯度,backward会累加
    if step % accumulation_steps == 0:
        # 实际训练时在这里调用optimizer.step()和optimizer.zero_grad()
        accumulated = [p.grad.clone() for p in model.parameters()]

print(all(torch.allclose(a, b, atol=1e-6) for a, b in zip(full, accumulated)))  # True
- 每个小批次的损失要除以累积次数,否则累加后的梯度是大批次的若干倍
- 调度器按参数更新的次数计步,总步数要相应地除以累积次数
- 模型中有
BatchNorm时并不完全等价,它的统计量仍然是按小批次计算的
混合精度
混合精度让大部分计算使用 16 位浮点数,在 GPU 上可以明显加快训练并减少显存占用。autocast自动为每个操作选择精度;16 位浮点数能表示的范围小,很小的梯度会变成 0,GradScaler先把损失放大再反向传播,更新参数之前再还原。这部分需要 GPU
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
import time

import torch
import torch.nn.functional as F
from torch import nn

assert torch.cuda.is_available(), "这个例子需要GPU"
device = "cuda"

def make_model():
    torch.manual_seed(0)
    return nn.Sequential(
        nn.Conv2d(3, 64, kernel_size=3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
        nn.Conv2d(64, 128, kernel_size=3, padding=1), nn.BatchNorm2d(128), nn.ReLU(),
        nn.Conv2d(128, 128, kernel_size=3, padding=1), nn.BatchNorm2d(128), nn.ReLU(),
        nn.AdaptiveAvgPool2d(1), nn.Flatten(), nn.Linear(128, 10),
    ).to(device)

images = torch.randn(32, 3, 64, 64, device=device)
labels = torch.randint(0, 10, (32,), device=device)

def train(use_amp, steps=50, report=True):
    model = make_model()
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3)
    scaler = torch.amp.GradScaler(device, enabled=use_amp)  # enabled=False时不做任何事
    torch.cuda.reset_peak_memory_stats()
    torch.cuda.synchronize()
    start = time.perf_counter()
    for _ in range(steps):
        # 只包住前向传播和损失计算
        with torch.autocast(device_type=device, dtype=torch.float16, enabled=use_amp):
            logits = model(images)
            loss = F.cross_entropy(logits, labels)

        optimizer.zero_grad()
        scaler.scale(loss).backward()  # 放大损失后反向传播
        scaler.unscale_(optimizer)     # 需要梯度裁剪时,先把梯度还原
        nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        scaler.step(optimizer)         # 代替optimizer.step(),梯度中出现inf或nan时跳过这一步
        scaler.update()                # 调整放大的倍数
    torch.cuda.synchronize()
    seconds = time.perf_counter() - start
    memory = torch.cuda.max_memory_allocated() / 2**20
    if report:
        print(f"混合精度 {str(use_amp):5s}  输出类型 {logits.dtype}  损失 {loss.item():.4f}  "
              f"{seconds:.2f} 秒  显存峰值 {memory:.0f} MiB")

train(use_amp=False, steps=5, report=False)  # 预热,不计入对比
train(use_amp=False)
train(use_amp=True)
1
2
混合精度 False  输出类型 torch.float32  损失 0.4460  0.21 秒  显存峰值 475 MiB
混合精度 True   输出类型 torch.float16  损失 0.4472  0.24 秒  显存峰值 237 MiB
- 显存峰值从 475 MiB 降到 237 MiB,约为原来的一半,损失与全精度基本相同
- 耗时没有减少,0.21 秒变成了 0.24 秒。这个模型和批次都很小,混合精度并不能让每一步变快
- 损失的数值每次运行都略有不同,原因见PyTorch Checkpoints and Reproducibility
模型变大之后才能看到速度上的收益。用同样的写法训练 torchvision 的 ResNet-50,批大小为 64、输入为 224×224 的随机张量,在同一块 GPU 上测得
| 设置 | 每步耗时 | 显存峰值 |
|---|---|---|
| 不使用混合精度 | 58 ms | 5473 MiB |
| 使用混合精度 | 33 ms | 2975 MiB |
每步耗时减少了四成多,显存占用降到一半左右。是否值得使用混合精度取决于模型的大小,小模型上主要的收益是显存
scaler.step(optimizer)和scaler.update()成对出现,代替原来的optimizer.step()。不做梯度裁剪时可以省去scaler.unscale_- 旧代码中的
torch.cuda.amp.autocast和torch.cuda.amp.GradScaler已被弃用,使用时会收到警告,改用torch.autocast和torch.amp.GradScaler BCELoss在autocast下会直接报错,提示它不能安全地用于混合精度,这是应当使用BCEWithLogitsLoss的另一个原因- 保存检查点时把
scaler.state_dict()一起保存
提前停止
验证指标连续若干轮没有改善时停止训练,既节省时间,也避免继续训练造成过拟合
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
class EarlyStopping:
    def __init__(self, patience=5, min_delta=0.0):
        self.patience, self.min_delta = patience, min_delta
        self.best, self.bad_epochs = float("inf"), 0

    def step(self, val_loss):
        """返回True表示应当停止"""
        if val_loss < self.best - self.min_delta:
            self.best, self.bad_epochs = val_loss, 0
        else:
            self.bad_epochs += 1
        return self.bad_epochs >= self.patience

stopper = EarlyStopping(patience=3)
for epoch, val_loss in enumerate([0.9, 0.6, 0.5, 0.52, 0.51, 0.55, 0.4], start=1):
    if stopper.step(val_loss):
        print(f"第 {epoch} 轮停止,最好的验证损失为 {stopper.best}")
        break
1
第 6 轮停止,最好的验证损失为 0.5
在主循环中每一轮验证之后调用stopper.step(val_loss),返回True时跳出循环。提前停止要与保留最佳参数配合使用,停止时模型已经比最好的一轮多训练了patience轮