PyTorch Fine-Tuning
整理 PyTorch 中迁移学习与微调的做法,包括加载预训练模型、冻结参数、分层学习率、加载部分权重与 LoRA,以及从头训练、特征提取、全量微调的对比实验
深度学习系列:第 16 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
- PyTorch Fine-Tuning
- Object Detection
- Image Segmentation
- Keypoint Detection
- Generative Models
微调是在一个已经训练好的模型上继续训练,让它适应新的任务。预训练模型在大数据集上学到的特征大部分可以直接复用,因此只需要很少的数据和很短的训练时间。训练循环本身的写法见PyTorch Training
迁移学习的几种做法
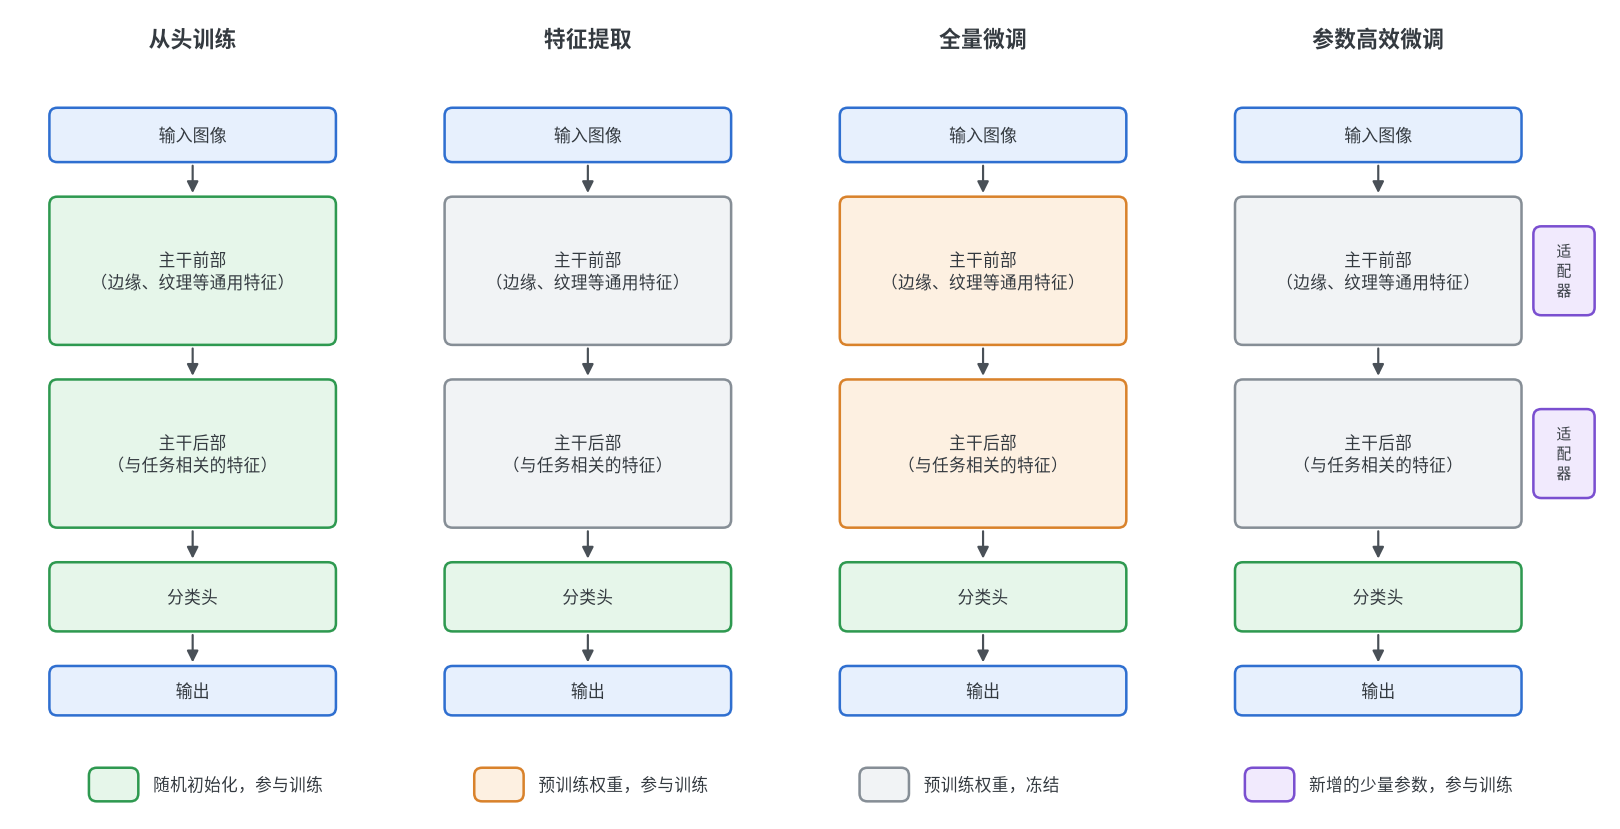
| 做法 | 训练的参数 | 需要的数据 | 计算量 | 适用场景 |
|---|---|---|---|---|
| 从头训练 | 全部,随机初始化 | 最多 | 最大 | 数据量很大,或者没有相近的预训练模型 |
| 特征提取 | 只有新的输出层 | 最少 | 最小 | 数据很少,新任务与预训练任务相近 |
| 全量微调 | 全部,从预训练权重开始 | 中等 | 较大 | 有一定数据量,新任务与预训练任务有差异 |
| 参数高效微调 | 新增的少量参数和输出层 | 较少 | 较小 | 模型很大,或者要为多个任务各保存一份权重 |
- 模型分为主干和头两部分:主干负责提取特征,头把特征变成具体任务的输出。迁移学习复用的是主干,头通常要换成新的
- 主干中越靠近输入的层学到的特征越通用(边缘、纹理),越靠近输出的层与原任务越相关。因此只微调一部分时,优先微调靠后的层
- 这几种做法不是互斥的,常见的顺序是先冻结主干训练新的头,再解冻主干用较小的学习率整体微调
加载预训练模型
权重与预处理
torchvision.models中的每个模型都有一个对应的权重枚举,同时记录了权重的来源、指标和配套的预处理方式
| 写法 | 含义 |
|---|---|
weights=ResNet18_Weights.DEFAULT | 当前效果最好的一组权重 |
weights=ResNet18_Weights.IMAGENET1K_V1 | 指定某一组权重,结果可以复现 |
weights=None | 不加载权重,随机初始化,这是默认值 |
weights.transforms() | 与这组权重配套的预处理 |
weights.meta | 类别名称、参数量、在原数据集上的指标等信息 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

weights = ResNet18_Weights.DEFAULT
print(weights)                              # ResNet18_Weights.IMAGENET1K_V1
print(weights.meta["num_params"])           # 11689512
print(len(weights.meta["categories"]))      # 1000
print(weights.meta["_metrics"]["ImageNet-1K"]["acc@1"])  # 69.758

model = resnet18(weights=weights)           # 第一次运行时自动下载权重
print(model.fc)                             # Linear(in_features=512, out_features=1000, bias=True)

# 替换分类头:新的层随机初始化,输出改为10类
model.fc = nn.Linear(model.fc.in_features, 10)
print(sum(p.numel() for p in model.parameters()))  # 11181642

preprocess = weights.transforms()
print(preprocess)

x = torch.rand(3, 300, 400)                 # 一张任意大小的图像,取值范围[0, 1]
print(preprocess(x).shape)                  # torch.Size([3, 224, 224])
model.eval()
print(model(preprocess(x).unsqueeze(0)).shape)  # torch.Size([1, 10])
1
2
3
4
5
6
7
ImageClassification(
    crop_size=[224]
    resize_size=[256]
    mean=[0.485, 0.456, 0.406]
    std=[0.229, 0.224, 0.225]
    interpolation=InterpolationMode.BILINEAR
)
- 权重下载后保存在
~/.cache/torch/hub/checkpoints/,之后不会重复下载 - 旧的写法
pretrained=True已经弃用,统一使用weights参数 weights.transforms()是推理时的预处理:缩放、中心裁剪、归一化。训练时可以换成带数据增强的版本,但归一化的均值和标准差要保持一致
预处理必须与预训练时一致。 预训练权重是在按特定均值和标准差归一化后的输入上学到的,输入的取值范围不对时不会报错,只是准确率明显下降。后面的实验中,同一个模型去掉归一化后,验证集准确率从 0.908 降到 0.318
替换分类头
不同模型的分类头名字不同,替换之前先把模型打印出来确认
| 模型 | 分类头 | 替换方式 |
|---|---|---|
| ResNet、ResNeXt、RegNet | model.fc | model.fc = nn.Linear(model.fc.in_features, K) |
| MobileNet、EfficientNet、VGG | model.classifier | 替换model.classifier[-1] |
| ConvNeXt | model.classifier | 替换model.classifier[2] |
| ViT | model.heads.head | 替换model.heads.head |
| Swin Transformer | model.head | 替换model.head |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
from torch import nn
from torchvision.models import convnext_tiny, efficientnet_b0, mobilenet_v3_small, swin_t, vit_b_16

model = mobilenet_v3_small()
model.classifier[-1] = nn.Linear(model.classifier[-1].in_features, 10)

model = efficientnet_b0()
model.classifier[-1] = nn.Linear(model.classifier[-1].in_features, 10)

model = convnext_tiny()
model.classifier[2] = nn.Linear(model.classifier[2].in_features, 10)

model = vit_b_16()
model.heads.head = nn.Linear(model.heads.head.in_features, 10)

model = swin_t()
model.head = nn.Linear(model.head.in_features, 10)
冻结参数
冻结与统计
参数的requires_grad为False时不计算梯度,也就不会被更新。module.requires_grad_(False)把一个模块中的所有参数一次性冻结
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18


def count(model):
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    return f"可训练 {trainable:,} / 全部 {total:,}"


model = resnet18(weights=ResNet18_Weights.DEFAULT)
model.requires_grad_(False)                     # 先冻结全部参数
model.fc = nn.Linear(model.fc.in_features, 10)  # 新建的层默认requires_grad=True
print(count(model))  # 可训练 5,130 / 全部 11,181,642

# 只把需要训练的参数交给优化器
optimizer = torch.optim.Adam([p for p in model.parameters() if p.requires_grad], lr=1e-3)
print(sum(p.numel() for group in optimizer.param_groups for p in group["params"]))  # 5130

# 冻结的参数不会计算梯度
model.eval()
loss = model(torch.randn(4, 3, 224, 224)).sum()
loss.backward()
print(model.conv1.weight.grad)        # None
print(model.fc.weight.grad.shape)     # torch.Size([10, 512])
- 先冻结、再替换分类头,新的层自然是可训练的;顺序反过来就要再单独把分类头解冻
- 冻结的层不需要保存中间结果用于反向传播,训练更快、占用的内存也更少
- 优化器只接收可训练的参数。之后再解冻某些层时,要用
optimizer.add_param_group把它们加进去,否则这些参数有梯度但不会被更新
BatchNorm 的运行统计量
冻结参数不会冻结 BatchNorm 的运行统计量。 running_mean和running_var不是参数,不靠梯度更新,而是在训练模式下每次前向传播时更新。只设置requires_grad_(False)而模型处于train()模式时,这些统计量会逐渐被新数据的统计量替换,主干的输出也随之改变
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

torch.manual_seed(0)
model = resnet18(weights=ResNet18_Weights.DEFAULT)
model.requires_grad_(False)
x = torch.randn(8, 3, 224, 224)

before = model.bn1.running_mean.clone()
model.train()
model(x)
print(torch.equal(before, model.bn1.running_mean))  # False,没有梯度、没有优化器,统计量仍然变了
print(model.bn1.num_batches_tracked)                # tensor(1)

before = model.bn1.running_mean.clone()
model.eval()
model(x)
print(torch.equal(before, model.bn1.running_mean))  # True


def freeze_bn(model):
    """把所有BatchNorm切换到推理模式,需要在每次model.train()之后调用"""
    for module in model.modules():
        if isinstance(module, nn.modules.batchnorm._BatchNorm):
            module.eval()


model.fc = nn.Linear(model.fc.in_features, 10)
model.train()
freeze_bn(model)
before = model.bn1.running_mean.clone()
model(x)
print(torch.equal(before, model.bn1.running_mean))  # True
print(model.training, model.bn1.training)           # True False
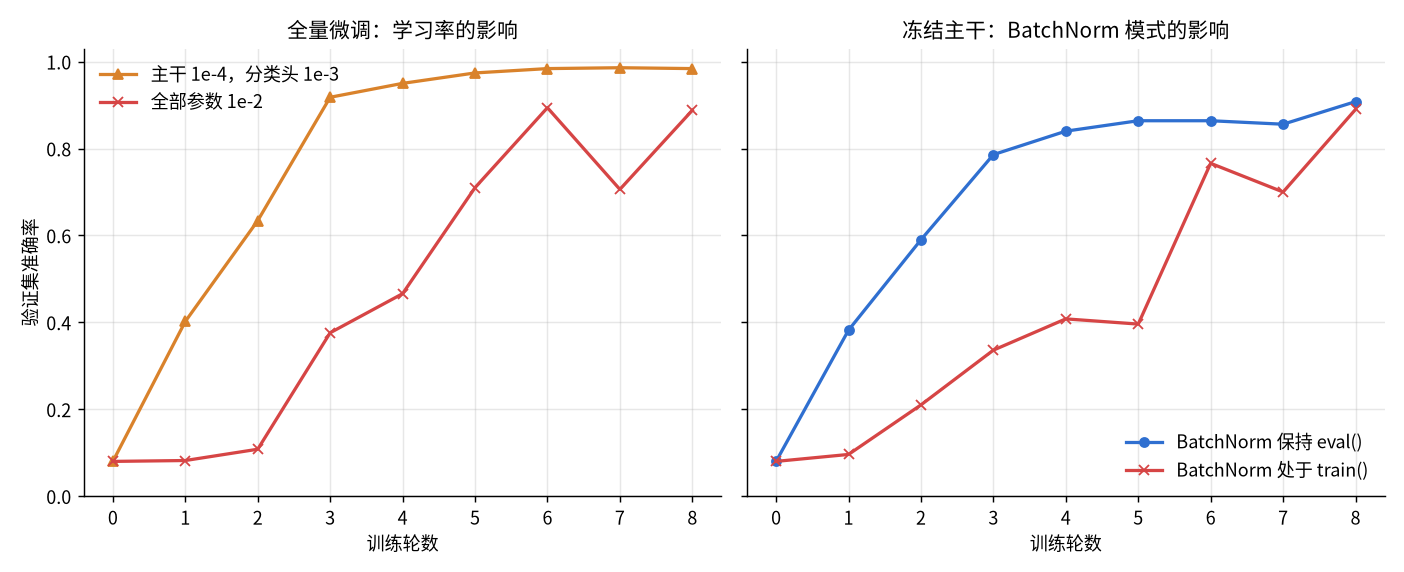
后面的实验中,冻结主干但让 BatchNorm 留在训练模式,第 1 轮之后的验证集准确率只有 0.096,保持推理模式时为 0.382
- 主干完全冻结、头里没有
Dropout时,训练期间直接让整个模型保持eval()即可 - 头里有
Dropout或者只冻结了一部分层时,用上面的freeze_bn只把 BatchNorm 切到推理模式 model.train()会把所有子模块重新设为训练模式,所以每个 epoch 调用model.train()之后都要再调用一次freeze_bn- 使用 LayerNorm 的模型(如 ViT)没有运行统计量,不存在这个问题
- 运行统计量的更新方式见Normalization and Regularization
分层学习率与逐步解冻
参数组
预训练的权重已经接近可用,只需要小幅调整;新的头是随机初始化的,需要较大的学习率。优化器可以接收多个参数组,每组使用各自的学习率,没有单独指定的选项使用默认值
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

model = resnet18(weights=ResNet18_Weights.DEFAULT)
model.fc = nn.Linear(model.fc.in_features, 10)

for name, child in model.named_children():
    print(f"{name:8s} {sum(p.numel() for p in child.parameters()):>9,}")

# 越靠近输入学习率越小,没有单独指定lr的组使用默认值
head = list(model.fc.parameters())
late = list(model.layer4.parameters())
head_ids = { id(p) for p in head + late }
early = [p for p in model.parameters() if id(p) not in head_ids]

optimizer = torch.optim.AdamW([
    { "params": early, "lr": 1e-5 },
    { "params": late, "lr": 1e-4 },
    { "params": head },
], lr=1e-3, weight_decay=0.01)

for group in optimizer.param_groups:
    print(group["lr"], sum(p.numel() for p in group["params"]))
1
2
3
4
5
6
7
8
9
10
11
12
13
conv1        9,408
bn1            128
relu             0
maxpool          0
layer1     147,968
layer2     525,568
layer3   2,099,712
layer4   8,393,728
avgpool          0
fc           5,130
1e-05 2782784
0.0001 8393728
0.001 5130
- 主干的学习率通常取头的十分之一到百分之一
- ResNet18 的参数有四分之三集中在
layer4,只解冻最后一个阶段就已经覆盖了大部分参数 - 同一个参数不能出现在两个组里,否则报错
some parameters appear in more than one parameter group - 学习率调度器对每个组分别生效,各组按各自的初始学习率等比例变化
逐步解冻
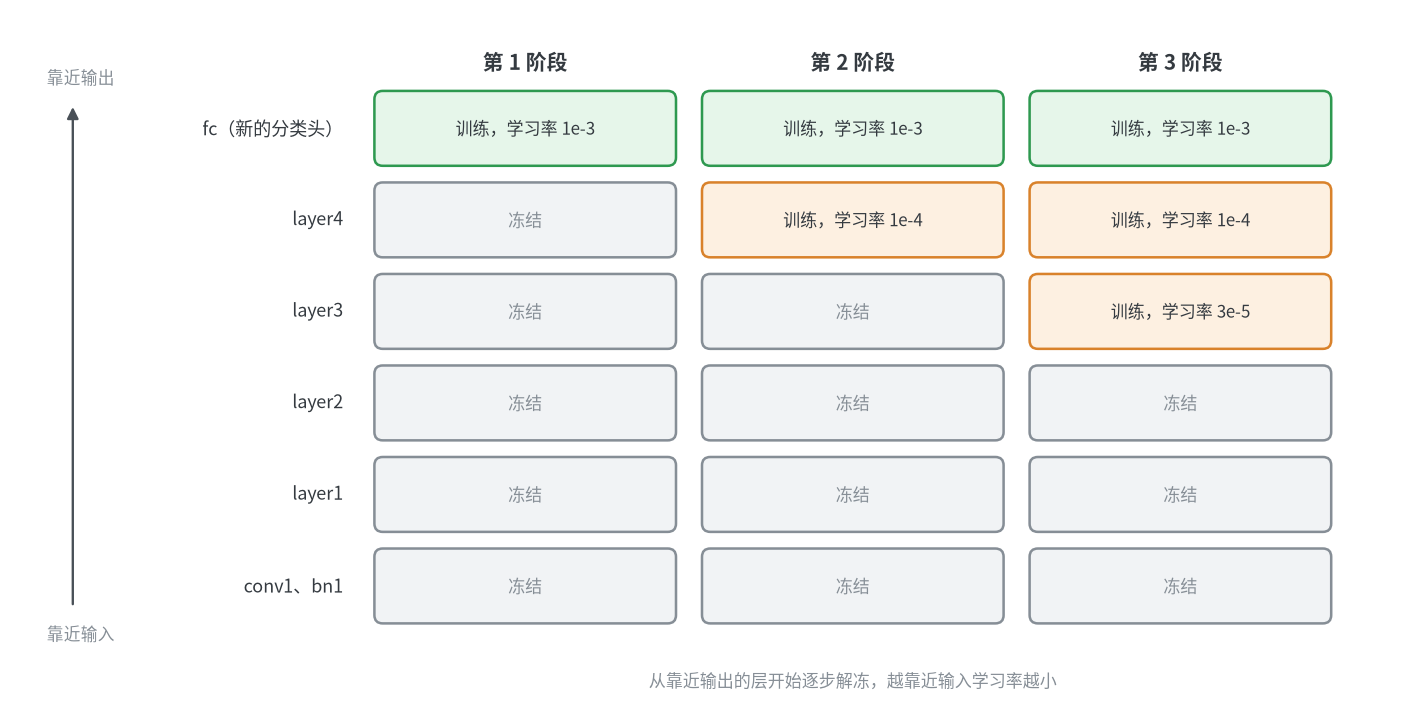
新的头刚开始是随机的,这时传回主干的梯度没有意义,直接整体训练可能破坏预训练的特征。逐步解冻先只训练头,等头基本收敛后再从靠近输出的层开始,一个阶段一个阶段地解冻
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import torch
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18


def trainable(model):
    return sum(p.numel() for p in model.parameters() if p.requires_grad)


model = resnet18(weights=ResNet18_Weights.DEFAULT)
model.requires_grad_(False)
model.fc = nn.Linear(model.fc.in_features, 10)
optimizer = torch.optim.AdamW(model.fc.parameters(), lr=1e-3)
print(trainable(model))  # 5130

# 按从后往前的顺序解冻,越早的层学习率越小
schedule = { 2: (model.layer4, 1e-4), 4: (model.layer3, 3e-5) }

for epoch in range(6):
    if epoch in schedule:
        module, lr = schedule[epoch]
        module.requires_grad_(True)
        optimizer.add_param_group({ "params": module.parameters(), "lr": lr })
        print(f"epoch {epoch}: 可训练参数 {trainable(model):,},参数组 {len(optimizer.param_groups)} 个")
    # 这里是一轮训练
1
2
3
5130
epoch 2: 可训练参数 8,398,858,参数组 2 个
epoch 4: 可训练参数 10,498,570,参数组 3 个
解冻要同时做两件事:把requires_grad改回True,并把参数加入优化器。只做前一件时,这些参数能算出梯度,但优化器不知道它们的存在,权重不会有任何变化,也不会有任何提示
加载部分权重
形状不一致
自己保存的检查点与当前模型不完全一致时(类别数变了、加了新的层),load_state_dict默认会报错。strict=False只能忽略名字对不上的张量,名字相同而形状不同时仍然报错,需要先把这些张量过滤掉
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import torch
from torchvision.models import ResNet18_Weights, resnet18

state = resnet18(weights=ResNet18_Weights.DEFAULT).state_dict()  # 相当于torch.load读入的检查点
model = resnet18(num_classes=10)                                 # 新模型只有10类

try:
    model.load_state_dict(state, strict=False)
except RuntimeError as e:
    print(e)

# 只保留名字相同并且形状也相同的张量
target = model.state_dict()
filtered = { k: v for k, v in state.items() if k in target and v.shape == target[k].shape }
print([k for k in state if k not in filtered])  # ['fc.weight', 'fc.bias']

result = model.load_state_dict(filtered, strict=False)
print(result.missing_keys)     # ['fc.weight', 'fc.bias']
print(result.unexpected_keys)  # []
print(len(filtered), len(target))  # 120 122
1
2
3
Error(s) in loading state_dict for ResNet:
	size mismatch for fc.weight: copying a param with shape torch.Size([1000, 512]) from checkpoint, the shape in current model is torch.Size([10, 512]).
	size mismatch for fc.bias: copying a param with shape torch.Size([1000]) from checkpoint, the shape in current model is torch.Size([10]).
load_state_dict的返回值包含两个列表
| 字段 | 含义 | 加载之后的状态 |
|---|---|---|
missing_keys | 模型中有、检查点中没有的张量 | 保持初始化时的值 |
unexpected_keys | 检查点中有、模型中没有的张量 | 被忽略 |
名字不一致
strict=False在名字完全对不上时也不会报错,结果是一个权重都没有加载。 把预训练的主干包在自己的模型里时,名字前面会多出一层前缀,很容易出现这种情况,所以用了strict=False就一定要检查返回值
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18


class Classifier(nn.Module):
    """自己的模型:主干来自ResNet18,去掉了原来的分类头"""

    def __init__(self, num_classes):
        super().__init__()
        self.backbone = resnet18()
        self.backbone.fc = nn.Identity()
        self.head = nn.Linear(512, num_classes)

    def forward(self, x):
        return self.head(self.backbone(x))


state = resnet18(weights=ResNet18_Weights.DEFAULT).state_dict()
model = Classifier(num_classes=10)

# 名字对不上:检查点里是conv1.weight,模型里是backbone.conv1.weight
result = model.load_state_dict(state, strict=False)
print(len(result.missing_keys), result.missing_keys[:3])
print(len(result.unexpected_keys), result.unexpected_keys[:3])

# 给名字加上前缀后再加载
renamed = { "backbone." + k: v for k, v in state.items() }
result = model.load_state_dict(renamed, strict=False)
print(result.missing_keys)     # ['head.weight', 'head.bias']
print(result.unexpected_keys)  # ['backbone.fc.weight', 'backbone.fc.bias']
1
2
3
4
102 ['backbone.conv1.weight', 'backbone.bn1.weight', 'backbone.bn1.bias']
122 ['conv1.weight', 'bn1.weight', 'bn1.bias']
['head.weight', 'head.bias']
['backbone.fc.weight', 'backbone.fc.bias']
- 第一次加载时模型的权重全部缺失,检查点的 122 个张量全部多余,模型仍然是随机初始化的
- 重命名后只剩下预期之内的差异:新的头没有权重,旧的分类头被丢弃
- 用
nn.DataParallel或DistributedDataParallel保存的检查点,名字前面带有module.前缀,同样需要先去掉 - 模型的
state_dict其实有 122 个张量,其中 20 个是 BatchNorm 的num_batches_tracked,它们缺失时不会列入missing_keys,所以只报告了 102 个
LoRA
原理
全量微调要更新并保存模型的全部参数,模型很大时代价很高。LoRA 的做法是冻结原来的权重$W_0$,在旁边加一条由两个小矩阵组成的支路,只训练这两个小矩阵
\[h = W_0 x + \frac{\alpha}{r} B A x ,\qquad W_0 \in \mathbb{R}^{d \times k} ,\quad B \in \mathbb{R}^{d \times r} ,\quad A \in \mathbb{R}^{r \times k}\]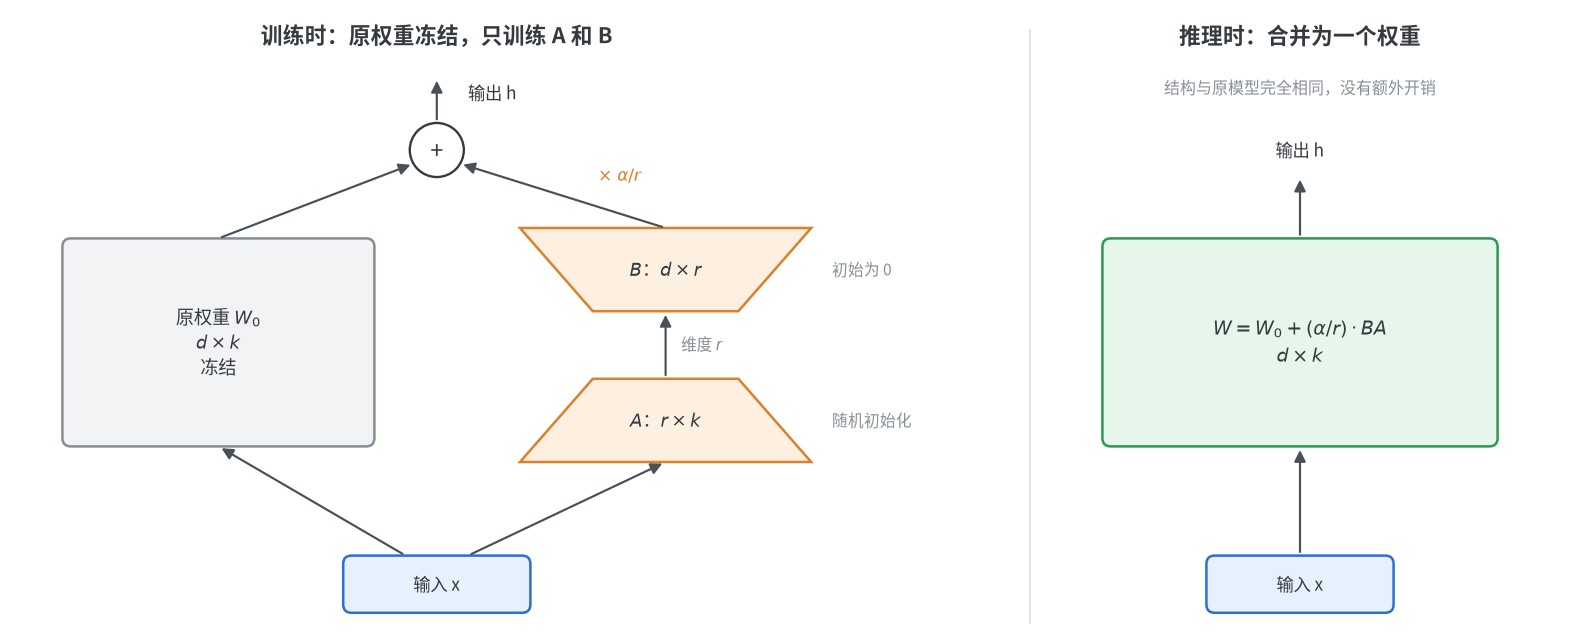
| 符号 | 含义 |
|---|---|
| $r$ | 秩,支路中间的维度,远小于$d$和$k$,常用 4 到 64 |
| $\alpha$ | 缩放系数,支路的输出乘以$\alpha / r$,常取$r$的一到两倍 |
| $A$ | 随机初始化 |
| $B$ | 初始为 0,保证训练开始时支路的输出为 0,模型与原来完全相同 |
一个线性层原来有$d \times k$个权重,LoRA 只训练$r \times (d + k)$个。以$768 \to 3072$的线性层为例,$r = 8$时从 2,359,296 个减少到 30,720 个
LoRA 通常加在 Transformer 的线性层上,这些线性层的位置见PyTorch Transformer。原始论文只加在注意力的$Q$和$V$上,现在更常见的是加在全部线性层上
实现
LoRALinear包住一个已有的nn.Linear,add_lora把模型中所有的nn.Linear替换掉。以下代码按顺序放在同一个文件中
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
import math
import os

import torch
from torch import nn


class LoRALinear(nn.Module):
    def __init__(self, base: nn.Linear, r=8, alpha=16):
        super().__init__()
        self.base = base
        self.base.requires_grad_(False)                # 原来的权重冻结
        self.scale = alpha / r
        self.lora_a = nn.Parameter(torch.empty(r, base.in_features))
        self.lora_b = nn.Parameter(torch.zeros(base.out_features, r))  # B初始为0,开始时输出与原模型相同
        nn.init.kaiming_uniform_(self.lora_a, a=math.sqrt(5))

    def forward(self, x):
        return self.base(x) + (x @ self.lora_a.T @ self.lora_b.T) * self.scale

    @torch.no_grad()
    def merge(self):
        """把低秩更新合并进原来的权重,返回一个普通的nn.Linear"""
        self.base.weight += (self.lora_b @ self.lora_a) * self.scale
        return self.base


def add_lora(model, r=8, alpha=16):
    """冻结整个模型,再把其中所有的nn.Linear替换为LoRALinear"""
    model.requires_grad_(False)
    for module in list(model.modules()):
        for name, child in module.named_children():
            if isinstance(child, nn.Linear):
                setattr(module, name, LoRALinear(child, r, alpha))
    return model


def merge_lora(model):
    for module in list(model.modules()):
        for name, child in module.named_children():
            if isinstance(child, LoRALinear):
                setattr(module, name, child.merge())
    return model


def count(model):
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    total = sum(p.numel() for p in model.parameters())
    return f"可训练 {trainable:,} / 全部 {total:,},占 {trainable / total:.2%}"


def make_model():
    # 4个前馈块,代替一个预训练好的模型
    return nn.Sequential(*[
        nn.Sequential(nn.Linear(768, 3072), nn.GELU(), nn.Linear(3072, 768)) for _ in range(4)
    ])


torch.manual_seed(0)
model = make_model()
x = torch.randn(2, 16, 768)
original = model(x)
print(count(model))   # 可训练 18,889,728 / 全部 18,889,728,占 100.00%

add_lora(model, r=8)
print(count(model))   # 可训练 245,760 / 全部 19,135,488,占 1.28%
print(torch.equal(model(x), original))  # True,B为0时输出与原模型完全相同
- 替换模块要用
setattr写回父模块,只修改循环变量不会改变模型 nn.MultiheadAttention内部的$Q$、$K$、$V$不是独立的nn.Linear,而是一个合在一起的in_proj_weight,上面的add_lora替换不到;它的out_proj会被替换,但前向传播时内部直接读取out_proj.weight,会报错'LoRALinear' object has no attribute 'weight'。要对注意力加 LoRA,需要使用以nn.Linear实现注意力的模型- 新任务的输出层仍然需要整体训练,替换输出层要放在
add_lora之后,或者之后单独解冻
保存与合并
训练之后只需要保存名字中带lora_的张量。部署时把$\frac{\alpha}{r} BA$加到$W_0$上,模型变回普通的线性层,推理速度与原模型相同
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
# 模拟训练:只有lora_a和lora_b会被更新
optimizer = torch.optim.AdamW([p for p in model.parameters() if p.requires_grad], lr=1e-3)
for _ in range(20):
    loss = (model(x) - 1).pow(2).mean()
    optimizer.zero_grad()
    loss.backward()
    optimizer.step()

# 只保存适配器
adapter = { k: v for k, v in model.state_dict().items() if "lora_" in k }
torch.save(adapter, "adapter.pt")
torch.save(model.state_dict(), "full.pt")
print(len(adapter), f"{os.path.getsize('adapter.pt') / 1e6:.1f} MB", f"{os.path.getsize('full.pt') / 1e6:.1f} MB")

# 合并后变回普通的nn.Linear,输出不变
with torch.no_grad():
    before = model(x)
    merge_lora(model)
    after = model(x)
print(model[0][0])                               # Linear(in_features=768, out_features=3072, bias=True)
print(torch.allclose(before, after, atol=1e-5))  # True
print((before - after).abs().max().item())
print((before - original).abs().max().item())    # 与训练前的输出已经不同

# 加载:在原模型上重新插入LoRA,再读入适配器
torch.manual_seed(0)
restored = add_lora(make_model(), r=8)
result = restored.load_state_dict(torch.load("adapter.pt"), strict=False)
print(len(result.missing_keys), result.unexpected_keys)  # 缺少的全部是原模型的权重
with torch.no_grad():
    print(torch.allclose(restored(x), before, atol=1e-5))  # True
1
2
3
4
5
6
7
16 1.0 MB 76.6 MB
Linear(in_features=768, out_features=3072, bias=True)
True
4.172325134277344e-07
1.2655998468399048
16 []
True
- 适配器文件只有 1.0 MB,完整模型为 76.6 MB。同一个原模型可以搭配多个适配器,每个任务只多存一个小文件
- 合并前后的输出最大相差约 4e-7,属于浮点数的舍入误差;而与训练前的输出相差 1.27,说明合并的确实是训练得到的更新
- 合并之后无法再分离出适配器,需要继续训练或切换任务时保留未合并的版本
- 实际项目中可以直接使用
peft库,它对常见模型的各种线性层、卷积层都做了适配,原理与这里相同
对比实验
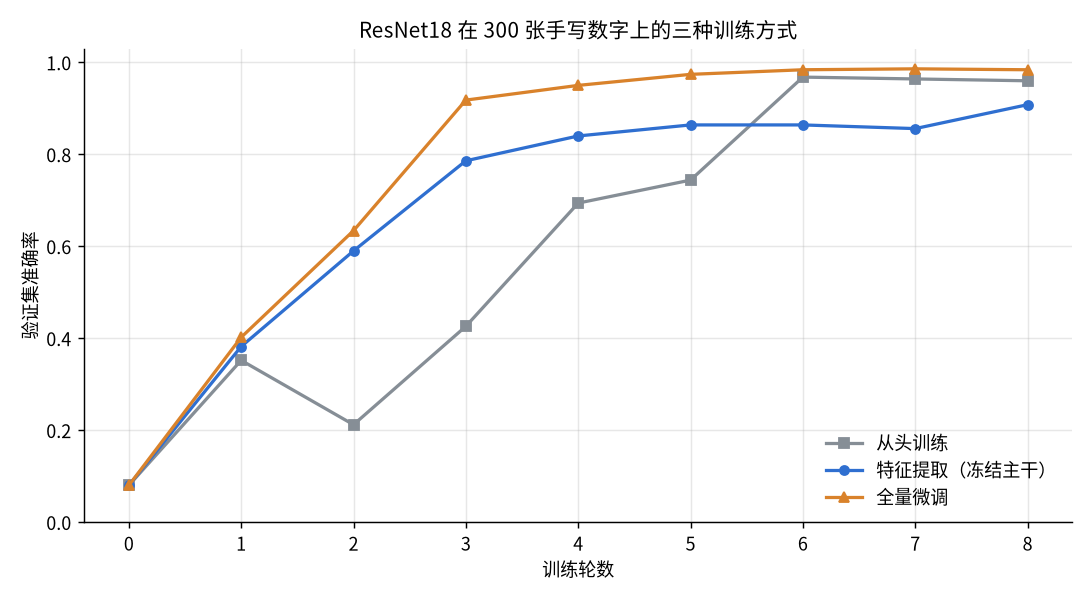
用一个小实验比较从头训练、特征提取和全量微调。数据是sklearn自带的 8×8 手写数字,放大到 224×224 并复制为 3 通道,只取 300 张训练、500 张验证;模型是 ResNet18,三种做法各训练 8 轮。实验在一台 CPU 为 Intel Core Ultra 9 285K、GPU 为 GeForce RTX 5090 D(32 GB 显存)、内存 64 GB 的机器上用 GPU 运行
| 做法 | 初始权重 | 训练的参数 | 学习率 |
|---|---|---|---|
| 从头训练 | 随机 | 全部 | 1e-3 |
| 特征提取 | ImageNet | 只有分类头,主干保持eval() | 1e-2 |
| 全量微调 | ImageNet | 全部 | 主干 1e-4,分类头 1e-3 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
import json
import time

import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn
from torchvision.models import ResNet18_Weights, resnet18

torch.manual_seed(0)
device = "cuda" if torch.cuda.is_available() else "cpu"

# 8×8的手写数字,共1797张。只取300张训练,500张验证
digits = load_digits()
images = torch.tensor(digits.images, dtype=torch.float32) / 16  # (1797, 8, 8),取值范围[0, 1]
labels = torch.tensor(digits.target)
images, labels = images.to(device), labels.to(device)
order = torch.randperm(len(images)).to(device)
train_idx, val_idx = order[:300], order[300:800]

mean = torch.tensor([0.485, 0.456, 0.406], device=device).view(1, 3, 1, 1)
std = torch.tensor([0.229, 0.224, 0.225], device=device).view(1, 3, 1, 1)


def prepare(x):
    """(N, 8, 8) -> (N, 3, 224, 224):放大、复制为3通道,并按ImageNet的均值和标准差归一化"""
    x = F.interpolate(x.unsqueeze(1), size=224, mode="bilinear", align_corners=False)
    return (x.expand(-1, 3, -1, -1) - mean) / std


def build(strategy):
    pretrained = strategy != "scratch"
    model = resnet18(weights=ResNet18_Weights.DEFAULT if pretrained else None)
    model.fc = nn.Linear(model.fc.in_features, 10)
    model.to(device)

    if strategy == "scratch":      # 从头训练:随机初始化,全部参数一起训练
        groups = [{"params": model.parameters(), "lr": 1e-3}]
    elif strategy == "frozen":     # 特征提取:冻结主干,只训练分类头
        model.requires_grad_(False)
        model.fc.requires_grad_(True)
        groups = [{"params": model.fc.parameters(), "lr": 1e-2}]
    else:                          # 全量微调:主干用较小的学习率
        backbone = [p for name, p in model.named_parameters() if not name.startswith("fc.")]
        groups = [{"params": backbone, "lr": 1e-4}, {"params": model.fc.parameters(), "lr": 1e-3}]
    return model, torch.optim.Adam(groups)


@torch.no_grad()
def evaluate(model):
    model.eval()
    correct = 0
    for i in range(0, len(val_idx), 100):
        idx = val_idx[i:i + 100]
        correct += (model(prepare(images[idx])).argmax(dim=1) == labels[idx]).sum().item()
    return correct / len(val_idx)


def run(strategy, epochs=8, batch_size=32):
    torch.manual_seed(0)
    model, optimizer = build(strategy)
    history = [evaluate(model)]    # 训练前的准确率
    start = time.perf_counter()
    for epoch in range(epochs):
        model.train()
        if strategy == "frozen":
            model.eval()           # 主干被冻结,BatchNorm保持推理模式
        perm = train_idx[torch.randperm(len(train_idx)).to(device)]
        for i in range(0, len(perm), batch_size):
            idx = perm[i:i + batch_size]
            loss = F.cross_entropy(model(prepare(images[idx])), labels[idx])
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
        history.append(evaluate(model))
    seconds = time.perf_counter() - start
    trainable = sum(p.numel() for p in model.parameters() if p.requires_grad)
    print(f"{strategy:8s} 可训练参数 {trainable:>10,}  最终 {history[-1]:.3f}  最高 {max(history):.3f}  耗时 {seconds:.0f} 秒")
    return history


print(f"设备 {device}")
results = { name: run(name) for name in ["scratch", "frozen", "finetune"] }
for name, history in results.items():
    print(name, [round(a, 3) for a in history])
json.dump(results, open("curves.json", "w"))
1
2
3
4
5
6
7
设备 cuda
scratch  可训练参数 11,181,642  最终 0.960  最高 0.968  耗时 1 秒
frozen   可训练参数      5,130  最终 0.908  最高 0.908  耗时 1 秒
finetune 可训练参数 11,181,642  最终 0.984  最高 0.986  耗时 1 秒
scratch [0.08, 0.352, 0.212, 0.426, 0.694, 0.744, 0.968, 0.964, 0.96]
frozen [0.08, 0.382, 0.59, 0.786, 0.84, 0.864, 0.864, 0.856, 0.908]
finetune [0.08, 0.402, 0.634, 0.918, 0.95, 0.974, 0.984, 0.986, 0.984]
| 做法 | 可训练参数 | 最终准确率 | 观察 |
|---|---|---|---|
| 从头训练 | 11,181,642 | 0.960 | 前几轮上升慢,曲线有明显的回落 |
| 特征提取 | 5,130 | 0.908 | 开始上升快,之后停在 0.86 附近 |
| 全量微调 | 11,181,642 | 0.984 | 上升最快、最终最高,曲线最平稳 |
- 全量微调的效果最好,第 3 轮就达到 0.918,第 5 轮之后一直在 0.97 以上
- 特征提取只训练了 5,130 个参数就达到 0.908,但上限最低:ImageNet 是自然图像,主干提取的特征并不完全适合放大后的手写数字,而主干又不能调整
- 从头训练在这个数据集上也能达到 0.96,因为手写数字本身很简单,300 张已经够学。差距主要体现在收敛速度和稳定性上;任务越难、数据越少,从头训练与微调的差距越大
- 训练主干的两种做法在 GPU 上每次运行的结果略有不同,另外两次运行中从头训练为 0.932 和 0.964、全量微调都是 0.986,结论不变。特征提取的结果每次相同
- 代码没有 GPU 时自动在 CPU 上运行。同一台机器只用 CPU、8 个线程时,三种做法分别耗时约 101、42、61 秒,结果为从头训练 0.950、特征提取 0.908、全量微调 0.994。只想快速试一遍时可以把
prepare中的size改小 - 主干冻结时可以更进一步:先用主干把所有图像的特征算出来保存,之后只在特征上训练分类头,每一轮都不需要再经过主干
常见问题
前五项都不会报错,只是结果变差,最容易被忽略。表中的数值来自上一节的实验设置
| 现象 | 原因 | 处理 |
|---|---|---|
| 微调的前几轮准确率停在随机水平,最终不如正常微调 | 学习率过大,预训练的特征被破坏。全部参数用 1e-2 时,前 2 轮不超过 0.11,之后波动很大,最终 0.888,正常为 0.984 | 主干使用头的十分之一到百分之一的学习率,或先冻结主干训练头 |
| 验证或部署时准确率远低于预期 | 预处理与预训练时不一致。同一个模型去掉归一化后从 0.908 降到 0.318,输入范围用 0 到 255 时降到 0.108 | 使用weights.transforms(),或保持相同的均值、标准差和取值范围 |
| 冻结了主干,收敛却很慢、曲线波动大 | BatchNorm 处于训练模式,运行统计量被新数据改写。第 1 轮后只有 0.096,正常为 0.382 | 冻结的部分保持eval() |
| 解冻之后指标没有任何变化 | 解冻的参数没有加入优化器,有梯度但不更新 | optimizer.add_param_group |
| 加载权重后效果与随机初始化一样 | strict=False时名字对不上,一个张量都没有加载 | 检查missing_keys和unexpected_keys,重命名后再加载 |
报错size mismatch | 名字相同但形状不同,strict=False不处理这种情况 | 加载前过滤掉形状不一致的张量 |
报错optimizer got an empty parameter list | 替换分类头之后又冻结了整个模型,没有可训练的参数 | 先冻结再替换,或单独解冻分类头 |
报错element 0 of tensors does not require grad | 同上,损失与任何可训练的参数都没有关系 | 同上 |
| 数据很少时全量微调过拟合 | 可训练的参数远多于数据量 | 冻结靠前的层、减小学习率、加强数据增强,或改用特征提取 |
最后一项没有在这里的实验中出现,是通用的经验