PyTorch Data Loading
整理 PyTorch 的数据加载与数据增强,包括 Dataset、DataLoader、变长样本的整理以及训练与验证时的图像变换
深度学习系列:第 4 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
训练的第一步是把数据组织成一个个批次送进模型。这里整理数据集、数据加载器和数据增强的写法,训练循环本身见PyTorch Training
数据加载
Dataset负责取出单个样本,DataLoader负责把样本打乱、组成批次、用多个进程并行加载
Dataset
自定义数据集需要实现__len__和__getitem__两个方法。下面用 scikit-learn 自带的手写数字数据集作为例子,PyTorch Training中的训练也使用它
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
import torch
from sklearn.datasets import load_digits
from torch.utils.data import DataLoader, Dataset, Subset

class DigitsDataset(Dataset):
    """8x8的手写数字灰度图,共1797张、10个类别"""

    def __init__(self, transform=None):
        digits = load_digits()
        self.images = torch.from_numpy(digits.images).float().unsqueeze(1) / 16  # (1797, 1, 8, 8),取值0到1
        self.labels = torch.from_numpy(digits.target).long()                     # (1797,)
        self.transform = transform

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, index):
        image, label = self.images[index], self.labels[index]
        if self.transform is not None:
            image = self.transform(image)
        return image, label

dataset = DigitsDataset()
print(len(dataset))  # 1797
image, label = dataset[0]
print(image.shape, image.dtype, label)  # torch.Size([1, 8, 8]) torch.float32 tensor(0)

# 划分训练集和验证集:打乱下标后切开,固定随机种子使每次划分相同
indices = torch.randperm(len(dataset), generator=torch.Generator().manual_seed(0)).tolist()
train_set = Subset(DigitsDataset(), indices[:1437])  # 需要数据增强时在这里传入训练用的transform
val_set = Subset(DigitsDataset(), indices[1437:])
print(len(train_set), len(val_set))  # 1437 360

train_loader = DataLoader(train_set, batch_size=64, shuffle=True, drop_last=True)
val_loader = DataLoader(val_set, batch_size=256)
print(len(train_loader), len(val_loader))  # 22 2

images, labels = next(iter(train_loader))
print(images.shape, labels.shape)  # torch.Size([64, 1, 8, 8]) torch.Size([64])
print([len(labels) for _, labels in val_loader])  # [256, 104]
- 划分时固定随机种子,否则每次运行验证集都不同,中断后恢复训练时还会把之前的训练样本混进验证集
len(loader)是批次数而不是样本数:训练集 1437 个样本、批大小 64、丢弃最后不满的一批,得到 22 个批次- 数据量很大时不要在
__init__中把全部数据读入内存,只保存文件路径,在__getitem__中读取
random_split划分出的子集共用同一个底层数据集。 修改其中一个子集的transform,另一个也会跟着变,验证集就被加上了训练用的数据增强。所以上面为训练集和验证集各创建了一个数据集对象,再用Subset按下标取出各自的部分
1
2
3
4
5
6
7
8
9
10
import torch
from torch.utils.data import random_split

dataset = DigitsDataset()
train_set, val_set = random_split(dataset, [0.8, 0.2], generator=torch.Generator().manual_seed(0))
print(len(train_set), len(val_set))          # 1438 359
print(train_set.dataset is val_set.dataset)  # True,两个子集指向同一个数据集

train_set.dataset.transform = lambda image: image * 0  # 本意是只给训练集加变换
print(val_set[0][0].max())                   # tensor(0.),验证集也被改了
DataLoader
1
2
DataLoader(dataset, batch_size=1, shuffle=False, num_workers=0, collate_fn=None,
           pin_memory=False, drop_last=False, persistent_workers=False)
| 参数 | 默认值 | 作用 |
|---|---|---|
batch_size | 1 | 每个批次的样本数 |
shuffle | False | 每一轮开始时重新打乱顺序。训练集设为True,验证集不需要 |
num_workers | 0 | 加载数据的工作进程数,0 表示在主进程中加载。读取文件或数据增强较慢时,设为不超过 CPU 核数的正数 |
pin_memory | False | 把取出的批次放入锁页内存,加快向 GPU 的拷贝,使用 GPU 训练时设为True,并配合.to(device, non_blocking=True) |
drop_last | False | 丢弃最后一个不满的批次。训练集可以设为True,避免很小的批次使 BatchNorm 的统计量不稳定;验证集必须为False |
persistent_workers | False | 每一轮结束后保留工作进程,省去每轮重新创建进程的时间 |
collate_fn | None | 把多个样本合并成一个批次的函数,默认把各个样本堆叠成一个张量 |
num_workers大于 0 时,Windows 和 macOS 上创建DataLoader并迭代的代码必须放在if __name__ == "__main__":之下,否则工作进程启动时会重复执行整个脚本
变长样本
默认的合并方式要求每个样本的形状相同。句子、音频这类长度不一的样本需要自己写collate_fn,把一个批次内的样本补齐到相同长度
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import torch
from torch.nn.utils.rnn import pad_sequence
from torch.utils.data import DataLoader

# 4个长度不同的样本,每个样本是(序列,标签)
samples = [(torch.tensor([5, 8, 2]), 0), (torch.tensor([7, 3]), 1),
           (torch.tensor([4, 9, 6, 1, 2]), 0), (torch.tensor([3]), 1)]

def collate(batch):
    sequences, labels = zip(*batch)
    lengths = torch.tensor([len(s) for s in sequences])
    tokens = pad_sequence(sequences, batch_first=True, padding_value=0)  # 按批次内最长的序列补齐
    return tokens, lengths, torch.tensor(labels)

loader = DataLoader(samples, batch_size=2, collate_fn=collate)
for tokens, lengths, labels in loader:
    print(tokens, lengths, labels)

try:
    next(iter(DataLoader(samples, batch_size=2)))  # 不指定collate_fn
except RuntimeError as error:
    print(error)
1
2
3
4
5
tensor([[5, 8, 2],
        [7, 3, 0]]) tensor([3, 2]) tensor([0, 1])
tensor([[4, 9, 6, 1, 2],
        [3, 0, 0, 0, 0]]) tensor([5, 1]) tensor([0, 1])
stack expects each tensor to be equal size, but got [3] at entry 0 and [2] at entry 1
每个批次只补齐到该批次内最长的长度,不同批次的长度可以不同。补上的位置没有实际含义,需要把长度或掩码一起返回,模型中用填充掩码屏蔽这些位置,损失中用ignore_index忽略它们
数据增强
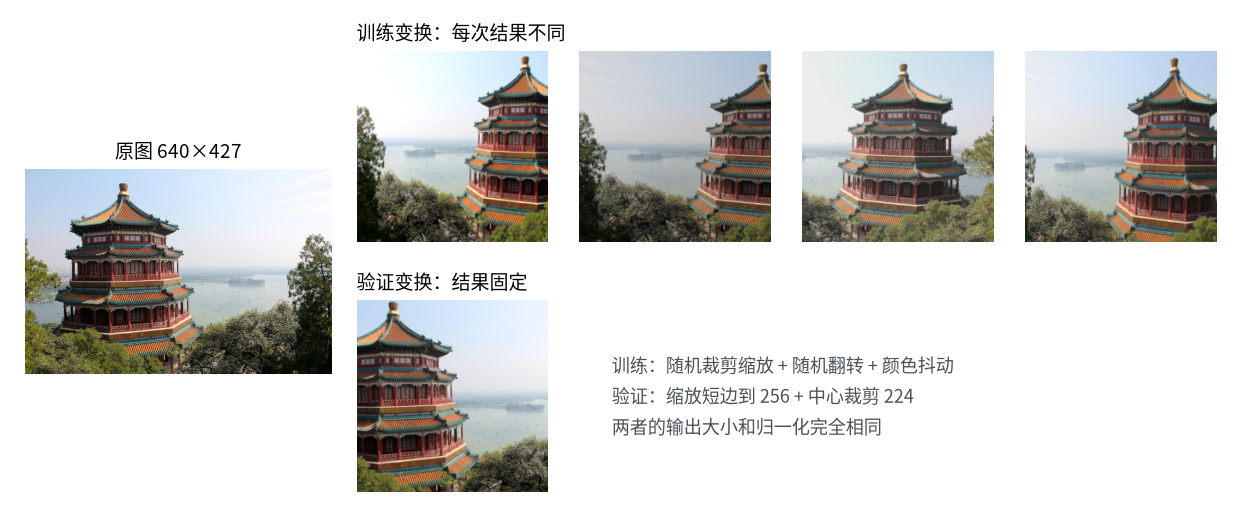
数据增强在每次取样本时对图像做随机变换,使模型每一轮看到的都是略有不同的图像,以减轻过拟合。torchvision.transforms.v2是目前推荐使用的接口
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
import torch
from PIL import Image
from sklearn.datasets import load_sample_image
from torchvision.transforms import v2

mean, std = [0.485, 0.456, 0.406], [0.229, 0.224, 0.225]  # ImageNet的统计量

train_transform = v2.Compose([
    v2.ToImage(),                                   # numpy数组或PIL图像 -> (C, H, W)的uint8张量
    v2.RandomResizedCrop(224, scale=(0.5, 1.0)),    # 随机裁剪一块再缩放到224
    v2.RandomHorizontalFlip(p=0.5),
    v2.ColorJitter(brightness=0.2, contrast=0.2, saturation=0.2),
    v2.ToDtype(torch.float32, scale=True),          # uint8的0到255 -> float32的0到1
    v2.Normalize(mean, std),
])

eval_transform = v2.Compose([
    v2.ToImage(),
    v2.Resize(256),                                 # 短边缩放到256
    v2.CenterCrop(224),
    v2.ToDtype(torch.float32, scale=True),
    v2.Normalize(mean, std),                        # 与训练时相同
])

image = Image.fromarray(load_sample_image("china.jpg"))
print(image.size)                                   # (640, 427),scikit-learn自带的示例图片

torch.manual_seed(0)
a, b = train_transform(image), train_transform(image)
print(a.shape, a.dtype)                             # torch.Size([3, 224, 224]) torch.float32
print(torch.equal(a, b))                            # False,训练变换每次的结果都不同
print(torch.equal(eval_transform(image), eval_transform(image)))  # True,验证变换的结果固定

# scale=True不能省略
x = v2.ToImage()(image)
print(v2.ToDtype(torch.float32, scale=True)(x).max())  # tensor(1.)
print(v2.ToDtype(torch.float32)(x).max())              # tensor(255.)
| 变换 | 作用 |
|---|---|
v2.ToImage() | 把 PIL 图像或 numpy 数组转为 (C, H, W) 的张量,不改变数值 |
v2.RandomResizedCrop(size) | 随机裁剪一块区域并缩放到指定大小 |
v2.RandomHorizontalFlip(p) | 以概率p水平翻转 |
v2.ColorJitter(...) | 随机改变亮度、对比度、饱和度 |
v2.Resize(size)、v2.CenterCrop(size) | 缩放、中心裁剪,没有随机性 |
v2.ToDtype(torch.float32, scale=True) | 转为浮点数并缩放到 0 到 1 |
v2.Normalize(mean, std) | 每个通道减去均值、除以标准差 |
- 随机的变换只用于训练。验证和推理要使用固定的变换,否则同一个模型每次评估的结果都不一样
v2.ToDtype的scale=True不能省略,否则只转换类型,数值仍是 0 到 255,之后的Normalize就全错了- 旧代码中的
ToTensor()相当于ToImage()加ToDtype(torch.float32, scale=True),在 v2 中已不推荐使用 - 翻转并不总是合适:数字、文字翻转后含义会变,检测和分割任务中标注框、掩码要随图像一起变换
验证和推理时的归一化必须与训练时完全相同。 均值和标准差只用训练集统计,然后原样用于验证集、测试集和部署后的推理。使用预训练模型时,要用该模型训练时的统计量,而不是自己数据集的统计量。归一化不一致不会报错,只会让准确率大幅下降,下文的训练中有统计的方法和实际的对比