Optimizers and Learning Rate Schedules
整理优化器与学习率调度的原理,包括 SGD、动量、RMSprop、Adam、AdamW 的更新公式及其与 PyTorch 实现的逐步对照,预热、余弦退火等调度的公式,以及学习率与批大小的关系
深度学习系列:第 6 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
PyTorch Training整理了优化器和学习率调度器的用法,Normalization and Regularization把权重衰减作为正则化方法介绍过。这里整理它们背后的公式:每种优化器一步到底做了什么、各个超参数的含义、调度器的学习率是怎样算出来的。每个公式都用几行代码手写一遍,并与torch.optim的结果对照
梯度下降与动量
更新公式
记参数为$w$,学习率为$\eta$,第$t$步在一个批次上算出的梯度为$g_t$。SGD 沿梯度的反方向走一步
\[w_{t+1} = w_t - \eta g_t\]动量为梯度维护一个累积量$b$,用累积量代替梯度来更新,$\mu$为动量系数
\[b_t = \mu b_{t-1} + g_t ,\qquad w_{t+1} = w_t - \eta b_t\]Nesterov 动量使用同一个累积量,更新时把$b$换成$g + \mu b$,相当于在累积量的基础上再向前看一步
| 项目 | 说明 |
|---|---|
| 累积量 | 过去梯度的加权和,越早的梯度权重越小,每过一步乘以$\mu$ |
| 等效步长 | 梯度方向不变时累积量趋近于$g / (1 - \mu)$,momentum=0.9相当于把学习率放大 10 倍 |
| 方向相反 | 相邻两步的梯度方向相反时在累积量中互相抵消,来回振荡的分量被削弱 |
| 权重衰减 | SGD的weight_decay是 L2 正则,先把$\lambda w$加到梯度上,再进入累积量 |
以上是torch.optim.SGD的写法。教科书中常见的是另一种写法,把学习率乘进累积量
学习率不变时两者完全相同,$v$就是$\eta b$。学习率中途改变时,PyTorch 的写法让新的学习率立刻作用于整个累积量,教科书的写法中已经累积的部分仍然带着旧的学习率
与 torch.optim.SGD 对照
在一个最小二乘问题上,手写的更新与torch.optim.SGD各走 20 步,比较最后的参数。为了排除舍入误差,使用 64 位浮点数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
import torch

torch.set_default_dtype(torch.float64)
torch.manual_seed(0)
A, b, w0 = torch.randn(20, 5), torch.randn(20), torch.randn(5)


def grad_fn(w):
    """最小二乘损失 mean((Aw - b)^2) 对w的梯度"""
    return 2 * A.T @ (A @ w - b) / len(b)


def manual_sgd(lrs, momentum=0.0, nesterov=False, weight_decay=0.0, textbook=False):
    w, buf = w0.clone(), torch.zeros(5)
    for lr in lrs:
        g = grad_fn(w) + weight_decay * w            # L2正则:衰减项加在梯度上
        if textbook:                                 # 教科书写法:学习率乘进缓冲
            buf = momentum * buf + lr * g
            w = w - buf
            continue
        buf = momentum * buf + g                     # PyTorch写法:缓冲只累积梯度
        w = w - lr * (g + momentum * buf if nesterov else buf)
    return w


def torch_sgd(lrs, **kwargs):
    w = torch.nn.Parameter(w0.clone())
    optimizer = torch.optim.SGD([w], lr=lrs[0], **kwargs)
    for lr in lrs:
        optimizer.param_groups[0]["lr"] = lr
        loss = (A @ w - b).pow(2).mean()
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    return w.detach()


constant = [0.05] * 20
for name, kwargs in [("SGD", {}), ("动量", {"momentum": 0.9}), ("Nesterov", {"momentum": 0.9, "nesterov": True}),
                     ("动量加权重衰减", {"momentum": 0.9, "weight_decay": 0.01})]:
    diff = (manual_sgd(constant, **kwargs) - torch_sgd(constant, **kwargs)).abs().max().item()
    print(f"{name:10s} 最大差值 {diff:.1e}")

# 教科书写法:学习率不变时与PyTorch相同,学习率中途改变后不再相同
decayed = [0.05] * 10 + [0.005] * 10
for name, lrs in [("学习率不变", constant), ("第 10 步后降为 1/10", decayed)]:
    diff = (manual_sgd(lrs, momentum=0.9, textbook=True) - torch_sgd(lrs, momentum=0.9)).abs().max().item()
    print(f"教科书写法,{name}:最大差值 {diff:.1e}")
1
2
3
4
5
6
SGD        最大差值 1.1e-16
动量         最大差值 2.2e-16
Nesterov   最大差值 1.1e-16
动量加权重衰减    最大差值 3.3e-16
教科书写法,学习率不变:最大差值 2.2e-16
教科书写法,第 10 步后降为 1/10:最大差值 1.2e+00
- 四种设置下的差值都在 1e-16 的量级,即 64 位浮点数的舍入误差,公式与实现一致
- 学习率在第 10 步降为十分之一之后,教科书写法与 PyTorch 的结果相差 1.2。照着论文复现、或在不同框架之间迁移带动量的训练配置时,需要确认用的是哪一种写法
病态二次函数上的轨迹
动量的作用在各方向曲率相差很大的损失上最明显。取二次函数$f(x, y) = \frac{1}{2}(x^2 + 50 y^2)$,$y$方向的曲率是$x$方向的 50 倍,这个比值称为条件数$\kappa$。记最大、最小曲率为$L$和$m$,二次函数上的结论如下
| 方法 | 稳定的条件 | 最优设置下每步误差缩小的比例 |
|---|---|---|
| SGD | $\eta < 2 / L$ | $(\kappa - 1) / (\kappa + 1)$ |
| 动量 | $\eta < 2(1 + \mu) / L$ | $(\sqrt{\kappa} - 1) / (\sqrt{\kappa} + 1)$ |
学习率受曲率最大的方向限制,而在曲率小的方向上,这个学习率又太小,条件数越大收敛越慢。动量把条件数的影响从$\kappa$降到$\sqrt{\kappa}$。下面的 SGD 和动量都使用二次函数上理论最优的设置,实际的网络无法事先知道曲率,momentum=0.9是经验值
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
import math

import torch

L, m = 50.0, 1.0                     # 两个方向的曲率,条件数为50
curvature = torch.tensor([m, L])
kappa = L / m


def loss_fn(p):
    return 0.5 * (curvature * p ** 2).sum()


def run(make_optimizer, steps=150):
    p = torch.nn.Parameter(torch.tensor([-8.0, 1.5]))
    optimizer = make_optimizer([p])
    path, losses = [p.detach().clone()], [loss_fn(p).item()]
    for _ in range(steps):
        optimizer.zero_grad()
        loss_fn(p).backward()
        optimizer.step()
        path.append(p.detach().clone())
        losses.append(loss_fn(p).item())
    return torch.stack(path), losses


lr_gd = 2 / (L + m)                  # 二次函数上两种方法各自最优的设置
lr_mom = 4 / (math.sqrt(L) + math.sqrt(m)) ** 2
mu = ((math.sqrt(kappa) - 1) / (math.sqrt(kappa) + 1)) ** 2

configs = {
    "SGD": lambda params: torch.optim.SGD(params, lr=lr_gd),
    "动量": lambda params: torch.optim.SGD(params, lr=lr_mom, momentum=mu),
    "Adam": lambda params: torch.optim.Adam(params, lr=0.3),
}
paths = {}
for name, make in configs.items():
    paths[name], losses = run(make)
    reach = next((i for i, v in enumerate(losses) if v < 1e-6), None)
    print(f"{name:5s} 第 10 步 {losses[10]:.2e}  第 50 步 {losses[50]:.2e}  第 150 步 {losses[150]:.2e}  损失低于 1e-6:{reach}")

print(f"SGD lr={lr_gd:.4f},动量 lr={lr_mom:.4f} momentum={mu:.3f}")
print(f"理论上每步误差的缩小比例:SGD {(kappa - 1) / (kappa + 1):.3f},动量 {math.sqrt(mu):.3f}")
1
2
3
4
5
SGD   第 10 步 3.96e+01  第 50 步 1.62e+00  第 150 步 5.41e-04  损失低于 1e-6:None
动量    第 10 步 6.62e+01  第 50 步 1.92e-07  第 150 步 3.15e-31  损失低于 1e-6:47
Adam  第 10 步 2.21e+01  第 50 步 3.48e-01  第 150 步 7.01e-06  损失低于 1e-6:None
SGD lr=0.0392,动量 lr=0.0614 momentum=0.566
理论上每步误差的缩小比例:SGD 0.961,动量 0.752
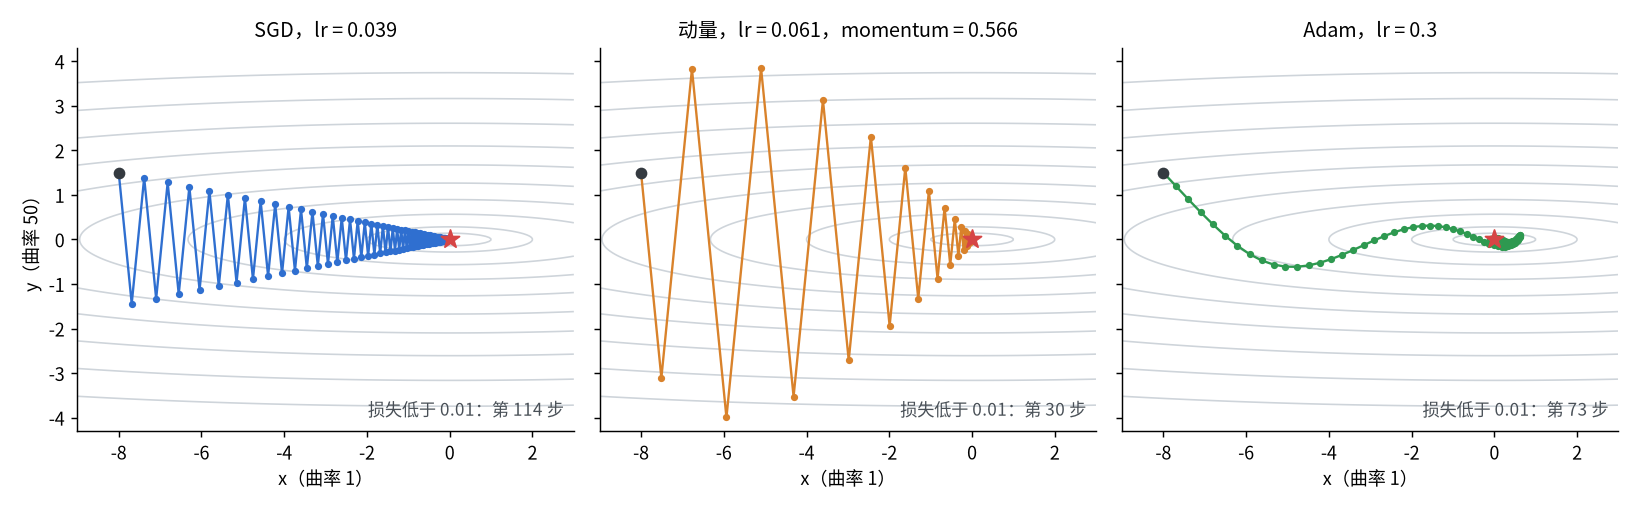
- SGD 在$y$方向来回振荡,在$x$方向每步只前进 4%,150 步之后损失为 5.4e-4
- 动量在陡峭的方向上振荡的幅度更大,但两个方向都按 0.752 的比例收缩,第 47 步损失就低于 1e-6
- Adam 的两个坐标各自按梯度的历史幅度归一化,开始时两个方向每步都走大约一个学习率,轨迹不受曲率差异的影响。但固定学习率的 Adam 接近最优点后步长不会自动变小,在这里绕了一圈才收敛,150 步之后为 7.0e-6,需要配合学习率衰减
自适应学习率
RMSprop 与 Adam
自适应方法为每个参数单独调整步长:梯度一直很大的参数步长变小,梯度一直很小的参数步长变大。RMSprop 维护梯度平方的指数滑动平均$v$,更新时把梯度除以它的平方根
\[v_t = \alpha v_{t-1} + (1 - \alpha) g_t^2 ,\qquad w_{t+1} = w_t - \eta \frac{g_t}{\sqrt{v_t} + \epsilon}\]Adam 在此基础上对梯度本身也做滑动平均,相当于 RMSprop 加动量,再加上偏差修正
\[m_t = \beta_1 m_{t-1} + (1 - \beta_1) g_t ,\qquad v_t = \beta_2 v_{t-1} + (1 - \beta_2) g_t^2\] \[\hat{m}_t = \frac{m_t}{1 - \beta_1^t} ,\qquad \hat{v}_t = \frac{v_t}{1 - \beta_2^t} ,\qquad w_{t+1} = w_t - \eta \frac{\hat{m}_t}{\sqrt{\hat{v}_t} + \epsilon}\]| 参数 | 默认值 | 含义 |
|---|---|---|
betas[0] | 0.9 | 一阶矩(梯度的平均)的衰减系数,大约平均最近 10 步 |
betas[1] | 0.999 | 二阶矩(梯度平方的平均)的衰减系数,大约平均最近 1000 步 |
eps | 1e-8 | 防止除以 0。梯度的幅度接近或小于它时,步长会被压小 |
lr | 1e-3 | 每一步的更新量大致不超过它,见下一节 |
alpha | 0.99 | RMSprop 中梯度平方的衰减系数 |
- 更新量是$\hat{m} / \sqrt{\hat{v}}$,分子分母都与梯度成正比。把损失乘以一个常数,SGD 的步长跟着变,Adam 的更新不变。这个比值衡量的是梯度的一致程度:最近的梯度方向一致时接近 1,正负相抵时接近 0。因此 Adam 的学习率可以直接理解为每个参数每一步最多移动多少
偏差修正与前几步的步长
$m$和$v$都从 0 开始,前若干步的滑动平均偏小。梯度恒为$g$时,$t$步之后的$m$等于$g$乘以$1 - \beta^t$,除以这个系数正好还原出$g$,$v$同理。下面用torch.optim.Adam记录每一步参数的变化量与学习率之比
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
import torch

lr, beta1, beta2 = 1e-3, 0.9, 0.999


def step_sizes(gradients):
    """用torch.optim.Adam走若干步,返回每一步 |Δw| / lr 在所有参数上的平均值"""
    w = torch.nn.Parameter(torch.zeros_like(gradients[0]))
    optimizer = torch.optim.Adam([w], lr=lr, betas=(beta1, beta2))
    sizes = []
    for g in gradients:
        before = w.detach().clone()
        w.grad = g.clone()
        optimizer.step()
        sizes.append(((w.detach() - before).abs().mean() / lr).item())
    return sizes


# 梯度恒定:不论梯度是1e-4还是1e4,每一步都正好走一个学习率
for scale in [1e-4, 1.0, 1e4]:
    sizes = step_sizes([torch.full((1,), scale)] * 5)
    print(f"梯度 {scale:<7g} 前 5 步 |Δw|/lr:{[round(s, 4) for s in sizes]}")

# 去掉偏差修正:m和v都从0开始,v被低估得更多,步长偏大
steps = torch.arange(1, 1001)
no_correction = (1 - beta1 ** steps) / (1 - beta2 ** steps).sqrt()
print(f"无偏差修正:第 1 步 {no_correction[0].item():.2f},最大 {no_correction.max().item():.2f}(第 {no_correction.argmax().item() + 1} 步),"
      f"第 1000 步 {no_correction[-1].item():.2f}")

# 梯度是纯噪声(均值为0):第1步仍然走满一个学习率,之后才降下来
torch.manual_seed(0)
noise = step_sizes(list(torch.randn(1000, 10000)))
print(f"纯噪声梯度:第 1 步 {noise[0]:.3f},第 10 步 {noise[9]:.3f},第 100 步 {noise[99]:.3f},第 1000 步 {noise[-1]:.3f}")
1
2
3
4
5
梯度 0.0001  前 5 步 |Δw|/lr:[0.9999, 0.9999, 0.9999, 0.9999, 0.9999]
梯度 1       前 5 步 |Δw|/lr:[1.0, 1.0, 1.0, 1.0, 1.0]
梯度 10000   前 5 步 |Δw|/lr:[1.0, 1.0, 1.0, 1.0, 1.0]
无偏差修正:第 1 步 3.16,最大 6.57(第 12 步),第 1000 步 1.26
纯噪声梯度:第 1 步 1.000,第 10 步 0.272,第 100 步 0.183,第 1000 步 0.183
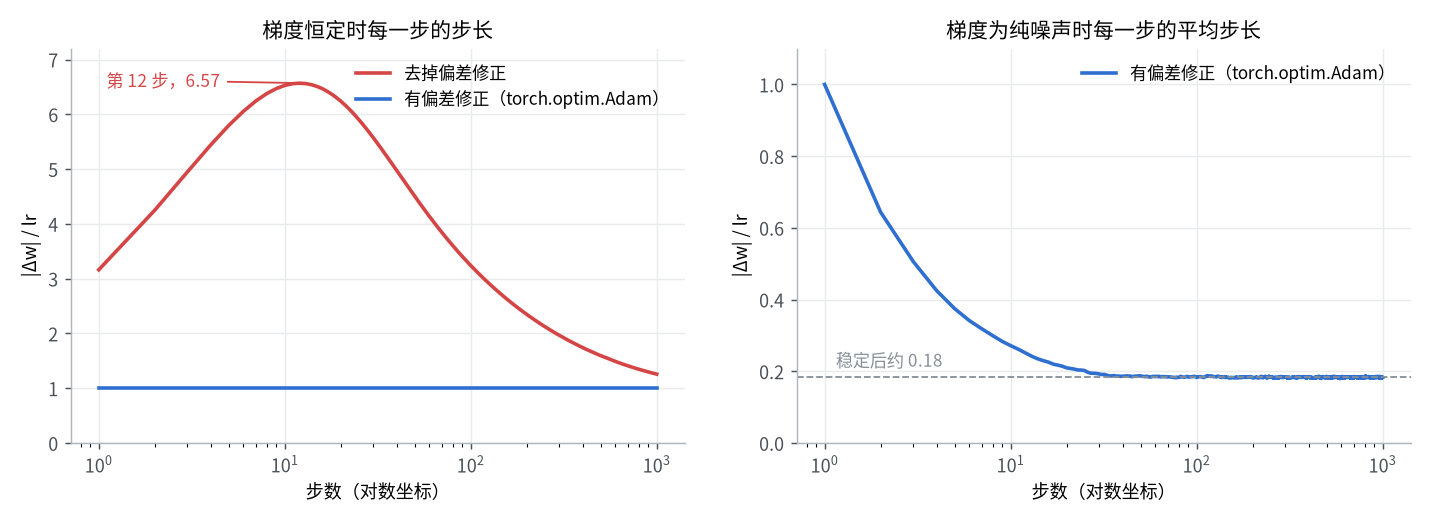
- 有偏差修正时,梯度恒定的情况下每一步都正好是一个学习率,与梯度是 1e-4 还是 1e4 无关。梯度为 1e-4 时得到 0.9999,差的那一点来自
eps - 去掉偏差修正后,$v$的衰减系数更接近 1,被低估得比$m$更多,步长在第 1 步是学习率的 3.16 倍,第 12 步达到 6.57 倍,1000 步之后仍有 1.26 倍
- 第 1 步的更新量总是一个学习率,不论梯度是否可靠。 第 1 步时$\hat{m} = g$、$\hat{v} = g^2$,更新量为$\eta \cdot \mathrm{sign}(g)$。梯度是均值为 0 的纯噪声时,稳定后平均每步只走 0.18 个学习率,而第 1 步是 1.0,前 10 步都在 0.27 以上
Adam 加 L2 与 AdamW
L2 正则与解耦的权重衰减的区别见Normalization and Regularization,那里用一个梯度为 0 的权重说明了Adam的weight_decay不受系数控制。放到 Adam 的公式里,两者的差别在于$\lambda w$加在哪里
| 优化器 | 衰减项的位置 | 每一步实际的衰减 |
|---|---|---|
Adam(weight_decay) | $g \leftarrow g + \lambda w$,之后进入$m$和$v$ | 约为$\eta \lambda w / \sqrt{\hat{v}}$ |
AdamW(weight_decay) | $w \leftarrow w - \eta \lambda w$,不经过$m$和$v$ | $\eta \lambda w$ |
Adam的衰减被除以了$\sqrt{\hat{v}}$,梯度大的参数衰减得慢,梯度小的参数衰减得快。下面取两组各 10000 个初值为 1 的权重,梯度是均值为 0 的噪声,标准差分别为 10 和 0.01,权重平均值的变化完全来自权重衰减
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import torch

n, steps, lr, weight_decay = 10000, 2000, 1e-3, 0.1


def run(optimizer_class, grad_scale):
    """n个初值为1的权重,梯度是均值为0、标准差为grad_scale的噪声,记录权重的平均值"""
    generator = torch.Generator().manual_seed(0)
    w = torch.nn.Parameter(torch.ones(n))
    optimizer = optimizer_class([w], lr=lr, weight_decay=weight_decay)
    history = [1.0]
    for _ in range(steps):
        w.grad = grad_scale * torch.randn(n, generator=generator)
        optimizer.step()
        history.append(w.mean().item())
    return history


curves = {}
for optimizer_class in [torch.optim.Adam, torch.optim.AdamW]:
    for grad_scale in [10.0, 0.01]:
        history = run(optimizer_class, grad_scale)
        curves[f"{optimizer_class.__name__} {grad_scale}"] = history
        print(f"{optimizer_class.__name__:5s} 梯度标准差 {grad_scale:<5g} 第 500 步 {history[500]:.4f}  第 2000 步 {history[2000]:.4f}")

print(f"(1 - lr * weight_decay) ** 2000 = {(1 - lr * weight_decay) ** steps:.4f}")
1
2
3
4
5
Adam  梯度标准差 10    第 500 步 0.9951  第 2000 步 0.9807
Adam  梯度标准差 0.01  第 500 步 0.5629  第 2000 步 0.0231
AdamW 梯度标准差 10    第 500 步 0.9513  第 2000 步 0.8192
AdamW 梯度标准差 0.01  第 500 步 0.9513  第 2000 步 0.8192
(1 - lr * weight_decay) ** 2000 = 0.8187
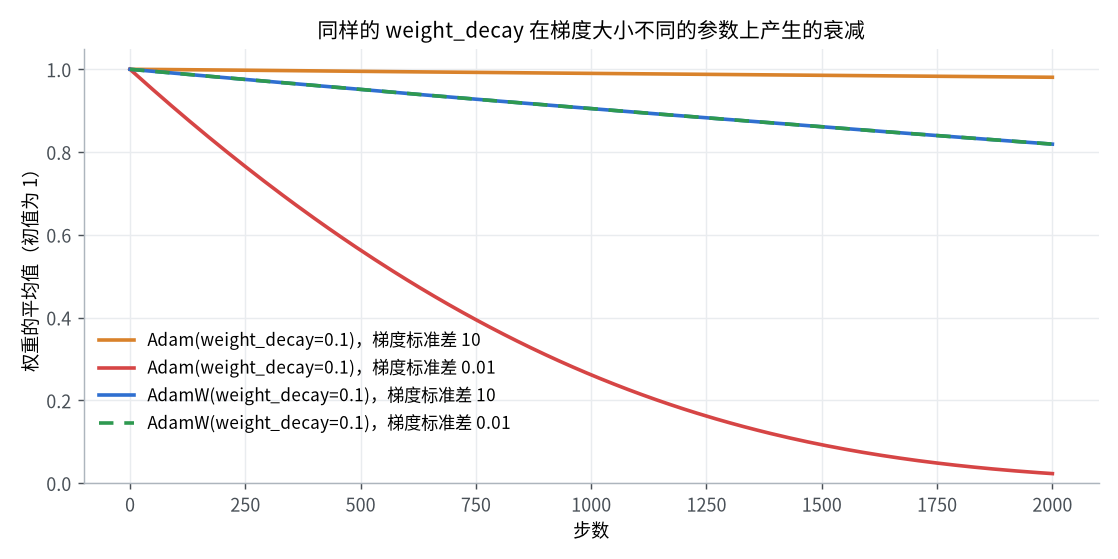
AdamW下两组权重的结果相同,都是 0.8192,与$(1 - \eta\lambda)^{2000} = 0.8187$一致,衰减只由学习率和系数决定Adam下梯度标准差为 10 的一组 2000 步后还剩 0.9807,每步的衰减是AdamW的十分之一;标准差为 0.01 的一组降到 0.0231,衰减项本身成了梯度的主要部分,开始时每步接近一个学习率- 一个网络中各层、各参数的梯度幅度相差几个数量级是常态。用
Adam加weight_decay时,正则化的强度实际上由梯度的幅度决定,而不是由设置的系数决定 AdamW的衰减量是$\eta \lambda w$,与学习率相乘。学习率随调度变化时衰减也跟着变化,调整学习率的同时也改变了正则化的强度
与 torch.optim 对照
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
import torch

torch.set_default_dtype(torch.float64)
torch.manual_seed(0)
A, b, w0 = torch.randn(20, 5), torch.randn(20), torch.randn(5)


def grad_fn(w):
    return 2 * A.T @ (A @ w - b) / len(b)


def manual_rmsprop(steps, lr, alpha=0.99, eps=1e-8):
    w, v = w0.clone(), torch.zeros(5)
    for _ in range(steps):
        g = grad_fn(w)
        v = alpha * v + (1 - alpha) * g ** 2
        w = w - lr * g / (v.sqrt() + eps)
    return w


def manual_adam(steps, lr, betas=(0.9, 0.999), eps=1e-8, weight_decay=0.0, decoupled=False):
    w, m, v = w0.clone(), torch.zeros(5), torch.zeros(5)
    for t in range(1, steps + 1):
        g = grad_fn(w)
        if decoupled:
            w = w * (1 - lr * weight_decay)          # AdamW:直接缩小权重,不经过m和v
        else:
            g = g + weight_decay * w                 # Adam:衰减项加在梯度上
        m = betas[0] * m + (1 - betas[0]) * g
        v = betas[1] * v + (1 - betas[1]) * g ** 2
        m_hat = m / (1 - betas[0] ** t)              # 偏差修正
        v_hat = v / (1 - betas[1] ** t)
        w = w - lr * m_hat / (v_hat.sqrt() + eps)
    return w


def torch_run(optimizer_class, steps, **kwargs):
    w = torch.nn.Parameter(w0.clone())
    optimizer = optimizer_class([w], **kwargs)
    for _ in range(steps):
        loss = (A @ w - b).pow(2).mean()
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()
    return w.detach()


def report(name, mine, theirs):
    print(f"{name:20s} 最大差值 {(mine - theirs).abs().max().item():.1e}")


report("RMSprop", manual_rmsprop(50, 0.01), torch_run(torch.optim.RMSprop, 50, lr=0.01))
report("Adam", manual_adam(50, 0.01), torch_run(torch.optim.Adam, 50, lr=0.01))
adam = torch_run(torch.optim.Adam, 50, lr=0.01, weight_decay=0.1)
adamw = torch_run(torch.optim.AdamW, 50, lr=0.01, weight_decay=0.1)
report("Adam(weight_decay)", manual_adam(50, 0.01, weight_decay=0.1), adam)
report("AdamW", manual_adam(50, 0.01, weight_decay=0.1, decoupled=True), adamw)
report("Adam 与 AdamW 之间", adam, adamw)
1
2
3
4
5
RMSprop              最大差值 1.1e-16
Adam                 最大差值 1.1e-16
Adam(weight_decay)   最大差值 6.9e-17
AdamW                最大差值 5.6e-17
Adam 与 AdamW 之间      最大差值 5.4e-02
- 四种情况都与 PyTorch 一致。
Adam与AdamW在同样的设置下走 50 步,参数相差 0.054,两者不能互相替换 - PyTorch 的
RMSprop中$v$从 0 开始并且没有偏差修正,第 1 步的步长是学习率的$1 / \sqrt{1 - \alpha}$倍,默认设置下为 10 倍
学习率调度
公式
记$t$为已经调用scheduler.step()的次数,$\eta_0$为创建优化器时设置的学习率,$T$为总步数,$T_w$为预热的步数
| 调度 | 公式 | 对应的调度器 |
|---|---|---|
| 线性预热 | $\eta_t = \eta_0 \left( s + (1 - s) \, t / T_w \right)$,$s$为起始比例 | LinearLR |
| 余弦退火 | $\eta_t = \eta_{\min} + \frac{1}{2} (\eta_0 - \eta_{\min}) \left( 1 + \cos (\pi t / T) \right)$ | CosineAnnealingLR |
| 阶梯衰减 | $\eta_t = \eta_0 \gamma^{\lfloor t / S \rfloor}$,每$S$步乘以$\gamma$ | StepLR |
| 单周期 | 两段余弦:从$\eta_{\max} / 25$升到$\eta_{\max}$,再降到$\eta_{\max} / (25 \times 10^4)$ | OneCycleLR |
- 余弦退火开始和结束时变化慢、中间变化快,学习率较大和较小的阶段都停留得比较久,并且除了总步数之外没有需要调的参数
- 单周期调度把预热和退火合在一起,上升阶段占总步数的比例由
pct_start指定,默认为 0.3,在第pct_start * total_steps - 1步到达max_lr
预热的作用
预热在训练开始的一小段时间内使用很小的学习率
- 对 Adam:上一节的测量表明第 1 步的更新量不论梯度是否可靠都是一个学习率,前 10 步的平均步长也明显高于稳定之后。这时$\hat{v}$只由很少的几个梯度估计出来,预热正好把这些步的更新量压小
- 对所有优化器:随机初始化的网络在开始阶段梯度大、变化快,大学习率容易一步走到损失很高的区域,归一化层的统计量也还没有稳定
- 学习率越大、批大小越大、网络越深,预热越重要。常见的长度是总步数的 1% 到 10%,或者固定的几百到几千步
手写公式与调度器对照
预热加余弦退火有三种等价的写法:直接写公式、把公式交给LambdaLR、用SequentialLR拼接LinearLR和CosineAnnealingLR
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
import math

import torch
from torch.optim import lr_scheduler

base_lr, eta_min, start_factor = 1e-3, 1e-5, 0.01
warmup_steps, total_steps = 50, 500


def formula(t):
    if t < warmup_steps:                                   # 线性预热
        return base_lr * (start_factor + (1 - start_factor) * t / warmup_steps)
    progress = (t - warmup_steps) / (total_steps - warmup_steps)
    return eta_min + (base_lr - eta_min) * 0.5 * (1 + math.cos(math.pi * progress))  # 余弦退火


def collect(make_scheduler):
    optimizer = torch.optim.SGD([torch.nn.Parameter(torch.zeros(1))], lr=base_lr)
    scheduler = make_scheduler(optimizer)
    lrs = []
    for _ in range(total_steps):
        lrs.append(scheduler.get_last_lr()[0])
        optimizer.step()
        scheduler.step()
    return torch.tensor(lrs, dtype=torch.float64)


def sequential(optimizer):
    warmup = lr_scheduler.LinearLR(optimizer, start_factor=start_factor, total_iters=warmup_steps)
    cosine = lr_scheduler.CosineAnnealingLR(optimizer, T_max=total_steps - warmup_steps, eta_min=eta_min)
    return lr_scheduler.SequentialLR(optimizer, [warmup, cosine], milestones=[warmup_steps])


manual = torch.tensor([formula(t) for t in range(total_steps)], dtype=torch.float64)
by_lambda = collect(lambda optimizer: lr_scheduler.LambdaLR(optimizer, lambda t: formula(t) / base_lr))
by_sequential = collect(sequential)

for t in [0, 25, 50, 499]:
    print(f"第 {t:3d} 步  公式 {manual[t].item():.6e}  LambdaLR {by_lambda[t].item():.6e}  SequentialLR {by_sequential[t].item():.6e}")
print(f"与 LambdaLR 的最大差值 {(manual - by_lambda).abs().max().item():.1e}")
print(f"与 SequentialLR 的最大差值 {(manual - by_sequential).abs().max().item():.1e}")
1
2
3
4
5
6
第   0 步  公式 1.000000e-05  LambdaLR 1.000000e-05  SequentialLR 1.000000e-05
第  25 步  公式 5.050000e-04  LambdaLR 5.050000e-04  SequentialLR 5.050000e-04
第  50 步  公式 1.000000e-03  LambdaLR 1.000000e-03  SequentialLR 1.000000e-03
第 499 步  公式 1.001206e-05  LambdaLR 1.001206e-05  SequentialLR 1.001206e-05
与 LambdaLR 的最大差值 1.1e-19
与 SequentialLR 的最大差值 7.6e-19
- 三种写法的结果相同,差值在 1e-19 的量级。
LambdaLR接收的函数返回的是相对于初始学习率的倍数,不是学习率本身 - 最后一步是 1.001206e-05 而不是
eta_min:第 499 步的进度是 449/450,余弦要到第 500 步才正好到底。希望最后一步恰好是最小值时,把分母改为总步数减 1
按轮还是按步调用
调度器只统计step()被调用的次数。T_max的单位与调用的频率不一致时不会有任何提示,学习率曲线却完全不同。下面用CosineAnnealingLR模拟 20 轮、每轮 50 个批次的训练,记录每个批次实际使用的学习率
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import torch
from torch.optim import lr_scheduler

epochs, steps_per_epoch, base_lr = 20, 50, 1e-3


def simulate(t_max, per_step):
    """返回每个批次实际使用的学习率。per_step为True时每个批次调用一次scheduler.step(),否则每轮一次"""
    optimizer = torch.optim.SGD([torch.nn.Parameter(torch.zeros(1))], lr=base_lr)
    scheduler = lr_scheduler.CosineAnnealingLR(optimizer, T_max=t_max)
    lrs = []
    for epoch in range(epochs):
        for _ in range(steps_per_epoch):
            lrs.append(scheduler.get_last_lr()[0])
            optimizer.step()
            if per_step:
                scheduler.step()
        if not per_step:
            scheduler.step()
    return lrs


cases = {
    "按步数设置,每个批次调用": simulate(epochs * steps_per_epoch, per_step=True),
    "按轮数设置,每轮调用": simulate(epochs, per_step=False),
    "按轮数设置,每个批次调用": simulate(epochs, per_step=True),
    "按步数设置,每轮调用": simulate(epochs * steps_per_epoch, per_step=False),
}
for name, lrs in cases.items():
    ends = [lrs[k * steps_per_epoch - 1] for k in (1, 10, 20)]
    print(f"{name}  第 1、10、20 轮末 {ends[0]:.2e} {ends[1]:.2e} {ends[2]:.2e}  平均 {sum(lrs) / len(lrs):.2e}")
1
2
3
4
按步数设置,每个批次调用  第 1、10、20 轮末 9.94e-04 5.02e-04 2.47e-09  平均 5.00e-04
按轮数设置,每轮调用  第 1、10、20 轮末 1.00e-03 5.78e-04 6.16e-06  平均 5.25e-04
按轮数设置,每个批次调用  第 1、10、20 轮末 5.78e-04 6.16e-06 9.94e-04  平均 5.00e-04
按步数设置,每轮调用  第 1、10、20 轮末 1.00e-03 1.00e-03 9.99e-04  平均 1.00e-03
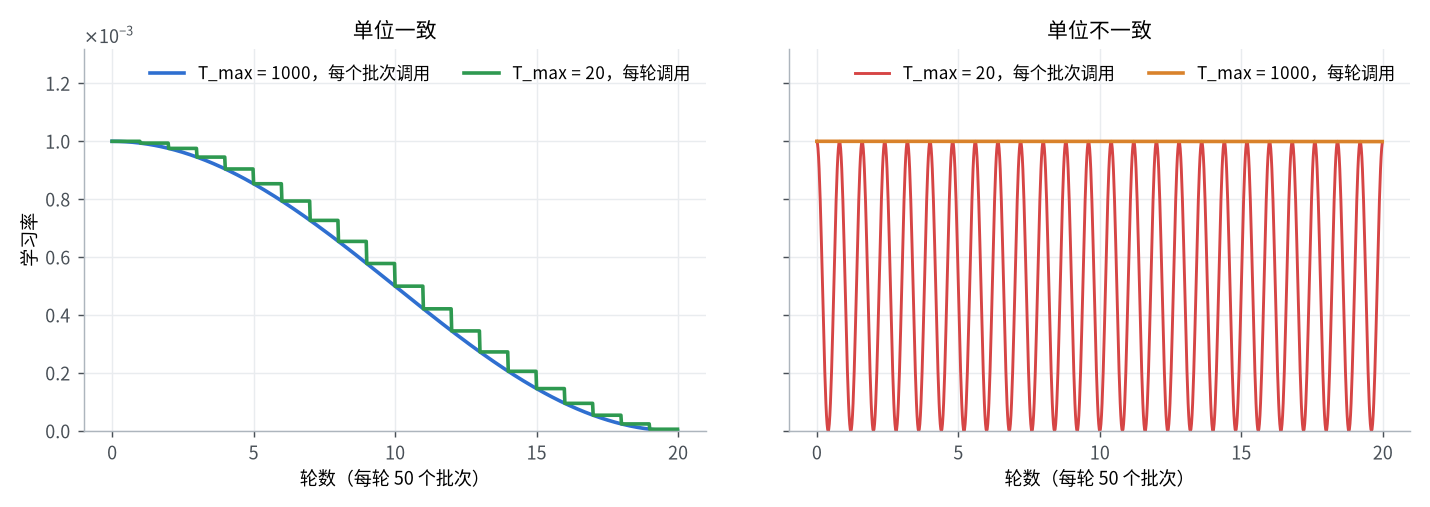
T_max按轮数设置却每个批次调用:学习率 20 步就降到 0。CosineAnnealingLR超过T_max之后不会停在最小值,而是沿余弦继续,学习率重新升高,每 40 步一个周期,20 轮内上下 25 次T_max按步数设置却每轮调用:20 轮只走了余弦的前 2%,学习率仍为 9.99e-4,相当于没有调度- 后两种情况训练不会报错,损失也可能正常下降,只是结果比预期差。训练前把学习率曲线画出来,或者把
scheduler.get_last_lr()记录到日志里,可以直接发现 - 带预热的调度应当按批次调用:预热通常只有几百步,按轮调用时一轮之内学习率不变,起不到预热的作用
学习率与批大小
线性缩放
批大小变为$k$倍时,学习率也取$k$倍,这称为线性缩放规则。用小批次、学习率$\eta$走$k$步的结果是
\[w_{t+k} = w_t - \eta \sum_{j=0}^{k-1} g(w_{t+j})\]如果这$k$步之内参数变化不大,可以把$g(w_{t+j})$近似为$g(w_t)$,右边就等于用$k$倍的批次、$k\eta$的学习率走一步。同样的轮数下大批次的步数只有$1 / k$,学习率不放大的话,参数移动的总距离也只有$1 / k$
用sklearn的手写数字做一个小实验:一个三层的全连接网络,带动量的SGD,1280 张训练、517 张测试,都训练 40 轮,每种设置取 3 个随机种子的平均
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
import torch
import torch.nn.functional as F
from sklearn.datasets import load_digits
from torch import nn

digits = load_digits()
x = torch.tensor(digits.data, dtype=torch.float32) / 16
y = torch.tensor(digits.target)
order = torch.randperm(len(x), generator=torch.Generator().manual_seed(0))
train_idx, test_idx = order[:1280], order[1280:]


def run(batch_size, lr, epochs=40, seed=0):
    torch.manual_seed(seed)
    model = nn.Sequential(nn.Linear(64, 128), nn.ReLU(), nn.Linear(128, 128), nn.ReLU(), nn.Linear(128, 10))
    optimizer = torch.optim.SGD(model.parameters(), lr=lr, momentum=0.9)
    steps_per_epoch = len(train_idx) // batch_size
    history = []
    for epoch in range(epochs):
        perm = train_idx[torch.randperm(len(train_idx))]
        total = 0.0
        for i in range(steps_per_epoch):
            idx = perm[i * batch_size:(i + 1) * batch_size]
            loss = F.cross_entropy(model(x[idx]), y[idx])
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()
            total += loss.item()
        history.append(total / steps_per_epoch)
    with torch.no_grad():
        accuracy = (model(x[test_idx]).argmax(dim=1) == y[test_idx]).float().mean().item()
    return history, accuracy, epochs * steps_per_epoch


curves = {}
print("批大小  学习率  步数  第 10 轮损失  第 40 轮损失  测试准确率")
for batch_size, lr in [(16, 0.01), (64, 0.01), (64, 0.04), (256, 0.01), (256, 0.16), (1024, 0.01), (1024, 0.64)]:
    results = [run(batch_size, lr, seed=seed) for seed in range(3)]
    history = [sum(r[0][e] for r in results) / 3 for e in range(40)]
    accuracy = sum(r[1] for r in results) / 3
    curves[f"{batch_size} {lr}"] = history
    print(f"{batch_size:<6d}  {lr:<6g}  {results[0][2]:<4d}  {history[9]:<12.4f}  {history[39]:<12.4f}  {accuracy:.4f}")
1
2
3
4
5
6
7
8
批大小  学习率  步数  第 10 轮损失  第 40 轮损失  测试准确率
16      0.01    3200  0.0946        0.0075        0.9716
64      0.01    800   0.4811        0.0769        0.9626
64      0.04    800   0.1058        0.0075        0.9736
256     0.01    200   2.2084        0.4264        0.9046
256     0.16    200   0.1766        0.0071        0.9742
1024    0.01    40    2.3001        2.2327        0.4288
1024    0.64    40    0.8733        2.1825        0.2579
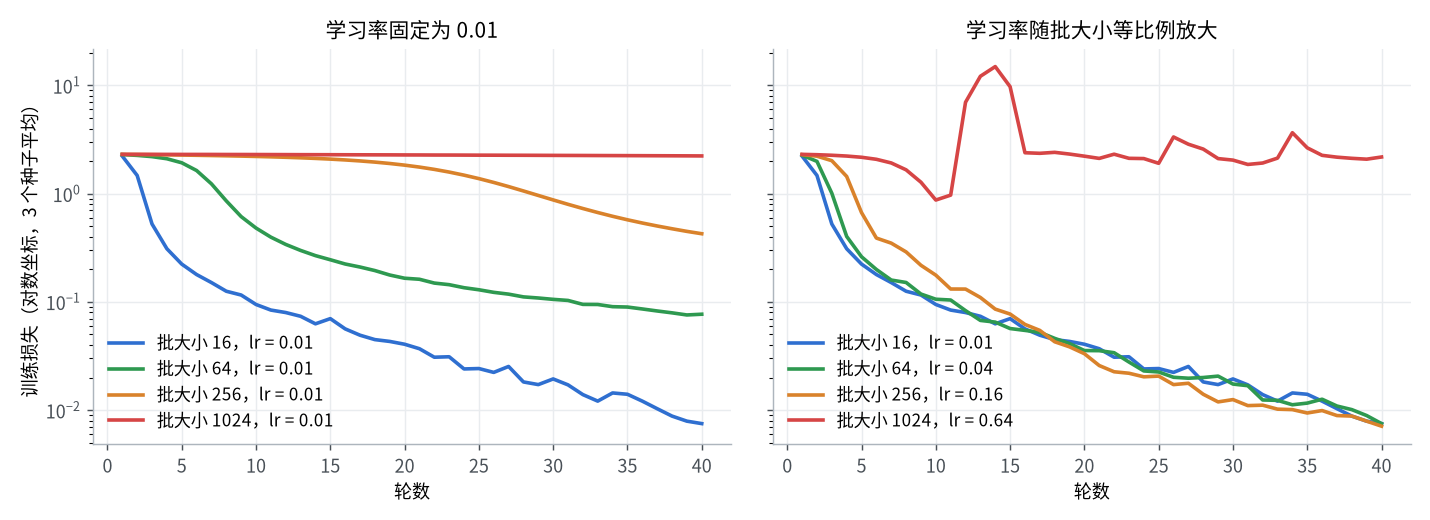
- 学习率固定为 0.01 时,批大小每放大 4 倍,40 轮后的损失就高出一截:0.0075、0.0769、0.4264,批大小为 1024 时只走了 40 步,几乎没有下降
- 学习率随批大小等比例放大后,批大小 16、64、256 在 40 轮后的损失为 0.0075、0.0075、0.0071,测试准确率都在 0.97 以上,按轮数画出的损失曲线基本重合
- 批大小为 1024、学习率为 0.64 时训练失败,损失一度升到 10 以上,最后停在 2.18。规则成立的前提是$k$步之内参数变化不大,学习率太大时这个前提不再成立,能够放大到多少与模型和数据有关。训练刚开始时参数变化最快,近似最不准确,所以大批次配合大学习率时通常要加预热
- 线性缩放是针对 SGD 的经验规则。Adam 的步长已经按梯度的幅度归一化过,批大小变化时学习率通常不需要按同样的比例调整,改变批大小之后应当重新搜索学习率。这一点没有在这里的实验中验证
常用的默认设置
以下是通用的经验值,作为搜索的起点,不是这里的实验结果
| 场景 | 优化器 | 学习率 | 权重衰减 | 调度 |
|---|---|---|---|---|
| 从头训练卷积网络 | SGD,momentum=0.9 | 批大小 256 时为 0.1 | 1e-4 到 5e-4 | 余弦退火或阶梯衰减 |
| 从头训练 Transformer | AdamW,betas=(0.9, 0.999) | 1e-4 到 1e-3 | 0.01 到 0.1 | 预热加余弦退火 |
| 微调预训练模型 | AdamW | 1e-5 到 1e-4 | 0.01 | 短预热加余弦或线性衰减 |
| 小模型、快速试验 | Adam | 1e-3 | 0 | 不调度,或余弦退火 |
- 学习率是最值得先调的超参数,按 3 倍或 10 倍的间隔搜索,例如 1e-4、3e-4、1e-3、3e-3。改变批大小、换优化器、加入或去掉预热之后都需要重新搜索
- 微调时各层使用不同学习率的做法见PyTorch Fine-Tuning