Normalization and Regularization
整理 PyTorch 中各种归一化层的统计维度与手动计算、BatchNorm 在训练和推理时的区别,以及权重衰减、Dropout、标签平滑等正则化方法的用法与实测效果
深度学习系列:第 8 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
归一化层把每一层的输入调整到稳定的分布,让网络更容易训练;正则化限制模型对训练数据的过度拟合,让它在没见过的数据上表现更好。PyTorch CNN中的BatchNorm和PyTorch Transformer中的LayerNorm、RMSNorm、Dropout都属于这两类
归一化层对比
统计维度
所有归一化层做的都是同一件事:在一部分元素上统计均值$\mu$和方差$\sigma^2$,减去均值、除以标准差,再乘以可学习的缩放系数$\gamma$、加上可学习的偏移$\beta$
\[y = \frac{x - \mu}{\sqrt{\sigma^2 + \epsilon}} \cdot \gamma + \beta\]各种归一化层的区别只在于均值和方差是在哪些元素上统计的。以形状为$(N, C, H, W)$的图像张量为例,下图中同一种颜色的部分共用一组均值和方差
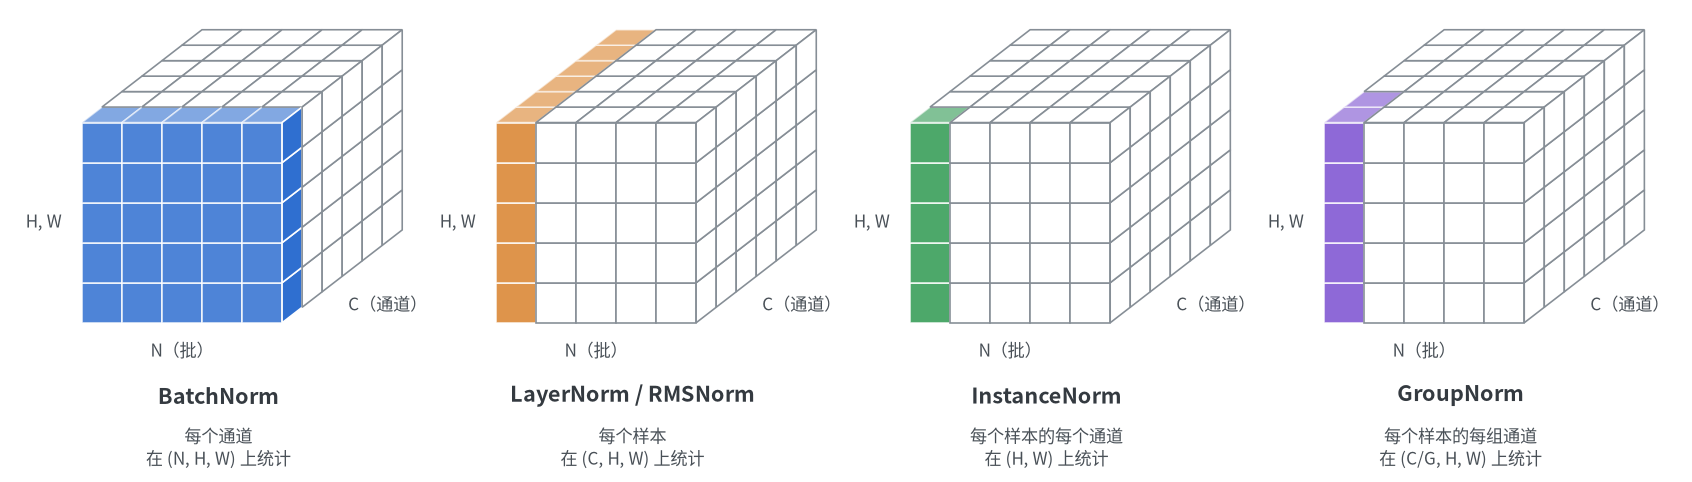
| 归一化层 | 统计范围 | 依赖批大小 | 训练与推理 | 常见用途 |
|---|---|---|---|---|
BatchNorm | 每个通道,跨整个批 | 是 | 行为不同 | 卷积网络 |
LayerNorm | 每个样本,跨所有通道 | 否 | 行为相同 | Transformer、循环网络 |
InstanceNorm | 每个样本的每个通道 | 否 | 行为相同 | 风格迁移、图像生成 |
GroupNorm | 每个样本的每组通道 | 否 | 行为相同 | 批很小的检测、分割,扩散模型 |
RMSNorm | 与LayerNorm相同,但不减均值 | 否 | 行为相同 | 大语言模型 |
RMSNorm是LayerNorm的简化:不减均值,只除以均方根,也没有偏移$\beta$
对应的模块
| 模块 | 输入形状 | 可学习参数 |
|---|---|---|
nn.BatchNorm1d(num_features) | (N, C) 或 (N, C, L) | 2 × C |
nn.BatchNorm2d(num_features) | (N, C, H, W) | 2 × C |
nn.LayerNorm(normalized_shape) | 末尾几维与参数一致 | 2 × normalized_shape |
nn.GroupNorm(num_groups, num_channels) | (N, C, …) | 2 × C |
nn.InstanceNorm2d(num_features) | (N, C, H, W) | 默认没有,affine=True时为 2 × C |
nn.RMSNorm(normalized_shape) | 末尾几维与参数一致 | normalized_shape |
BatchNorm、GroupNorm、InstanceNorm都把第 1 维当作通道,LayerNorm和RMSNorm则对末尾的若干维做归一化,两类模块的参数含义不同nn.GroupNorm的通道数必须能被组数整除,否则报错num_channels (6) must be divisible by num_groups (4)- 上图是图像张量的情形。Transformer 中的张量形状为$(N, L, E)$,
nn.LayerNorm(E)只在最后一维上统计,每个样本的每个位置各自归一化,与批大小和序列长度都无关
手动计算
要弄清一个归一化层做了什么,最直接的办法是用普通的张量运算把它重新算一遍,再与nn中的模块比较。新建的模块中$\gamma$为 1、$\beta$为 0,输出就是标准化的结果;唯一需要变化的是求均值和方差时的dim
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
import torch
from torch import nn

torch.manual_seed(0)
x = torch.randn(8, 6, 4, 4)  # (N, C, H, W)
eps = 1e-5


def standardize(x, dim):
    """在dim指定的维度上减去均值、除以标准差"""
    mean = x.mean(dim=dim, keepdim=True)
    var = x.var(dim=dim, keepdim=True, unbiased=False)
    return (x - mean) / torch.sqrt(var + eps)


# BatchNorm:每个通道在(N, H, W)上统计
print(torch.allclose(standardize(x, (0, 2, 3)), nn.BatchNorm2d(6)(x), atol=1e-6))    # True

# LayerNorm:每个样本在(C, H, W)上统计
print(torch.allclose(standardize(x, (1, 2, 3)), nn.LayerNorm([6, 4, 4])(x), atol=1e-6))  # True

# InstanceNorm:每个样本的每个通道在(H, W)上统计
print(torch.allclose(standardize(x, (2, 3)), nn.InstanceNorm2d(6)(x), atol=1e-6))    # True

# GroupNorm:把6个通道分成3组,每个样本的每一组在(C/G, H, W)上统计
grouped = x.view(8, 3, 2, 4, 4)  # (N, G, C/G, H, W)
manual = standardize(grouped, (2, 3, 4)).view(8, 6, 4, 4)
print(torch.allclose(manual, nn.GroupNorm(3, 6)(x), atol=1e-6))                      # True

# RMSNorm:不减均值,只除以均方根
rms = torch.sqrt(x.pow(2).mean(dim=(1, 2, 3), keepdim=True) + eps)
print(torch.allclose(x / rms, nn.RMSNorm([6, 4, 4], eps=eps)(x), atol=1e-6))         # True

# GroupNorm的两个特例
print(torch.allclose(nn.GroupNorm(1, 6)(x), nn.LayerNorm([6, 4, 4])(x), atol=1e-6))  # True,只分1组
print(torch.allclose(nn.GroupNorm(6, 6)(x), nn.InstanceNorm2d(6)(x), atol=1e-6))     # True,每个通道1组
- 归一化时用的是有偏方差(除以元素个数),所以是
unbiased=False nn.GroupNorm(1, C)在统计范围上等同于对$(C, H, W)$做LayerNorm,而且不需要事先知道$H$和$W$,因此在卷积网络中想用LayerNorm时常用它代替。两者可学习参数的形状不同:GroupNorm是每个通道一组,LayerNorm([C, H, W])是每个元素一组nn.RMSNorm的eps默认为None,表示使用该数据类型的最小精度,比较时显式传入了相同的值
序列形状的输入同理,只在最后一维上统计
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import torch
from torch import nn

torch.manual_seed(0)
x = torch.randn(2, 10, 64)  # (N, L, E)

# LayerNorm(64)只在最后一个维度上统计,每个样本的每个位置各自归一化
mean = x.mean(dim=-1, keepdim=True)
var = x.var(dim=-1, keepdim=True, unbiased=False)
print(torch.allclose((x - mean) / torch.sqrt(var + 1e-5), nn.LayerNorm(64)(x), atol=1e-6))  # True

rms = torch.sqrt(x.pow(2).mean(dim=-1, keepdim=True) + 1e-5)
print(torch.allclose(x / rms, nn.RMSNorm(64, eps=1e-5)(x), atol=1e-6))                      # True

# 可学习的参数
print(sum(p.numel() for p in nn.LayerNorm(64).parameters()))  # 128,缩放系数和偏移
print(sum(p.numel() for p in nn.RMSNorm(64).parameters()))    # 64,只有缩放系数

# BatchNorm1d要求通道在第1维,(N, L, E)需要先转置为(N, E, L)
try:
    nn.BatchNorm1d(64)(x)
except RuntimeError as e:
    print(e)  # running_mean should contain 10 elements not 64
print(nn.BatchNorm1d(64)(x.transpose(1, 2)).transpose(1, 2).shape)  # torch.Size([2, 10, 64])
BatchNorm 的训练与推理
BatchNorm是唯一在训练和推理时行为不同的归一化层,绝大多数与归一化有关的问题都出在这里
运行统计量
训练时,BatchNorm用当前这一批数据的均值和方差做归一化。推理时往往只有一个样本,也不应该让一个样本的结果受同一批中其他样本的影响,因此BatchNorm在训练过程中顺便维护了一份均值和方差的滑动平均,称为运行统计量,推理时直接使用
| 模式 | 归一化使用的统计量 | 运行统计量 |
|---|---|---|
model.train() | 当前这一批的均值和方差 | 每次前向传播更新一次 |
model.eval() | running_mean和running_var | 不变 |
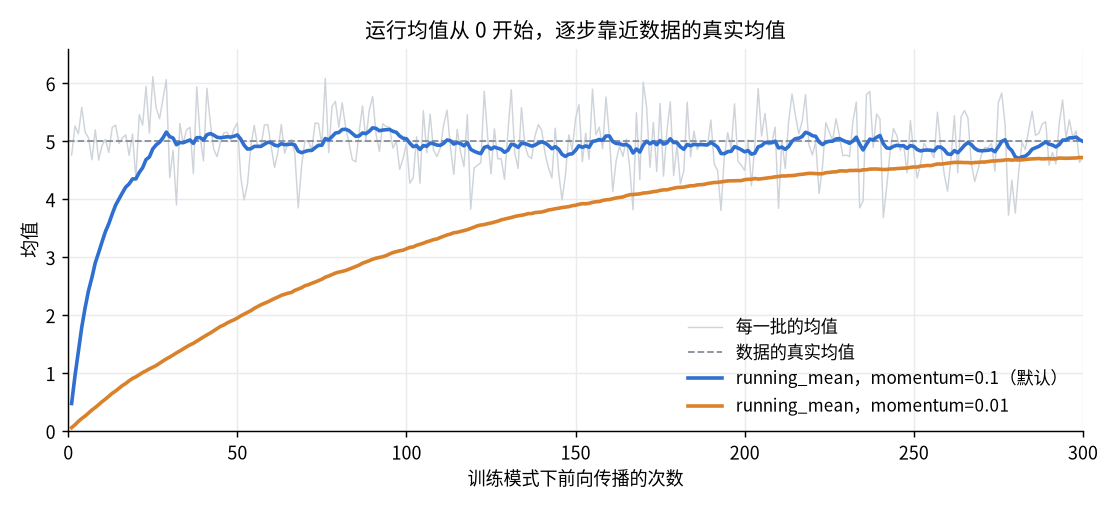
每次前向传播的更新方式如下,其中$m$为momentum参数,默认 0.1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
import torch
from torch import nn

torch.manual_seed(0)
torch.set_printoptions(precision=4, sci_mode=False)
bn = nn.BatchNorm1d(3)
print(bn.running_mean, bn.running_var)  # tensor([0., 0., 0.]) tensor([1., 1., 1.])

x = torch.randn(64, 3) * 2 + 5  # 均值约为5,标准差约为2

bn.train()
with torch.no_grad():
    y = bn(x)
print(y.mean(dim=0), y.var(dim=0, unbiased=False))  # 用这一批自己的统计量,输出的均值为0、方差为1
print(bn.running_mean)  # tensor([0.5039, 0.4496, 0.5536])
print(bn.running_var)   # tensor([1.2227, 1.2167, 1.3412])
print(torch.allclose(bn.running_mean, 0.9 * 0 + 0.1 * x.mean(dim=0)))  # True
print(torch.allclose(bn.running_var, 0.9 * 1 + 0.1 * x.var(dim=0)))    # True,运行方差用的是无偏估计

bn.eval()
with torch.no_grad():
    y = bn(x)
print(y.mean(dim=0))    # 用运行统计量,只更新了一次还远没有收敛,输出的均值不为0
manual = (x - bn.running_mean) / torch.sqrt(bn.running_var + bn.eps) * bn.weight + bn.bias
print(torch.allclose(y, manual, atol=1e-6))  # True
构造参数中与此相关的有
| 参数 | 默认值 | 说明 |
|---|---|---|
momentum | 0.1 | 新一批统计量所占的比例;设为None时改为所有批的算术平均 |
eps | 1e-5 | 加在方差上防止除以零 |
affine | True | 是否带可学习的$\gamma$和$\beta$ |
track_running_stats | True | 设为False时不维护运行统计量,推理时也使用当前批的统计量 |
- 这里的
momentum与优化器中的动量含义相反:值越大,运行统计量变化越快 running_mean和running_var不是参数而是缓冲区(buffer),不会被优化器更新,但会随state_dict()一起保存- 运行统计量的初始值是均值 0、方差 1。默认的
momentum下,大约前向传播 44 次之后初始值的影响才降到 1% 以下($0.9^{44} \approx 0.01$),训练步数很少时运行统计量还没有收敛
下图是对均值为 5 的数据反复前向传播时running_mean的实际变化。momentum越小曲线越平滑,但收敛也越慢
常见问题
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
import torch
from torch import nn

torch.manual_seed(0)
torch.set_printoptions(precision=4, sci_mode=False)
model = nn.Sequential(nn.Linear(4, 8), nn.BatchNorm1d(8), nn.ReLU(), nn.Linear(8, 2))
with torch.no_grad():
    for _ in range(100):  # 模拟训练,让运行统计量收敛
        model(torch.randn(32, 4))

    sample = torch.randn(1, 4)
    batch_a = torch.cat([sample, torch.randn(7, 4)])
    batch_b = torch.cat([sample, torch.randn(7, 4) * 3])

    # 训练模式:同一个样本的输出取决于同一批里的其他样本
    model.train()
    print(model(batch_a)[0])  # tensor([-0.2558, -0.1195])
    print(model(batch_b)[0])  # tensor([-0.0748, -0.1185])

    # 而且每次前向传播都会修改运行统计量,torch.no_grad()并不能阻止
    before = model[1].running_mean.clone()
    model(batch_b)
    print(torch.equal(before, model[1].running_mean))  # False

    # 推理模式:输出只与样本自身有关
    model.eval()
    print(model(batch_a)[0])  # tensor([-0.1263, -0.0736])
    print(model(batch_b)[0])  # tensor([-0.1263, -0.0736])
    print(model(sample)[0])   # tensor([-0.1263, -0.0736])

    # 训练模式下批大小为1
    model.train()
    try:
        model(sample)
    except ValueError as e:
        print(e)  # Expected more than 1 value per channel when training, got input size torch.Size([1, 8])

# 冻结参数不等于冻结运行统计量
bn = nn.BatchNorm2d(3)
bn.requires_grad_(False)
bn(torch.randn(4, 3, 8, 8) + 1)
print(bn.running_mean)  # tensor([0.1030, 0.0976, 0.0918]),仍然被更新了

bn.eval()
bn(torch.randn(4, 3, 8, 8) + 1)
print(bn.running_mean)  # tensor([0.1030, 0.0976, 0.0918]),eval()之后才不再变化
- 推理前必须调用
model.eval()。忘记调用时程序不会报错,但同一个样本的输出会随着同一批中的其他样本变化,而且每推理一次,运行统计量就被推理数据改写一次 torch.no_grad()只是不记录梯度,不会改变BatchNorm和Dropout的行为,不能代替model.eval()- 验证结束后要重新调用
model.train(),否则之后的训练一直使用运行统计量 - 训练模式下每个通道至少需要两个值才能计算方差。全连接层之后的
BatchNorm1d在批大小为 1 时直接报错,最常见的触发场景是数据集的最后一批恰好只剩一个样本,给DataLoader加上drop_last=True即可 - 微调时如果想冻结
BatchNorm,只设置requires_grad_(False)是不够的,它只冻结了$\gamma$和$\beta$,运行统计量仍然会被新数据更新。需要对这些层调用eval(),并且注意之后每次model.train()都会把它们重新切回训练模式 - 训练损失正常而验证结果很差或忽高忽低时,先检查是否漏了
model.eval(),其他排查方法见PyTorch Debugging
批大小的影响
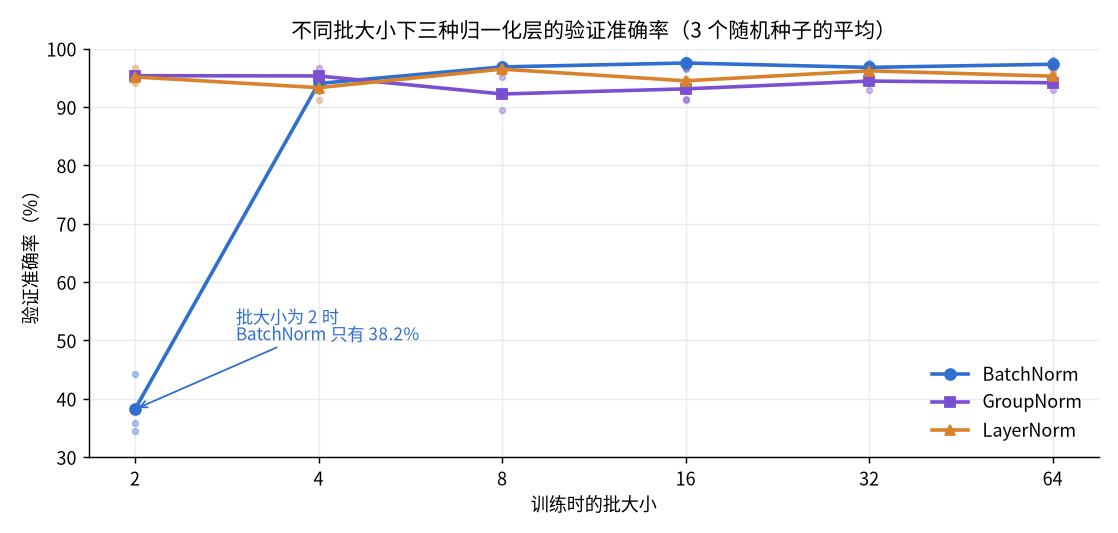
BatchNorm用一批数据的统计量来代替整个数据集的统计量,批越小估计得越不准。极端情况是批大小为 2 且每个通道只有一个值:标准化之后每个值只可能是 +1 或 −1,原来的数值大小完全丢失
1
2
3
4
5
6
7
import torch
from torch import nn

torch.manual_seed(0)
print(nn.BatchNorm1d(4)(torch.randn(2, 4) * 3 + 1).detach())
# tensor([[ 1.0000,  1.0000, -1.0000, -1.0000],
#         [-1.0000, -1.0000,  1.0000,  1.0000]])
下面是一次实际的对比:在load_digits手写数字数据集上取 1000 个样本训练、797 个样本验证,网络是三层 64 维的全连接层,每层之后接一个归一化层,分别使用BatchNorm1d(64)、GroupNorm(8, 64)和LayerNorm(64)。使用带动量的 SGD 训练 10 轮,学习率随批大小等比例缩放,每种配置用 3 个随机种子,下表为验证准确率的平均值
| 批大小 | BatchNorm | GroupNorm | LayerNorm |
|---|---|---|---|
| 2 | 38.2% | 95.4% | 95.2% |
| 4 | 94.0% | 95.3% | 93.3% |
| 8 | 96.9% | 92.2% | 96.5% |
| 16 | 97.5% | 93.1% | 94.5% |
| 32 | 96.8% | 94.4% | 96.2% |
| 64 | 97.3% | 94.1% | 95.3% |
- 批大小为 2 时
BatchNorm几乎无法工作,到 4 时也仍然略低;批大小在 8 以上时它是三者中最好的 GroupNorm和LayerNorm的统计量来自单个样本,准确率在不同批大小之间只有随机波动,没有随批变小而下降的趋势- 这个实验用的是全连接网络,每个通道在一批中只有$N$个值。卷积网络中每个通道有$N \times H \times W$个值,对小批量的容忍度更高,但批大小只有 1 到 2 时同样会出问题
如何选择
| 场景 | 推荐 | 原因 |
|---|---|---|
| 卷积网络,批大小足够(16 以上) | BatchNorm2d | 效果好,推理时可以与卷积合并,没有额外开销 |
| 卷积网络,批很小 | GroupNorm | 检测、分割等任务图像大,一批只能放几张 |
| 多卡训练,每张卡上的批很小 | SyncBatchNorm | 跨所有显卡统计,相当于增大了批 |
| Transformer | LayerNorm | 序列长度不固定,批内还有填充,不适合跨样本统计 |
| 大语言模型 | RMSNorm | 计算更少,效果与LayerNorm相当 |
| 风格迁移、图像生成 | InstanceNorm、GroupNorm | 每张图像独立处理,不受同一批其他图像的影响 |
GroupNorm的组数常用 32,通道数较少时取能整除的较小值- 已有的模型可以用
nn.SyncBatchNorm.convert_sync_batchnorm(model)把其中所有的BatchNorm替换为SyncBatchNorm - 归一化层放在卷积或全连接层之后、激活函数之前是最常见的顺序。紧跟归一化层的卷积不需要偏置,见PyTorch CNN中的 Conv-BN-ReLU
- Transformer 中归一化层放在子层之前还是之后(前归一化与后归一化)见PyTorch Transformer
过拟合
模型的参数足够多时,可以把训练数据全部记住,训练损失降到接近 0,但记住的内容里有一部分只是训练样本自身的偶然特征,对新数据没有帮助甚至有害,这就是过拟合。训练数据越少、模型越大,过拟合越严重
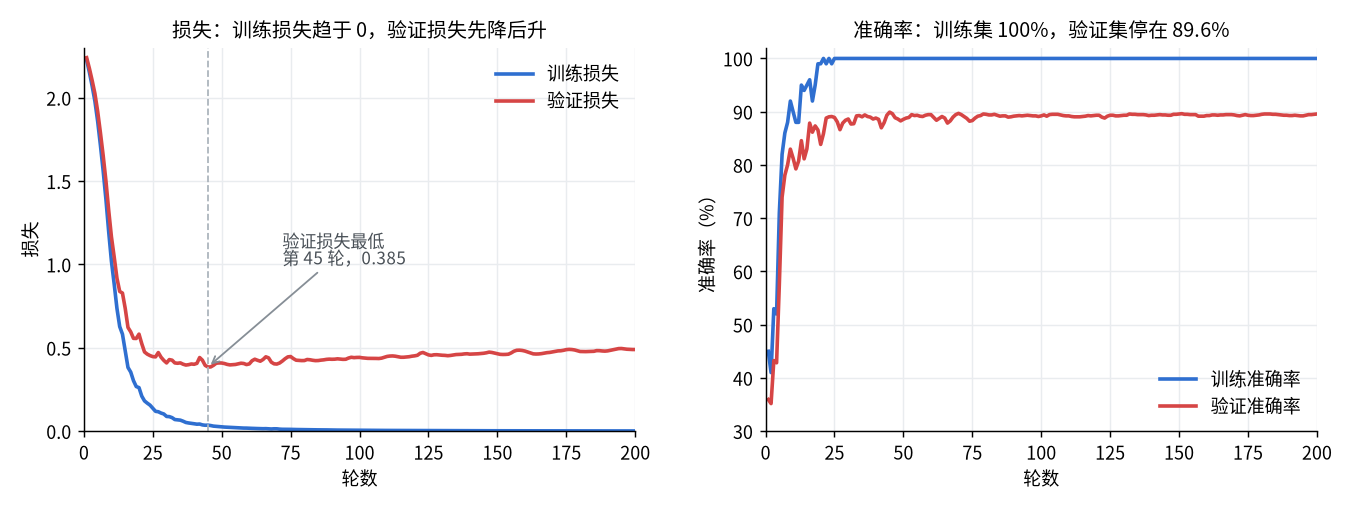
判断过拟合的方法是留出一部分不参与训练的验证集,每一轮结束后同时计算训练集和验证集上的损失。下面的例子故意制造过拟合:从load_digits中只取 100 个样本训练一个约 8.5 万个参数的全连接网络,其余 1697 个样本用于验证
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
import torch
from torch import nn
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split

X, y = load_digits(return_X_y=True)  # 1797张8x8的手写数字图像,已展平为64维
X = torch.tensor(X, dtype=torch.float32) / 16
y = torch.tensor(y)
# 只取100个样本训练,其余1697个用于验证
X_train, X_val, y_train, y_val = train_test_split(X, y, train_size=100, random_state=0, stratify=y)


def train(weight_decay=0.0, dropout=0.0, epochs=200, seed=0):
    torch.manual_seed(seed)
    model = nn.Sequential(
        nn.Linear(64, 256), nn.ReLU(), nn.Dropout(dropout),
        nn.Linear(256, 256), nn.ReLU(), nn.Dropout(dropout),
        nn.Linear(256, 10),
    )
    optimizer = torch.optim.AdamW(model.parameters(), lr=1e-3, weight_decay=weight_decay)
    criterion = nn.CrossEntropyLoss()
    history = []
    for epoch in range(epochs):
        model.train()
        order = torch.randperm(len(X_train))
        for i in range(0, len(X_train), 32):
            index = order[i:i + 32]
            loss = criterion(model(X_train[index]), y_train[index])
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

        model.eval()
        with torch.no_grad():
            out_train, out_val = model(X_train), model(X_val)
            history.append((
                criterion(out_train, y_train).item(),
                criterion(out_val, y_val).item(),
                (out_train.argmax(dim=1) == y_train).float().mean().item(),
                (out_val.argmax(dim=1) == y_val).float().mean().item(),
            ))
    return history


history = train()
for epoch in [0, 9, 19, 49, 99, 199]:
    train_loss, val_loss, train_acc, val_acc = history[epoch]
    print(f"epoch {epoch + 1:>3}  train loss {train_loss:.4f}  val loss {val_loss:.4f}  "
          f"train acc {train_acc:.3f}  val acc {val_acc:.3f}")
1
2
3
4
5
6
epoch   1  train loss 2.2275  val loss 2.2410  train acc 0.450  val acc 0.359
epoch  10  train loss 1.0193  val loss 1.1657  train acc 0.900  val acc 0.813
epoch  20  train loss 0.2612  val loss 0.5821  train acc 0.990  val acc 0.839
epoch  50  train loss 0.0258  val loss 0.4088  train acc 1.000  val acc 0.886
epoch 100  train loss 0.0055  val loss 0.4426  train acc 1.000  val acc 0.892
epoch 200  train loss 0.0012  val loss 0.4897  train acc 1.000  val acc 0.896
| 现象 | 说明 |
|---|---|
| 训练损失持续下降,验证损失先降后升 | 过拟合最典型的标志,这里验证损失在第 45 轮最低(0.385),之后一路回升到 0.490 |
| 训练准确率 100%,验证准确率停在 90% 左右 | 两者之间的差距就是过拟合的程度 |
| 验证损失回升,验证准确率却没有下降 | 模型对答错的样本越来越自信,损失变大,但答对的个数没有变 |
最后一点说明只看准确率会漏掉过拟合。训练和验证的损失都很高则是相反的问题,称为欠拟合,需要的是更大的模型或更长的训练,而不是正则化
缓解过拟合最有效的办法始终是更多的数据。数据有限时,才轮到下面这些正则化方法
权重衰减
权重衰减让每个权重在每一步都向 0 收缩一点,权重的数值越小,模型的输出随输入的变化越平缓,越不容易去拟合个别样本
L2 正则与解耦的权重衰减
实现权重衰减有两种方式。第一种是 L2 正则,在损失上加一项权重的平方和,等价于在梯度上加上$\lambda w$,之后与普通的梯度一样交给优化器处理
\[g \leftarrow \nabla L + \lambda w\]第二种是解耦的权重衰减,不经过梯度,直接把权重按比例缩小,其中$\eta$为学习率
\[w \leftarrow w - \eta \lambda w\]对 SGD 来说两者完全相同。但 Adam 会把梯度除以它的历史幅度,加在梯度里的$\lambda w$也一起被除掉了,衰减的强度不再由$\lambda$决定。torch.optim.Adam的weight_decay是第一种,torch.optim.AdamW是第二种
下面构造一个梯度恒为 0 的权重,一步之后权重的变化完全来自权重衰减
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
import torch


def one_step(optimizer_class, **kwargs):
    w = torch.nn.Parameter(torch.tensor([1.0]))
    optimizer = optimizer_class([w], **kwargs)
    (w * 0).sum().backward()  # 损失对w的梯度为0,权重的变化完全来自权重衰减
    optimizer.step()
    return round(w.item(), 4)


print(one_step(torch.optim.SGD, lr=0.1, weight_decay=0.01))    # 0.999
print(one_step(torch.optim.SGD, lr=0.1, weight_decay=0.1))     # 0.99
print(one_step(torch.optim.Adam, lr=0.1, weight_decay=0.01))   # 0.9
print(one_step(torch.optim.Adam, lr=0.1, weight_decay=0.1))    # 0.9,衰减系数放大10倍,结果不变
print(one_step(torch.optim.AdamW, lr=0.1, weight_decay=0.01))  # 0.999
print(one_step(torch.optim.AdamW, lr=0.1, weight_decay=0.1))   # 0.99
| 优化器 | weight_decay的实现 | 0.01 时一步之后 | 0.1 时一步之后 |
|---|---|---|---|
SGD | L2 正则 | 0.999 | 0.99 |
Adam | L2 正则 | 0.9 | 0.9 |
AdamW | 解耦的权重衰减 | 0.999 | 0.99 |
Adam的权重直接减少了一个学习率 0.1,而且把衰减系数放大 10 倍结果也不变:梯度被归一化之后,$\lambda$的大小被抵消了AdamW的结果正好是$1 - \eta\lambda$,衰减的强度与$\lambda$成正比- 使用 Adam 系列的优化器并且需要权重衰减时,应当使用
AdamW。AdamW的weight_decay默认为 0.01,Adam和SGD默认为 0 - 常见的取值:
AdamW训练 Transformer 时为 0.01 到 0.1,SGD训练卷积网络时为 1e-4 到 5e-4。两者的数值不能互相照搬
不对偏置和归一化参数衰减
权重衰减针对的是卷积和全连接层的权重。偏置以及归一化层的缩放、偏移参数数量很少,对过拟合几乎没有贡献,把缩放参数往 0 拉反而会妨碍归一化层正常工作,因此通常不对它们做衰减
做法是把参数分成两组交给优化器,一组设置权重衰减,另一组设为 0。偏置和归一化层的参数都是一维的,卷积和全连接的权重至少二维,按维度就可以区分。完整的写法见PyTorch Training中的参数组一节
Dropout
Dropout在训练时随机把一部分值置零,每一步实际参与计算的都是一个不同的子网络,迫使模型不依赖某几个特定的神经元
训练与推理
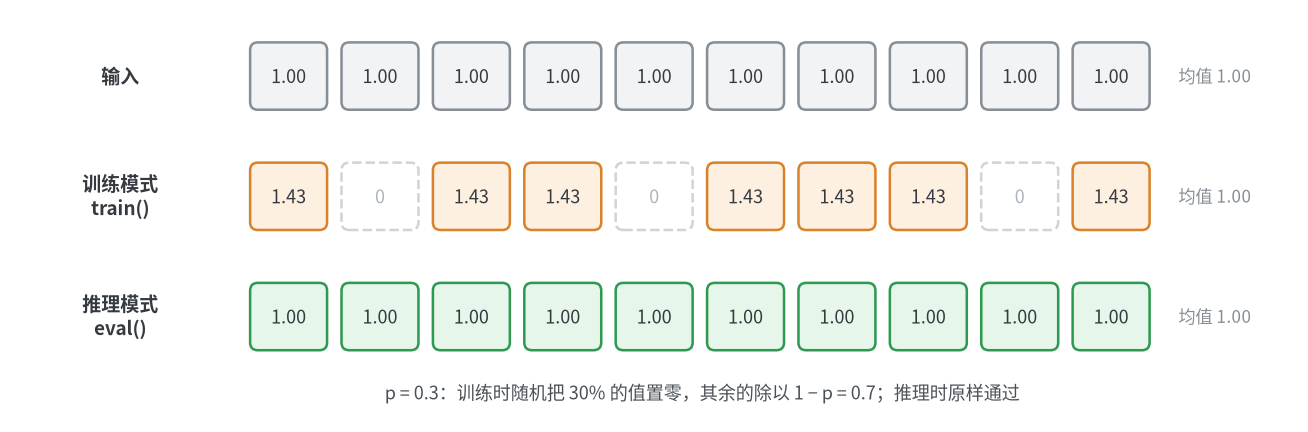
训练时每个值以概率$p$被置零,保留下来的值除以$1 - p$,使输出的均值与输入相同。这样推理时不需要做任何处理,Dropout相当于不存在
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
import torch
from torch import nn

torch.manual_seed(0)
dropout = nn.Dropout(p=0.3)
x = torch.ones(10000)

dropout.train()
y = dropout(x)
print(round((y == 0).float().mean().item(), 4))  # 0.3028,被置零的比例
print(round(y.max().item(), 4))                  # 1.4286,保留下来的值被放大为1 / (1 - 0.3)
print(round(y.mean().item(), 4))                 # 0.996,均值仍然约为1

dropout.eval()
print(torch.equal(dropout(x), x))                # True,推理时原样输出

# Dropout2d按通道丢弃,一个通道要么整个保留,要么整个置零
y = nn.Dropout2d(p=0.5)(torch.ones(1, 6, 2, 2))
print(y.sum(dim=(2, 3)))  # tensor([[8., 8., 0., 8., 8., 8.]])

# 均值不变,但方差在训练时变为原来的1 / (1 - p)倍
x = torch.randn(100000)
print(round(x.var().item(), 4), round(nn.Dropout(p=0.5)(x).var().item(), 4))  # 0.9988 1.9997
除了nn.Dropout模块,还有函数形式的F.dropout。模块会跟随model.train()和model.eval()自动切换,函数不会
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import torch
from torch import nn
import torch.nn.functional as F


class Wrong(nn.Module):
    def forward(self, x):
        return F.dropout(x, p=0.5)  # training参数默认为True,与模型处于什么模式无关


class Right(nn.Module):
    def forward(self, x):
        return F.dropout(x, p=0.5, training=self.training)


torch.manual_seed(0)
x = torch.ones(8)
print(Wrong().eval()(x))  # tensor([0., 0., 2., 0., 0., 0., 2., 2.]),eval()之后仍然在丢弃
print(Right().eval()(x))  # tensor([1., 1., 1., 1., 1., 1., 1., 1.])
放置的位置
| 位置 | 做法 |
|---|---|
| 全连接分类头 | 放在最后一个全连接层之前,$p$常用 0.5 |
| Transformer | 放在注意力和前馈网络的输出上以及嵌入之后,$p$常用 0.1 |
| 卷积层之间 | 已经有BatchNorm时一般不加;要加时用按通道丢弃的nn.Dropout2d |
与BatchNorm同时使用 | 放在BatchNorm之后,不要放在它之前 |
最后一条的原因在上面的输出中:Dropout保持了均值,但训练时的方差是推理时的$1 / (1 - p)$倍。如果后面紧跟BatchNorm,它在训练时记录下来的运行方差偏大,推理时Dropout关闭,输入的实际方差与运行方差对不上
数据量充足时Dropout的作用有限,大规模预训练的模型常常把它设为 0
其他正则化方法
标签平滑
交叉熵损失的目标是让正确类别的概率为 1,这只有在正确类别的得分比其他类别大无穷多时才能达到,模型会被推着不断拉大得分的差距。标签平滑把目标从独热向量改为:正确类别$1 - \epsilon$,再把$\epsilon$平均分给所有类别
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import torch
from torch import nn
import torch.nn.functional as F

logits = torch.tensor([[4.0, 1.0, 0.0, -1.0]])
label = torch.tensor([0])

print(round(nn.CrossEntropyLoss()(logits, label).item(), 4))
print(round(nn.CrossEntropyLoss(label_smoothing=0.1)(logits, label).item(), 4))

# 手动计算:目标分布为 (1 - 0.1) × 独热 + 0.1 / 类别数
target = F.one_hot(label, 4) * 0.9 + 0.1 / 4
print(target)  # tensor([[0.9250, 0.0250, 0.0250, 0.0250]])
print(round(-(target * F.log_softmax(logits, dim=1)).sum().item(), 4))

# 得分越悬殊,普通的交叉熵越接近0,带标签平滑的反而变大
confident = torch.tensor([[20.0, 0.0, 0.0, 0.0]])
print(round(nn.CrossEntropyLoss()(confident, label).item(), 4))
print(round(nn.CrossEntropyLoss(label_smoothing=0.1)(confident, label).item(), 4))
1
2
3
4
5
6
0.0722
0.3722
tensor([[0.9250, 0.0250, 0.0250, 0.0250]])
0.3722
0.0
1.5
- 手动用平滑后的目标分布计算的结果与
label_smoothing=0.1一致 - 最后两行是得分非常悬殊的情况:普通的交叉熵已经是 0,带标签平滑的反而升到了 1.5,过度自信的预测会受到惩罚
- 使用标签平滑后训练损失不会降到 0,不同设置之间的损失数值不能直接比较。验证时一般仍用不带平滑的交叉熵
- $\epsilon$常用 0.1
Mixup 与 CutMix
数据增强通过随机变换人为增加训练数据的多样性,是图像任务中最有效的正则化手段之一。Mixup 和 CutMix 是其中把两个样本混合起来的方法,标签也按相同的比例混合
| 方法 | 图像 | 标签 |
|---|---|---|
| Mixup | 两张图像按比例逐像素相加 | 按相同的比例混合 |
| CutMix | 从一张图像上剪下一个矩形贴到另一张图像上 | 按矩形的面积比例混合 |
torchvision.transforms.v2中提供了这两种变换,作用在已经组成一批的数据上
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import torch
from torch import nn
from torchvision.transforms import v2

torch.manual_seed(0)
images = torch.rand(4, 3, 32, 32)
labels = torch.tensor([0, 1, 2, 3])

mixup = v2.MixUp(alpha=0.2, num_classes=4)
mixed_images, mixed_labels = mixup(images, labels)
print(mixed_images.shape)  # torch.Size([4, 3, 32, 32])
print(mixed_labels)        # 标签变成了(N, 类别数)的概率

cutmix = v2.CutMix(alpha=1.0, num_classes=4)
mixed_images, mixed_labels = cutmix(images, labels)
print(mixed_labels)

# 交叉熵损失可以直接接受概率形式的标签
logits = torch.randn(4, 4)
print(round(nn.CrossEntropyLoss()(logits, mixed_labels).item(), 4))  # 1.671
1
2
3
4
5
6
7
8
9
10
torch.Size([4, 3, 32, 32])
tensor([[0.8352, 0.0000, 0.0000, 0.1648],
        [0.1648, 0.8352, 0.0000, 0.0000],
        [0.0000, 0.1648, 0.8352, 0.0000],
        [0.0000, 0.0000, 0.1648, 0.8352]])
tensor([[0.8594, 0.0000, 0.0000, 0.1406],
        [0.1406, 0.8594, 0.0000, 0.0000],
        [0.0000, 0.1406, 0.8594, 0.0000],
        [0.0000, 0.0000, 0.1406, 0.8594]])
1.671
- 混合之后标签从形状为$(N)$的类别编号变成了形状为$(N, K)$的概率,$K$为类别数。
nn.CrossEntropyLoss两种形式都接受 - 这两种变换只用于训练,放在从
DataLoader取出一批数据之后、送入模型之前 - 混合后的图像没有唯一的正确类别,训练时的准确率不再有意义,只看验证集上的准确率
早停
过拟合一节的曲线中,验证损失在第 45 轮最低,之后的训练只会让它变差。早停就是在验证损失连续若干轮没有改善时停止训练,并使用验证损失最低的那一轮的参数。实现见PyTorch Training中的提前停止一节
验证损失本身有波动,容忍的轮数太少会在一次偶然的回升后过早停止。即使不提前停止训练,也应当保存验证指标最好的那一轮,而不是最后一轮
随机深度
随机深度用在带残差连接的网络中:训练时以一定的概率把整个残差分支丢弃,只保留捷径,相当于随机跳过一些层;推理时使用全部的层。它可以看作以层为单位的Dropout,在较深的 Transformer 和卷积网络中很常用,也叫 DropPath
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
import torch
from torch import nn
from torchvision.ops import StochasticDepth

torch.manual_seed(0)
drop_path = StochasticDepth(p=0.5, mode='row')  # row:每个样本独立决定是否丢弃
x = torch.ones(8, 2)

drop_path.train()
print(drop_path(x)[:, 0])  # 被丢弃的样本整个为0,保留的放大为1 / (1 - 0.5)

drop_path.eval()
print(drop_path(x)[:, 0])  # 推理时不丢弃


class Block(nn.Module):
    def __init__(self, dim, drop_prob):
        super().__init__()
        self.body = nn.Sequential(nn.LayerNorm(dim), nn.Linear(dim, dim), nn.GELU())
        self.drop_path = StochasticDepth(drop_prob, mode='row')

    def forward(self, x):
        return x + self.drop_path(self.body(x))  # 只丢弃残差分支,捷径始终保留


print(Block(16, 0.1)(torch.randn(4, 16)).shape)  # torch.Size([4, 16])
丢弃概率通常随深度线性增大,第一层为 0,最后一层为 0.1 到 0.3
效果对比
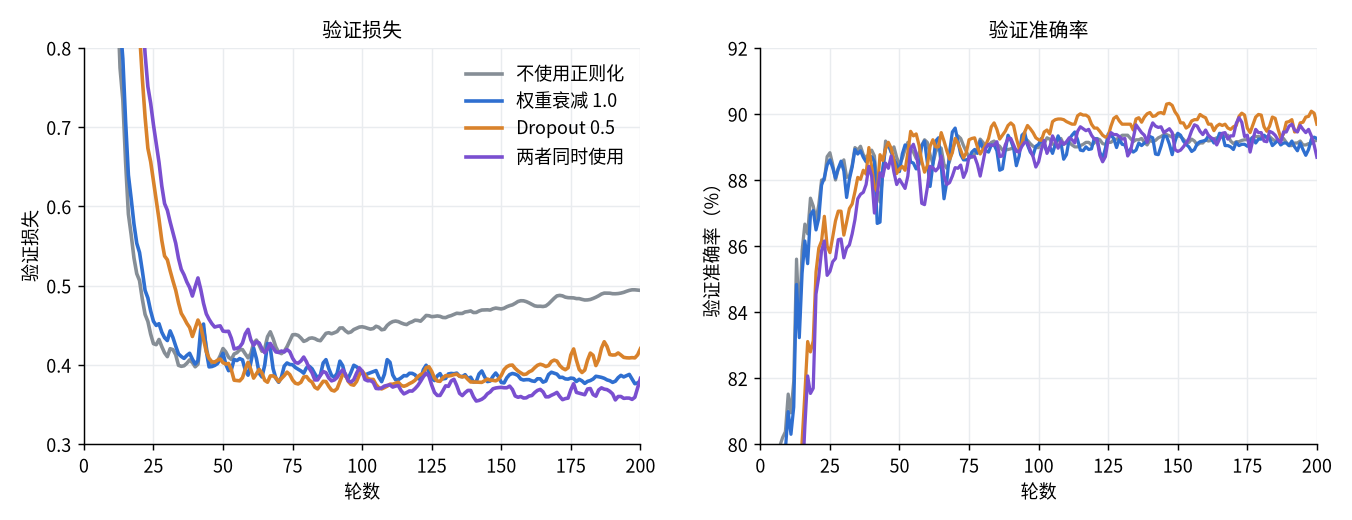
回到过拟合一节的实验,沿用其中的train函数(以下代码接在那段代码之后),比较不使用正则化、只用权重衰减、只用Dropout、两者同时使用四种设置。每种设置用 3 个随机种子训练,取平均
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
configs = {
    '不使用正则化': dict(),
    '权重衰减': dict(weight_decay=1.0),
    'Dropout': dict(dropout=0.5),
    '两者同时使用': dict(weight_decay=1.0, dropout=0.5),
}

results = {}
for name, kwargs in configs.items():
    runs = torch.tensor([train(seed=seed, **kwargs) for seed in range(3)])  # (随机种子, 轮数, 4)
    mean = runs.mean(dim=0)                                                 # 对3个随机种子取平均
    results[name] = mean
    best = mean[:, 1].argmin().item()
    print(f"{name}: train loss {mean[-1, 0]:.4f}  val loss {mean[-1, 1]:.4f}  val acc {mean[-1, 3]:.3f}  "
          f"最低 val loss {mean[best, 1]:.4f}(第 {best + 1} 轮)")
1
2
3
4
不使用正则化: train loss 0.0010  val loss 0.4940  val acc 0.892  最低 val loss 0.3976(第 40 轮)
权重衰减: train loss 0.0115  val loss 0.3799  val acc 0.893  最低 val loss 0.3763(第 198 轮)
Dropout: train loss 0.0018  val loss 0.4204  val acc 0.897  最低 val loss 0.3671(第 90 轮)
两者同时使用: train loss 0.0275  val loss 0.3830  val acc 0.887  最低 val loss 0.3544(第 141 轮)
| 设置 | 最终训练损失 | 最终验证损失 | 最低验证损失 | 最终验证准确率 |
|---|---|---|---|---|
| 不使用正则化 | 0.0010 | 0.4940 | 0.3976(第 40 轮) | 89.2% |
| 权重衰减 1.0 | 0.0115 | 0.3799 | 0.3763(第 198 轮) | 89.3% |
| Dropout 0.5 | 0.0018 | 0.4204 | 0.3671(第 90 轮) | 89.7% |
| 两者同时使用 | 0.0275 | 0.3830 | 0.3544(第 141 轮) | 88.7% |
- 正则化明显改善了验证损失。不使用正则化时验证损失从第 40 轮起一路回升,加上权重衰减之后基本不再回升,最终从 0.494 降到 0.380
- 验证准确率几乎没有变化。四种设置都在 89% 上下,相互之间的差距(最多 1 个百分点)与同一种设置下不同随机种子之间的差距相当,不能说明哪一种更好。正则化在这里让模型的预测不再那么过度自信,但没有让它答对更多的样本
- 只有 100 个训练样本时,能学到的信息本身就是有限的,正则化无法代替数据
Dropout推迟了过拟合,但没有消除:验证损失在第 90 轮之后仍然缓慢回升- 这里的权重衰减用了 1.0,远大于常用的 0.01 到 0.1。同样的实验把它设为 0.1 时,最终验证损失为 0.4605,与不使用正则化的 0.4940 相差不大。训练总共只有 800 步,学习率为 1e-3,较小的衰减系数来不及起作用。合适的取值与学习率和训练步数有关,需要在验证集上调整
- 所有设置的训练损失都仍然很低,说明模型的容量相对于 100 个样本依然过剩