深度学习系列:第 22 篇,共 22 篇
用 PyTorch 从搭建模型、训练、调试到部署的一组笔记。按下面的顺序阅读,后面的文章会直接引用前面讲过的内容
部署- PyTorch Deployment
- Model Compression
模型压缩是在模型训练好之后,用尽量小的精度损失换取更少的参数、更小的文件和更短的推理耗时。导出 ONNX、推理引擎和不需要重新训练的训练后量化见PyTorch Deployment,这里整理需要改动模型或者重新训练的几种做法:剪枝、知识蒸馏和量化感知训练。重新训练的部分用到的冻结、微调等写法见PyTorch Fine-Tuning
压缩方法概览
| 方法 | 减少的是什么 | 是否需要重新训练 | 对硬件和推理引擎的要求 |
|---|
| 非结构化剪枝 | 非零权重的个数,张量的形状和计算量不变 | 稀疏度高时需要微调 | 需要稀疏存储格式和支持稀疏计算的引擎 |
| 结构化剪枝 | 通道数,参数量、计算量、内存一起减少 | 需要微调 | 没有,得到的仍是普通的稠密模型 |
| 知识蒸馏 | 换成一个更小的模型,参数量、计算量、内存都减少 | 需要,学生模型从头训练 | 没有 |
| 量化 | 每个数值占用的位数,文件约为原来的四分之一 | 训练后量化不需要,量化感知训练需要 | 需要支持整数运算的引擎,速度取决于硬件 |
| 低秩分解 | 把一个大矩阵换成两个小矩阵相乘,参数量和计算量 | 通常需要微调 | 没有 |
- 这几种方法互不冲突,减少的东西也不一样:剪枝和蒸馏减少数值的个数,量化减少每个数值的位数,可以叠加使用
- 低秩分解与PyTorch Fine-Tuning中的 LoRA 用的是同一种结构,只是目的不同:LoRA 用它减少需要训练的参数,这里是用它替换已有的权重。本文不展开
- 压缩的效果必须实测。后面的实验中,把 90% 的权重置零之后,文件大小和耗时都没有任何变化
实验用的模型
后面所有的实验都在sklearn自带的 8×8 手写数字上进行。数据共 1797 张,取 600 张训练、797 张测试,另外 400 张当作没有标注的数据,只在蒸馏一节使用。模型是两层卷积加两层全连接的小网络,三个宽度由参数决定,最宽的一个同时作为剪枝的对象和蒸馏的教师
全文的代码按顺序放在同一个文件中,下面是公共部分,后面每一节的代码都接在它之后
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
| import copy
import gzip
import io
import statistics
import time
import torch
import torch.nn.functional as F
import torch.nn.utils.prune as prune
from sklearn.datasets import load_digits
from torch import nn
digits = load_digits() # 1797张8×8的手写数字
X = torch.tensor(digits.images, dtype=torch.float32).unsqueeze(1) / 16 # (1797, 1, 8, 8),取值范围[0, 1]
y = torch.tensor(digits.target)
order = torch.randperm(len(X), generator=torch.Generator().manual_seed(0))
# 600张训练,400张当作没有标注的数据(只在蒸馏一节使用),797张测试
train_idx, pool_idx, test_idx = order[:600], order[600:1000], order[1000:]
def make_cnn(c1, c2, hidden):
return nn.Sequential(
nn.Conv2d(1, c1, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), # 8×8 -> 4×4
nn.Conv2d(c1, c2, 3, padding=1), nn.ReLU(), nn.MaxPool2d(2), # 4×4 -> 2×2
nn.Flatten(), nn.Linear(c2 * 4, hidden), nn.ReLU(), nn.Linear(hidden, 10),
)
def count(model):
return sum(p.numel() for p in model.parameters())
@torch.no_grad()
def evaluate(model):
model.eval()
return (model(X[test_idx]).argmax(dim=1) == y[test_idx]).float().mean().item()
def train(model, epochs, lr=2e-3, seed=0, loss_fn=None, data=train_idx):
"""loss_fn(输出, 样本下标)为空时使用交叉熵"""
generator = torch.Generator().manual_seed(seed)
optimizer = torch.optim.Adam(model.parameters(), lr=lr)
for _ in range(epochs):
model.train()
perm = data[torch.randperm(len(data), generator=generator)]
for i in range(0, len(perm), 64):
idx = perm[i:i + 64]
out = model(X[idx])
loss = loss_fn(out, idx) if loss_fn else F.cross_entropy(out, y[idx])
optimizer.zero_grad()
loss.backward()
optimizer.step()
return model
torch.manual_seed(0)
large = train(make_cnn(64, 128, 256), epochs=40)
print(f"参数量 {count(large):,} 测试集准确率 {evaluate(large):.4f}")
|
1
| 参数量 208,394 测试集准确率 0.9724
|
- 模型里没有 BatchNorm,剪掉通道时只需要处理权重和偏置。带 BatchNorm 的模型,对应通道的
weight、bias、running_mean、running_var也要一起处理 - 测试集只有 797 张,一张图像对应 0.0013 的准确率,相差在 0.005 以内的结果不能说明谁更好
- 耗时在一台 CPU 为 Intel Core Ultra 9 285K、GPU 为 GeForce RTX 5090 D(32 GB 显存)、内存为 64 GB 的机器上只用 CPU、4 个线程测量,批大小为 256。机器上同时有其他任务,同一个模型多次测量的结果会相差百分之几十,比较时只看成倍的差别
非结构化剪枝
掩码的工作方式
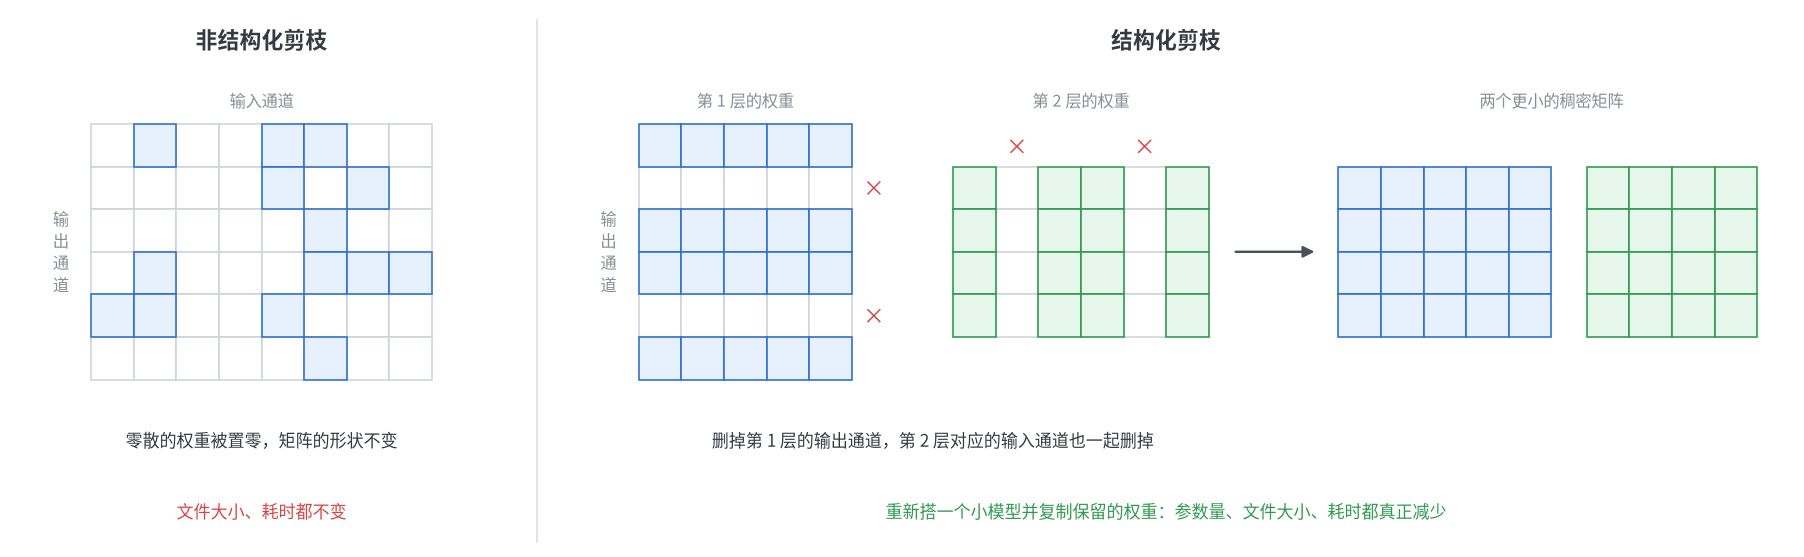
非结构化剪枝把单个权重置零,不管它在张量中的位置。torch.nn.utils.prune的做法是给参数加一个同样形状的 0/1 掩码,而不是真的删掉什么
| 函数 | 作用 |
|---|
prune.l1_unstructured(module, name, amount) | 把绝对值最小的一部分权重置零 |
prune.random_unstructured(module, name, amount) | 随机置零,一般只用作对照 |
prune.ln_structured(module, name, amount, n, dim) | 按 Ln 范数把dim这一维上最小的若干个切片整个置零 |
prune.global_unstructured(parameters, pruning_method, amount) | 把多个层的权重放在一起排序,再统一置零 |
prune.custom_from_mask(module, name, mask) | 使用自己给出的掩码 |
prune.remove(module, name) | 把掩码固化到参数中,去掉剪枝留下的附加结构 |
prune.is_pruned(module) | 模块中是否有带掩码的参数 |
amount是小数时表示比例,是整数时表示个数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
| model = copy.deepcopy(large)
conv = model[3] # Conv2d(64, 128, 3)
prune.l1_unstructured(conv, name="weight", amount=0.5) # 把绝对值最小的50%权重置零
print([name for name, _ in conv.named_parameters()]) # weight不再是参数
print([name for name, _ in conv.named_buffers()])
print(torch.equal(conv.weight, conv.weight_orig * conv.weight_mask))
print(f"{(conv.weight == 0).float().mean().item():.3f}")
print(prune.is_pruned(conv), type(next(iter(conv._forward_pre_hooks.values()))).__name__)
prune.random_unstructured(conv, name="weight", amount=0.2) # 再次剪枝:在剩下的权重中再去掉20%
print(f"{(conv.weight == 0).float().mean().item():.3f}")
prune.remove(conv, "weight") # 把掩码固化到weight中,去掉weight_orig和weight_mask
print([name for name, _ in conv.named_parameters()], [name for name, _ in conv.named_buffers()])
print(f"{(conv.weight == 0).float().mean().item():.3f}", prune.is_pruned(conv))
|
1
2
3
4
5
6
7
8
| ['bias', 'weight_orig']
['weight_mask']
True
0.500
True L1Unstructured
0.600
['bias', 'weight'] []
0.600 False
|
| 名字 | 类型 | 含义 |
|---|
weight_orig | 参数 | 原来的权重,没有被改动,优化器更新的是它 |
weight_mask | 缓冲区 | 0/1 掩码,1 表示保留 |
weight | 普通属性 | 每次前向传播之前由钩子重新计算为weight_orig * weight_mask |
- 被剪掉的权重在
weight_orig中仍然保留着原来的值,掩码让它不参与计算,梯度也是 0,所以微调时不会长回来 - 对同一个参数再次剪枝时,
amount是相对于还没有被剪掉的部分:先剪 50% 再剪 20%,得到的稀疏度是 0.6 而不是 0.7。反复“剪一点、微调几轮”的迭代剪枝就是这样实现的 - 剪枝之后
state_dict中的名字变成了weight_orig和weight_mask,没有剪枝过的模型无法直接加载。保存之前先调用prune.remove,名字恢复为weight,为零的权重保持为零 prune.remove之后掩码就不存在了,继续训练会让为零的权重重新变成非零值。微调要在prune.remove之前完成
全局剪枝与实际效果
逐层用相同的比例剪枝并不合理,各层的冗余程度不同。global_unstructured把所有层的权重放在一起比较,绝对值最小的 90% 无论在哪一层都被置零
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
| def prunable(model):
return [(m, "weight") for m in model if isinstance(m, (nn.Conv2d, nn.Linear))]
def file_size(model, compress=False):
"""state_dict保存后的大小(KB),compress=True时再用gzip压缩"""
buffer = io.BytesIO()
torch.save(model.state_dict(), buffer)
data = gzip.compress(buffer.getvalue()) if compress else buffer.getvalue()
return len(data) / 1024
@torch.no_grad()
def latency(model, batch=256, repeat=100):
"""一个批次的前向传播耗时(毫秒),取中位数"""
model.eval()
x = X[test_idx][:batch]
times = []
for i in range(repeat + 10):
start = time.perf_counter()
model(x)
times.append(time.perf_counter() - start)
return statistics.median(times[10:]) * 1000 # 前10次是预热
def report(name, model):
zeros = sum((m.weight == 0).sum().item() for m, _ in prunable(model))
print(f"准确率 {evaluate(model):.4f} 为零的权重 {zeros:>7,} 文件 {file_size(model):6.1f} KB"
f" 压缩后 {file_size(model, True):5.1f} KB 耗时 {latency(model):.2f} ms {name}")
model = copy.deepcopy(large)
report("原模型", model)
prune.global_unstructured(prunable(model), pruning_method=prune.L1Unstructured, amount=0.9)
report("全局剪掉90%", model)
for m, _ in prunable(model):
print(f" {type(m).__name__:6s} {str(tuple(m.weight.shape)):16s} 稀疏度 {(m.weight == 0).float().mean().item():.3f}")
train(model, epochs=10, lr=1e-3) # 微调:掩码保持不变,只更新没有被剪掉的权重
report("微调10轮", model)
for m, name in prunable(model):
prune.remove(m, name)
report("prune.remove之后", model)
|
1
2
3
4
5
6
7
8
| 准确率 0.9724 为零的权重 0 文件 817.1 KB 压缩后 756.6 KB 耗时 2.43 ms 原模型
准确率 0.7980 为零的权重 187,142 文件 1630.3 KB 压缩后 779.6 KB 耗时 2.47 ms 全局剪掉90%
Conv2d (64, 1, 3, 3) 稀疏度 0.149
Conv2d (128, 64, 3, 3) 稀疏度 0.829
Linear (256, 512) 稀疏度 0.945
Linear (10, 256) 稀疏度 0.807
准确率 0.9749 为零的权重 187,142 文件 1630.3 KB 压缩后 780.8 KB 耗时 2.50 ms 微调10轮
准确率 0.9749 为零的权重 187,142 文件 817.1 KB 压缩后 143.1 KB 耗时 2.44 ms prune.remove之后
|
- 全局剪枝后各层的稀疏度相差很大:最大的全连接层被剪掉 94.5%,只有 576 个权重的第一层卷积只被剪掉 14.9%
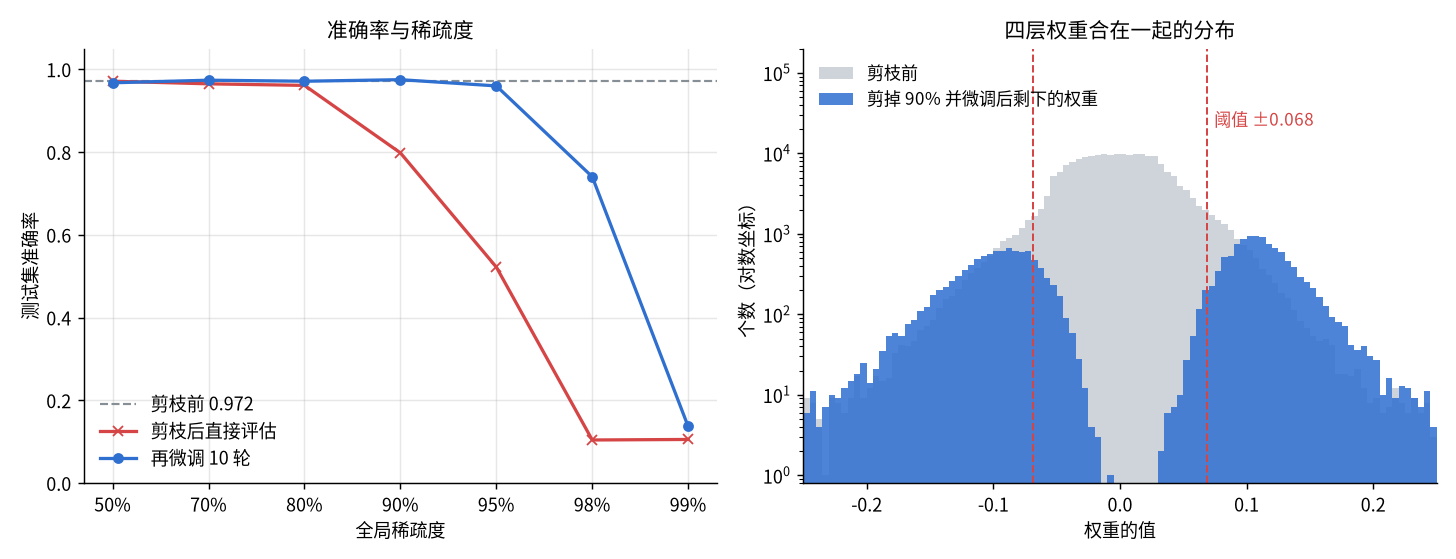
- 剪枝后直接评估,准确率从 0.9724 降到 0.7980,微调 10 轮后回到 0.9749。微调时掩码不变,只有保留下来的 10% 权重在更新
- 把 90% 的权重置零之后,文件大小和耗时都没有变。 为零的权重仍然按 32 位浮点数保存,卷积和矩阵乘法也照样把它们算一遍。耗时一栏四行之间的差别都在测量的波动范围内
- 带着掩码保存时文件反而大了一倍(1630.3 KB),因为
weight_orig和weight_mask各存了一份 - 稀疏真正能带来的好处在别处:文件用 gzip 压缩后从 756.6 KB 降到 143.1 KB,适合用于下载和分发;要减少内存和耗时,则需要用稀疏格式保存权重(如
tensor.to_sparse_csr()),并且推理引擎或硬件对稀疏计算有专门的支持
稀疏度与准确率
1
2
3
4
5
6
7
8
9
| sparsity_curve = []
for amount in [0.5, 0.7, 0.8, 0.9, 0.95, 0.98, 0.99]:
model = copy.deepcopy(large)
prune.global_unstructured(prunable(model), pruning_method=prune.L1Unstructured, amount=amount)
before = evaluate(model)
after = evaluate(train(model, epochs=10, lr=1e-3))
emptiest = max((m.weight == 0).float().mean().item() for m, _ in prunable(model))
sparsity_curve.append((amount, before, after))
print(f"稀疏度 {amount:.2f} 剪枝后 {before:.4f} 微调后 {after:.4f} 最稀疏的一层 {emptiest:.4f}")
|
1
2
3
4
5
6
7
| 稀疏度 0.50 剪枝后 0.9711 微调后 0.9674 最稀疏的一层 0.5409
稀疏度 0.70 剪枝后 0.9649 微调后 0.9737 最稀疏的一层 0.7569
稀疏度 0.80 剪枝后 0.9611 微调后 0.9711 最稀疏的一层 0.8590
稀疏度 0.90 剪枝后 0.7980 微调后 0.9749 最稀疏的一层 0.9451
稀疏度 0.95 剪枝后 0.5220 微调后 0.9598 最稀疏的一层 0.9777
稀疏度 0.98 剪枝后 0.1041 微调后 0.7403 最稀疏的一层 0.9942
稀疏度 0.99 剪枝后 0.1054 微调后 0.1368 最稀疏的一层 0.9983
|
- 稀疏度不超过 80% 时,不微调准确率也只下降约 0.01,说明这个模型对于手写数字来说有大量冗余
- 微调之后 90% 稀疏度的准确率与剪枝前没有区别,95% 时下降约 0.013,98% 时降到 0.74
- 99% 时微调也无法恢复。此时最大的全连接层只剩下 0.17% 的权重,信息在这一层几乎被截断。全局剪枝在稀疏度很高时可能把某一层剪空,需要留意每一层各自的稀疏度
- 右图中灰色是剪枝前的分布,绝对值小于阈值 0.068 的权重全部被剪掉;蓝色是微调后保留下来的权重,它们在微调中有所变化,一部分移到了阈值以内
- 按绝对值剪枝的依据是“绝对值小的权重对输出的影响小”,这只是一个近似,但它不需要数据、计算量可以忽略,通常是首选
结构化剪枝
结构化剪枝以整个输出通道(全连接层中是整个神经元)为单位。prune.ln_structured同样只是加掩码,把被选中的通道整个置零,模型并没有变小。要得到真正的收益,需要按掩码重新搭一个更窄的模型,再把保留下来的权重复制过去
| 层 | 权重的形状 | 复制时怎样取 |
|---|
| 被剪枝的层 | (输出通道, 输入通道, …) | 第 0 维只取本层保留的通道 |
| 它的下一层 | (输出通道, 输入通道, …) | 第 1 维只取上一层保留的通道 |
| 展平之后的全连接层 | (输出, 通道 × 高 × 宽) | 先还原出通道这一维,再按上一层保留的通道取 |
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
| def kept(layer):
"""结构化剪枝之后保留下来的输出通道(或神经元)的下标"""
return layer.weight_mask.flatten(1).any(dim=1).nonzero().flatten()
def slim(model, amount):
"""对两个卷积层和第一个全连接层按L1范数剪掉amount比例的输出通道,返回带掩码的模型和真正变小的模型"""
masked = copy.deepcopy(model)
for i in (0, 3, 7):
prune.ln_structured(masked[i], name="weight", amount=amount, n=1, dim=0) # dim=0是输出通道
mask = torch.zeros_like(masked[i].bias)
mask[kept(masked[i])] = 1
prune.custom_from_mask(masked[i], name="bias", mask=mask) # 被剪掉的通道的偏置也要置零
k1, k2, k3 = kept(masked[0]), kept(masked[3]), kept(masked[7])
small = make_cnn(len(k1), len(k2), len(k3))
with torch.no_grad():
small[0].weight.copy_(masked[0].weight[k1])
small[3].weight.copy_(masked[3].weight[k2][:, k1]) # 输出通道按本层保留的取,输入通道按上一层保留的取
# 展平之后每个通道占2×2=4列,先还原出通道这一维再取
small[7].weight.copy_(masked[7].weight[k3].view(len(k3), -1, 4)[:, k2].flatten(1))
small[9].weight.copy_(masked[9].weight[:, k3])
for i, k in ((0, k1), (3, k2), (7, k3), (9, slice(None))):
small[i].bias.copy_(masked[i].bias[k])
return masked, small
for amount in [0.25, 0.5, 0.75]:
masked, small = slim(large, amount)
with torch.no_grad():
diff = (masked(X[test_idx]) - small(X[test_idx])).abs().max().item()
shape = (small[0].out_channels, small[3].out_channels, small[7].out_features)
pruned = evaluate(small)
tuned = evaluate(train(small, epochs=10, lr=1e-3))
torch.manual_seed(0)
scratch = evaluate(train(make_cnn(*shape), epochs=40)) # 对照:同样的结构从头训练
print(f"剪掉 {amount:.0%} 结构 {shape} 参数量 {count(small):>7,} 输出最大相差 {diff:.1e} 剪枝后 {pruned:.4f}"
f" 微调后 {tuned:.4f} 从头训练 {scratch:.4f} 文件 {file_size(small):5.1f} KB 耗时 {latency(small):.2f} ms")
|
1
2
3
| 剪掉 25% 结构 (48, 96, 192) 参数量 117,898 输出最大相差 5.7e-06 剪枝后 0.9737 微调后 0.9774 从头训练 0.9737 文件 463.6 KB 耗时 1.68 ms
剪掉 50% 结构 (32, 64, 128) 参数量 53,002 输出最大相差 3.8e-06 剪枝后 0.9711 微调后 0.9649 从头训练 0.9749 文件 210.1 KB 耗时 1.00 ms
剪掉 75% 结构 (16, 32, 64) 参数量 13,706 输出最大相差 9.5e-07 剪枝后 0.7566 微调后 0.9486 从头训练 0.9636 文件 56.6 KB 耗时 0.46 ms
|
- 小模型与带掩码的模型输出最大只相差 1e-6 量级,是浮点数的舍入误差,说明通道的对应关系没有弄错。这一步检查不能省,下标取错不会报错,只会让准确率莫名下降
- 偏置也要处理。
ln_structured只把权重置零,被剪掉的通道仍然会输出它的偏置,经过 ReLU 后可能是一个非零的常数。不把偏置一起置零,带掩码的模型与小模型的输出就不相同 - 每层剪掉一半通道,参数量减少到原来的四分之一(卷积层和全连接层的权重个数与输入、输出通道数的乘积成正比),文件从 817.1 KB 减小到 210.1 KB,耗时约为原来的 40%。与非结构化剪枝不同,这些收益不依赖任何特殊的存储格式或推理引擎
- 剪掉 25% 和 50% 时,不微调准确率也基本不变;剪掉 75% 时降到 0.7566,微调 10 轮后回到 0.9486
- 对照组同样重要。 同样的结构从头训练 40 轮,三种宽度的准确率分别为 0.9737、0.9749、0.9636,并不比“先训练大模型、再剪枝、再微调”差。在这个简单的任务上,剪枝得到的只是一个更窄的结构,继承的权重没有带来额外的好处;数据量大、从头训练代价高时,继承权重的价值才体现出来
- 残差结构中,相加的两路通道必须一一对应,不能各剪各的;通道之间的依赖关系复杂时,可以用
torch-pruning这样的库自动处理,这里没有验证
知识蒸馏
损失函数
知识蒸馏用一个已经训练好的大模型(教师)指导一个小模型(学生)的训练。学生除了拟合标签,还要拟合教师输出的概率分布,这个分布称为软标签,其中包含了标签里没有的信息:哪些类别容易混淆
\[L = \alpha \, T^2 \cdot \mathrm{KL}\!\left( \mathrm{softmax}(z_t / T) \,\Vert\, \mathrm{softmax}(z_s / T) \right) + (1 - \alpha) \cdot \mathrm{CE}(z_s, y)\]
| 符号 | 含义 |
|---|
| $z_t$、$z_s$ | 教师和学生输出的 logits,教师的输出不参与反向传播 |
| $T$ | 温度。logits 除以$T$之后再做 softmax,$T$越大分布越平缓,常用 2 到 8 |
| $\alpha$ | 软标签一项的权重,常用 0.5 到 0.9 |
| $y$ | 真实标签,没有标注的数据可以只用软标签一项 |
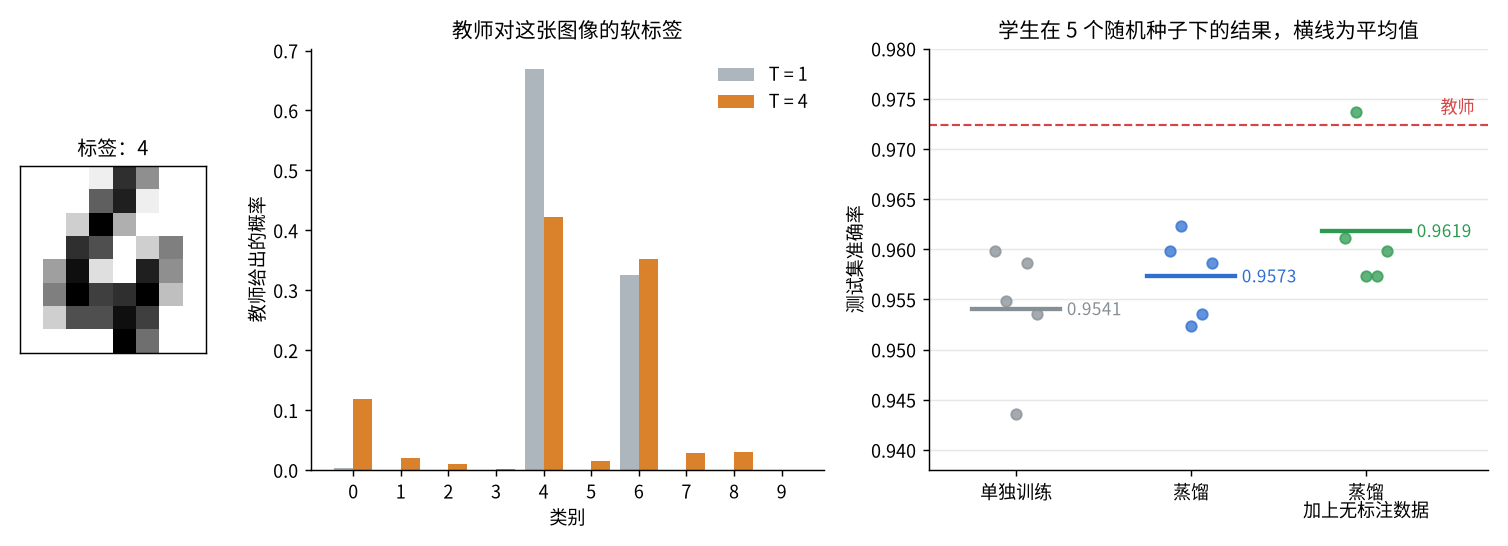
- 教师的输出往往非常自信,正确类别的概率接近 1,其余类别接近 0,与标签几乎没有区别。提高温度把其余类别之间的相对大小放大出来,见下一节图中间的柱状图
- $T^2$不能省。 软标签一项对学生 logits 的梯度大约与$1 / T^2$成正比:除以$T$本身带来一个$1 / T$,两个分布在温度升高后彼此接近,又带来一个$1 / T$。乘以$T^2$之后,改变温度不会改变两项损失的相对大小
F.kl_div的第一个参数是学生的对数概率,第二个参数是教师的概率,顺序和是否取对数都不能弄反;reduction要用"batchmean",默认的"mean"会多除以一个类别数- 推理时只使用学生,温度只在训练时出现
对比实验
教师是前面的大模型,学生的三个宽度为 8、16、32,参数量是教师的 1.8%。同一个学生分别单独训练、用教师蒸馏、蒸馏时再加上 400 张没有标注的图像,各用 5 个随机种子
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
| with torch.no_grad():
teacher_logits = large(X) # 教师的输出不变,提前算好
labeled = torch.zeros(len(X))
labeled[train_idx] = 1 # 没有标注的图像只计算软标签一项
T, ALPHA = 4.0, 0.9
def distill_loss(out, idx):
soft = F.kl_div(F.log_softmax(out / T, dim=1), F.softmax(teacher_logits[idx] / T, dim=1), reduction="batchmean")
hard = (F.cross_entropy(out, y[idx], reduction="none") * labeled[idx]).mean()
return ALPHA * T * T * soft + (1 - ALPHA) * hard
def run(seed, **kwargs):
torch.manual_seed(seed)
return train(make_cnn(8, 16, 32), seed=seed, **kwargs)
more_data = torch.cat([train_idx, pool_idx]) # 1000张图像,其中400张没有标注
students = [run(seed, epochs=150) for seed in range(5)]
distilled = [run(seed, epochs=150, loss_fn=distill_loss) for seed in range(5)]
distilled_more = [run(seed, epochs=90, loss_fn=distill_loss, data=more_data) for seed in range(5)] # 更新次数与前两组相同
print(f"教师 {count(large):,} 个参数,准确率 {evaluate(large):.4f};学生 {count(students[0]):,} 个参数")
for name, models in [("单独训练", students), ("蒸馏", distilled), ("蒸馏,加上无标注数据", distilled_more)]:
accs = [evaluate(m) for m in models]
print(f"{statistics.mean(accs):.4f} ± {statistics.stdev(accs):.4f} {[round(a, 3) for a in accs]} {name}")
|
1
2
3
4
| 教师 208,394 个参数,准确率 0.9724;学生 3,658 个参数
0.9541 ± 0.0064 [0.96, 0.955, 0.944, 0.959, 0.954] 单独训练
0.9573 ± 0.0043 [0.96, 0.962, 0.952, 0.954, 0.959] 蒸馏
0.9619 ± 0.0068 [0.961, 0.974, 0.957, 0.957, 0.96] 蒸馏,加上无标注数据
|
- 在同样的 600 张图像上,蒸馏比单独训练平均高 0.003,小于随机种子之间的标准差 0.006,不能认为蒸馏在这里有效。教师自己只有 0.9724,比学生高不到 0.02,能教的东西有限
- 加上没有标注的图像后平均为 0.9619,比单独训练高 0.008,约为一个标准差,5 个种子全部高于单独训练时的平均值。这是蒸馏更实际的用法:教师可以给任意多的无标注数据打上软标签,学生因此见到了更多的输入
- 只看一个随机种子会得出任意的结论:种子 1 时蒸馏高 0.007,种子 3 时蒸馏反而低 0.005。比较训练方法至少要重复几次,报告平均值和波动
- 温度取 1、2 时(加上无标注数据),平均值为 0.9586 和 0.9593,与$T = 4$的差别同样在波动范围内
- 蒸馏的收益随任务变难、教师与学生的差距变大而增加,手写数字这样的任务上学生单独训练已经接近教师
量化感知训练
伪量化与直通估计
量化的原理和训练后量化见PyTorch Deployment。训练后量化在位宽较低或模型较小时精度下降明显,量化感知训练在训练时就把量化的误差加进前向传播,让权重自己去适应。做法是在权重和中间结果上插入伪量化:先量化为整数,再立刻换算回浮点数,数值仍然是浮点类型,但只能取到有限的几个值
\[q = \mathrm{clamp}\!\left( \mathrm{round}(x / s) + z,\; q_{\min},\; q_{\max} \right) ,\qquad \hat{x} = (q - z) \cdot s\]
| 符号 | 含义 |
|---|
| $s$ | 步长(scale),相邻两个取值之间的距离 |
| $z$ | 零点(zero point),浮点数 0 对应的整数 |
| $q_{\min}$、$q_{\max}$ | 整数的范围,8 位有符号数为 -128 到 127,4 位无符号数为 0 到 15 |
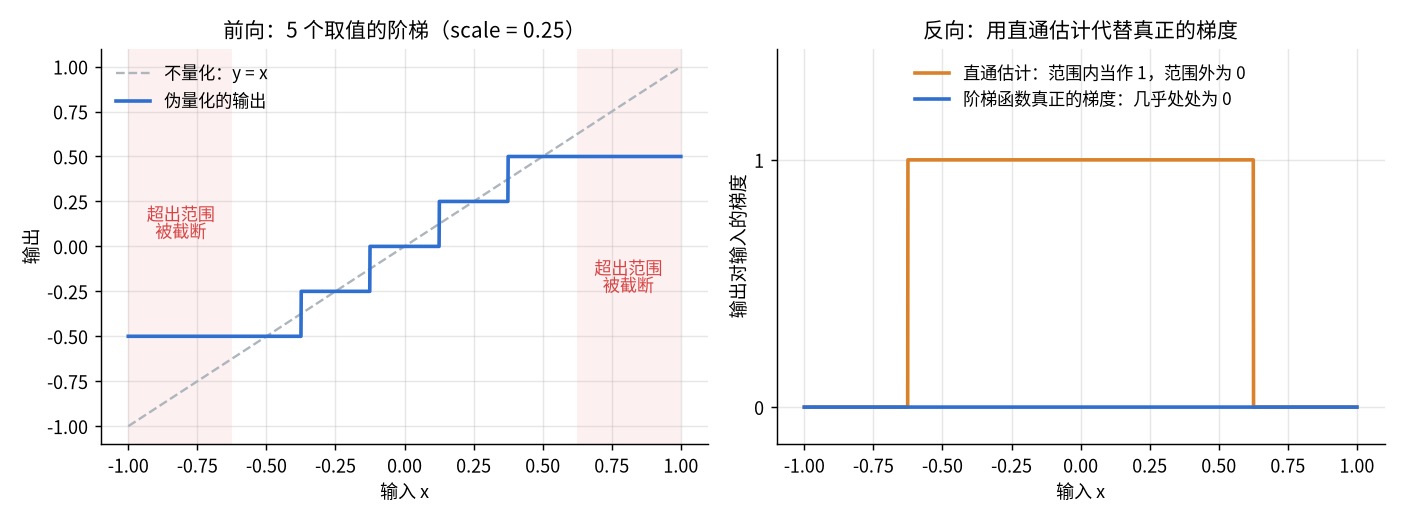
round的梯度几乎处处为 0,直接反向传播的话权重得不到任何更新。直通估计(Straight-Through Estimator)在反向传播时把伪量化当作恒等函数:范围以内梯度取 1,超出范围被截断的部分梯度取 0
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
| def fake_quant(x, scale, zero_point, qmin, qmax):
q = torch.round(x / scale) + zero_point # 量化:实数 -> 整数
inside = (q >= qmin) & (q <= qmax)
xq = (q.clamp(qmin, qmax) - zero_point) * scale # 反量化:整数 -> 实数,只能取到有限的几个值
return xq.detach() + (x - x.detach()) * inside # 前向的值是xq,反向的梯度是inside
x = torch.linspace(-1, 1, 9, requires_grad=True)
out = fake_quant(x, scale=0.25, zero_point=0, qmin=-2, qmax=2) # 5个取值:-0.5到0.5
out.sum().backward()
print(x.tolist())
print(out.tolist())
print(x.grad.tolist())
# 与PyTorch自带的函数比较:1000个随机数,4位,取值和梯度都应当完全相同
x = torch.randn(1000, requires_grad=True)
mine = torch.autograd.grad(fake_quant(x, 0.1, 3, -8, 7).sum(), x)[0]
builtin = torch.autograd.grad(torch.fake_quantize_per_tensor_affine(x, 0.1, 3, -8, 7).sum(), x)[0]
print(torch.equal(fake_quant(x, 0.1, 3, -8, 7), torch.fake_quantize_per_tensor_affine(x, 0.1, 3, -8, 7)))
print(torch.equal(mine, builtin), f"{mine.mean().item():.3f}")
print(torch.autograd.grad(torch.round(x / 0.1).sum(), x)[0].abs().max().item()) # round本身的梯度处处为0
|
1
2
3
4
5
6
| [-1.0, -0.75, -0.5, -0.25, 0.0, 0.25, 0.5, 0.75, 1.0]
[-0.5, -0.5, -0.5, -0.25, 0.0, 0.25, 0.5, 0.5, 0.5]
[0.0, 0.0, 1.0, 1.0, 1.0, 1.0, 1.0, 0.0, 0.0]
True
True 0.501
0.0
|
- 最后一行的
xq.detach() + (x - x.detach()) * inside是直通估计的常见写法:x - x.detach()的值为 0,梯度为 1,因此整个表达式的值等于xq,梯度等于inside - 9 个输入中,-1、-0.75 和 0.75、1 超出了 5 个取值所能表示的范围,输出被截断,梯度为 0;其余的梯度为 1
- 取值和梯度都与 PyTorch 自带的
torch.fake_quantize_per_tensor_affine完全相同。1000 个标准正态分布的随机数中,约一半落在范围之外,梯度为 0。范围取得太小,大量的值得不到梯度;取得太大,步长变大,舍入误差变大
不同位宽下的对比
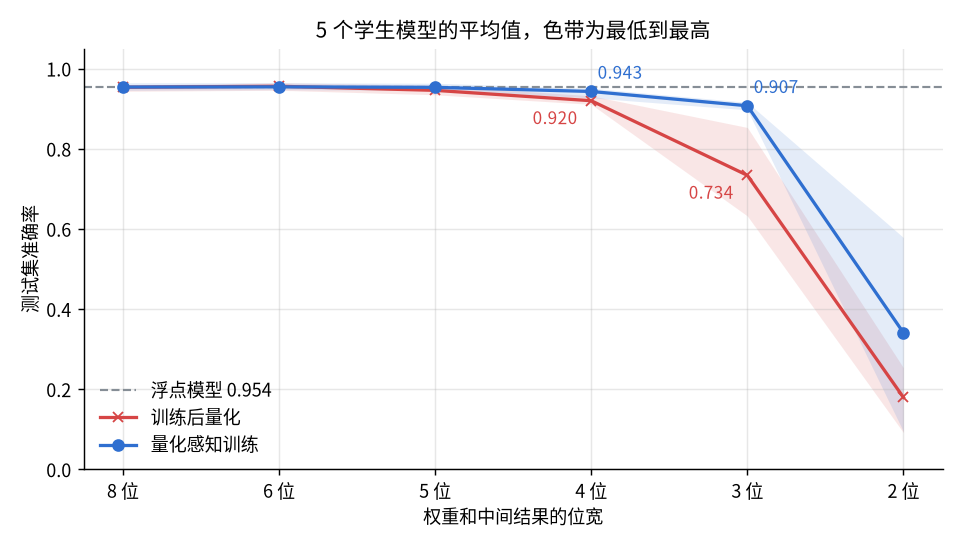
用上面的函数实现两个模块:QuantAct量化中间结果,QuantWeight量化一层的权重。把它们插入训练好的浮点模型并用训练集校准范围,直接评估就是训练后量化的结果;带着伪量化继续训练 30 轮就是量化感知训练。量化的对象是上一节单独训练的 5 个学生模型
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
| class QuantAct(nn.Module):
"""量化中间结果:ReLU之后没有负数,用[0, high]上的2^bits个取值"""
def __init__(self, bits):
super().__init__()
self.qmax = 2 ** bits - 1
self.observe = True # 校准阶段只统计范围,不量化
self.register_buffer("high", torch.tensor(0.0))
def forward(self, x):
if self.observe:
self.high = torch.maximum(self.high, x.detach().max())
return x
return fake_quant(x, self.high / self.qmax, 0, 0, self.qmax)
class QuantWeight(nn.Module):
"""量化一个卷积层或全连接层的权重:对称量化,范围取权重绝对值的最大值"""
def __init__(self, layer, bits):
super().__init__()
self.layer = layer
self.qmax = 2 ** (bits - 1) - 1
def forward(self, x):
weight = self.layer.weight
scale = weight.detach().abs().max() / self.qmax
weight = fake_quant(weight, scale, 0, -self.qmax, self.qmax)
return torch.func.functional_call(self.layer, {"weight": weight}, (x,)) # 用量化后的权重做前向传播
def quantize(model, bits):
"""插入伪量化模块,并用训练集校准中间结果的范围。返回的模型直接评估就是训练后量化的结果"""
layers = [QuantAct(bits)] # 输入也要量化
for m in copy.deepcopy(model):
if isinstance(m, (nn.Conv2d, nn.Linear)):
layers.append(QuantWeight(m, bits))
elif isinstance(m, nn.ReLU):
layers += [m, QuantAct(bits)]
else:
layers.append(m)
model = nn.Sequential(*layers)
with torch.no_grad():
model(X[train_idx]) # 校准
for m in model:
if isinstance(m, QuantAct):
m.observe = False
return model
def mean(values):
return f"{statistics.mean(values):.4f}"
print("浮点", mean([evaluate(m) for m in students]),
" 浮点再训练30轮", mean([evaluate(train(copy.deepcopy(m), 30, lr=1e-3, seed=s)) for s, m in enumerate(students)]))
bit_curve = []
for bits in [8, 6, 5, 4, 3, 2]:
ptq = [quantize(m, bits) for m in students]
ptq_acc = [evaluate(m) for m in ptq]
qat_acc = [evaluate(train(m, 30, lr=1e-3, seed=s)) for s, m in enumerate(ptq)] # 量化感知训练:带着伪量化再训练30轮
bit_curve.append((bits, ptq_acc, qat_acc))
print(f"{bits} 位 训练后量化 {mean(ptq_acc)} (最低 {min(ptq_acc):.3f}) 量化感知训练 {mean(qat_acc)} (最低 {min(qat_acc):.3f})")
|
1
2
3
4
5
6
7
| 浮点 0.9541 浮点再训练30轮 0.9553
8 位 训练后量化 0.9536 (最低 0.944) 量化感知训练 0.9541 (最低 0.946)
6 位 训练后量化 0.9561 (最低 0.946) 量化感知训练 0.9546 (最低 0.947)
5 位 训练后量化 0.9458 (最低 0.935) 量化感知训练 0.9533 (最低 0.946)
4 位 训练后量化 0.9199 (最低 0.911) 量化感知训练 0.9430 (最低 0.927)
3 位 训练后量化 0.7338 (最低 0.632) 量化感知训练 0.9074 (最低 0.897)
2 位 训练后量化 0.1794 (最低 0.092) 量化感知训练 0.3408 (最低 0.094)
|
- 8 位时两者没有区别,都与浮点模型相同(0.954)。常规的 8 位量化先用训练后量化,精度够用就不需要量化感知训练
- 差别从 5 位开始出现(0.946 和 0.953),4 位时训练后量化为 0.920、量化感知训练为 0.943,3 位时为 0.734 和 0.907。位宽越低,量化感知训练的优势越大
- 2 位时只剩下 3 到 4 个取值,量化感知训练也只有 0.341,这个结构在这样的位宽下已经无法工作
- 浮点模型同样再训练 30 轮只从 0.9541 变为 0.9553,所以低位宽下的提升来自对量化误差的适应,而不是多训练了 30 轮
- 这里的实现做了简化:权重整层共用一个步长,中间结果的范围在校准后固定不变,偏置和最后输出的 logits 没有量化。实际的工具通常对权重逐通道量化,并在训练过程中用滑动平均更新范围
- 伪量化只是模拟,模型仍然用浮点数计算,既不会变小也不会变快。训练完成后要把权重真正转换成整数,并交给支持整数运算的推理引擎
PyTorch 自带的流程
torch.ao.quantization中有一套现成的流程:prepare_qat插入伪量化模块,训练之后用convert把模型换成真正的整数运算
1
2
3
4
5
6
7
8
9
10
| tq = torch.ao.quantization
model = nn.Sequential(tq.QuantStub(), copy.deepcopy(students[0]), tq.DeQuantStub()) # 标出浮点与整数的边界
model.qconfig = tq.get_default_qat_qconfig("x86")
model = tq.prepare_qat(model.train()) # 插入伪量化模块
print(type(model[1][0]).__name__, type(model[1][0].weight_fake_quant).__name__)
train(model, 30, lr=1e-3)
converted = tq.convert(model.eval()) # 换成真正的整数运算
print(converted[1][0])
print(converted[1][0].weight().dtype, converted[1][0].weight().int_repr().flatten()[:6].tolist())
print(f"浮点 {evaluate(students[0]):.4f} {file_size(students[0]):.1f} KB 量化 {evaluate(converted):.4f} {file_size(converted):.1f} KB")
|
1
2
3
4
| Conv2d FusedMovingAvgObsFakeQuantize
QuantizedConv2d(1, 8, kernel_size=(3, 3), stride=(1, 1), scale=0.05232612043619156, zero_point=50, padding=(1, 1))
torch.qint8 [53, 88, -128, -75, 65, 46]
浮点 0.9598 17.4 KB 量化 0.9586 12.8 KB
|
- 转换后的权重是 8 位整数,准确率 0.9586,与浮点模型的 0.9598 只相差一张图像
- 文件只从 17.4 KB 减小到 12.8 KB:这个模型只有 3,658 个参数,文件中大部分是与参数量无关的固定开销。模型越大,越接近四分之一
torch.ao.quantization在调用时给出弃用警告,提示迁移到单独的torchao库;基于导出图的quantize_pt2e流程在本文使用的版本中已经无法导入。这套接口仍然可以运行,但新项目不宜依赖它,torchao的接口这里没有验证- 转换后的模型只能在 CPU 上运行。要部署到其他推理引擎,量化一般交给该引擎自己的工具完成,如PyTorch Deployment中 ONNX Runtime 的量化
组合与选择
本文实验的结果
| 做法 | 参数量 | 测试集准确率 | 文件大小 | 耗时变化 |
|---|
| 原模型 | 208,394 | 0.9724 | 817.1 KB | 基准 |
| 非结构化剪枝 90%,微调 | 208,394 | 0.9749 | 817.1 KB,gzip 后 143.1 KB | 不变 |
| 结构化剪枝 50%,微调 | 53,002 | 0.9649 | 210.1 KB | 约为原来的 40% |
| 结构化剪枝 75%,微调 | 13,706 | 0.9486 | 56.6 KB | 约为原来的 20% |
| 小模型单独训练,5 次平均 | 3,658 | 0.9541 | 17.4 KB | 没有测量 |
| 小模型蒸馏并加上无标注数据 | 3,658 | 0.9619 | 17.4 KB | 没有测量 |
| 小模型 4 位训练后量化 | 3,658 | 0.9199 | 伪量化,没有测量 | 没有测量 |
| 小模型 4 位量化感知训练 | 3,658 | 0.9430 | 伪量化,没有测量 | 没有测量 |
在这个任务上,单独训练的小模型参数量只有“结构化剪枝 75%”的四分之一左右,准确率却不比它低。这是任务简单造成的,不能推广,但说明了压缩之前要先确认一件事:直接换一个更小的结构是否已经够用
组合的顺序
几种方法一起使用时,通常按“先改结构,后改数值”的顺序
| 顺序 | 步骤 | 说明 |
|---|
| 1 | 确定小模型的结构 | 直接设计一个小模型,或者对大模型做结构化剪枝 |
| 2 | 训练或微调 | 有大模型时用它作为教师蒸馏,尤其是有大量无标注数据时 |
| 3 | 量化 | 先试训练后量化,精度不够再做量化感知训练 |
| 4 | 导出并在目标设备上测量 | 文件大小、耗时、精度都以目标设备上的实测为准 |
量化放在最后,是因为剪枝和蒸馏都会改变权重的分布,之前统计的量化范围会失效
先试哪一种
| 目标或条件 | 先试 | 原因 |
|---|
| 减小文件、在 CPU 或嵌入式设备上加速 | 8 位训练后量化 | 不需要训练,精度损失通常很小 |
| 8 位量化后精度下降明显,或需要更低的位宽 | 量化感知训练 | 位宽越低,相对训练后量化的优势越大 |
| 减少计算量,目标设备只支持稠密计算 | 更小的结构,或结构化剪枝后微调 | 得到的是普通模型,任何设备上都有收益 |
| 有一个效果好的大模型,要训练小模型 | 知识蒸馏 | 可以利用无标注数据,训练代价只比单独训练多一次教师前向 |
| 只想减小下载和存储的体积 | 非结构化剪枝后压缩,或量化 | 稀疏的权重压缩率高,不要求推理引擎支持 |
| 推理引擎或硬件支持稀疏计算 | 非结构化剪枝 | 同样的精度下能达到比结构化剪枝更高的稀疏度 |
| GPU 上加速 | 半精度或 TensorRT | 见PyTorch Deployment |
最后两行和“组合的顺序”一节是通用的经验,没有在这里的实验中验证